介绍
商店现在按月保存销售数据。September 已登记,October 新文件在本地。将它上传到月度 S3 前缀,登记 Glue 分区,用 Athena 查询新月份和两月数据。
先完成 Query S3 Data with Athena。本独立环境提供分区表 sales、September 数据及已登记分区、本地新 CSV 和已配置的 AWS 身份,无需个人账户或前一 VM 资源。通过 Terminal 使用普通 S3、Glue、Athena 命令,通过 AWS View 比较文件、分区位置和实际查询结果。
认证考点
| 认证 | 考试任务 | 实践内容 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | 解释 Glue 目录元数据如何让 Athena 分析按分区存储的 S3 数据。 |
添加新月份文件
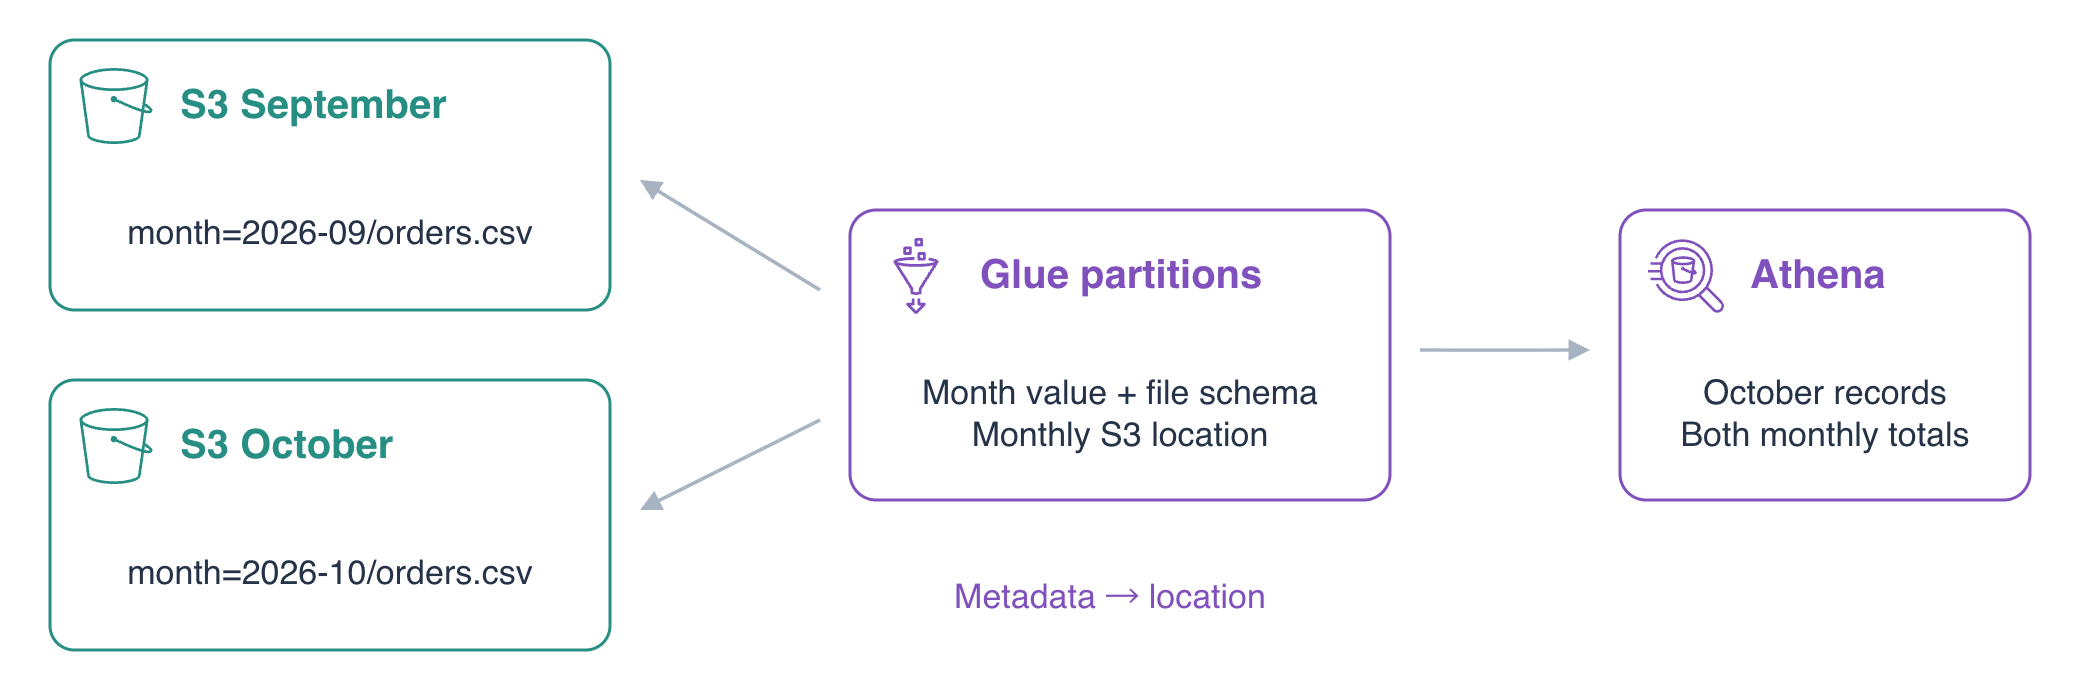
本步骤上传 October 并保留 September。分区按键(如月份)组织表数据。sales/month=2026-09/ 保存 September,sales/month=2026-10/ 将保存 October。key=value 便于识别分组;上传文件不会自动登记目录分区。
进入项目并检查身份:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN 以 labex-an03-operator 结尾。jq -r 提取 JSON 文本,$(...) 保存命令输出。读取并显示资源名:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive 包含嵌套前缀中的对象:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
应看到 sales/month=2026-09/orders.csv。September 金额为 1000、2000、500 分,合计 3500。保留它及无关的 reference/notes.txt。查看本地新文件:
cat october.csv
October 有 O01/east/700、O02/west/900、O03/east/400,三条新订单合计 2000 分,与 September 使用相同三列。上传到独立月度前缀:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
读回实际对象:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
末尾的 - 将内容打印到终端。AWS View 的 S3 现在有两个文件,但 Glue 仍只有 September 分区,说明文件到达与目录登记是两件事。
在目录登记 October
本步骤演示仅上传不足以参与查询,并补齐元数据。分区定义将键值关联到 S3 位置和文件模式。表将字符串 month 声明为分区键;CSV 仅含 order_id、region、total_cents,查询中的 month 来自分区定义。
检查分区键:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
应为 month,类型 string。登记前查询 October。COUNT(*) 统计匹配记录;带引号的 heredoc 分隔符保留 SQL 原文:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
使用准备好的数据库和结果前缀提交,并显示 ID:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
QUEUED、RUNNING 时重复状态命令,仅 SUCCEEDED 后继续;失败查看 Reason:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
读取结果:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
计数为 0,虽然 S3 文件存在。此分区表读取已登记的位置,目录名本身不会创建元数据。
复用表的存储描述符,保留相同列及 CSV 格式。> 将 JSON 输出写入文件:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg 以字符串传入真实位置;.Location = $location 将表位置替换为 October 前缀;Values 提供唯一分区键的值:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
创建前查看普通 JSON 定义:
cat october-partition.json
确认 Values 是 2026-10,列与 CSV 匹配,位置以 /sales/month=2026-10/ 结尾。${SALES_LOCATION} 的花括号将变量名与追加前缀分开。使用 file:// 读取本地 JSON 并登记:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
列出两个登记分区:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
September、October 分别指向自己的 S3 前缀;AWS View 显示两条映射。登记仅修改元数据,不复制或重写 CSV。
查询新月份及两月汇总
本步骤证明 October 可查询且 September 保持正确。分区键上的 WHERE 选择月份。这里只验收真实记录,不测量扫描费用或生产查询速度。
写入 October 查询:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
提交新执行;先前零计数是旧查询输出,登记分区不会改写旧结果:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
读取行前检查状态,排队或运行时重复,成功后继续,失败检查原因:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
读取行:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
表头之后是 O01/700、O02/900、O03/400。登记前不可见的同一文件现在贡献三条记录。
写入两月汇总。SUM 求金额总和,COUNT(*) 统计每个 GROUP BY month 分组的订单数:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
提交并显示独立 ID:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
确认成功;等待期间重复状态命令,失败查看原因:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
读取分组结果:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September 为 3500 分、3 单,October 为 2000 分、3 单。添加 October 没有改变 September。通过 AWS View 比较两个 Glue 位置、SQL 和实际行。
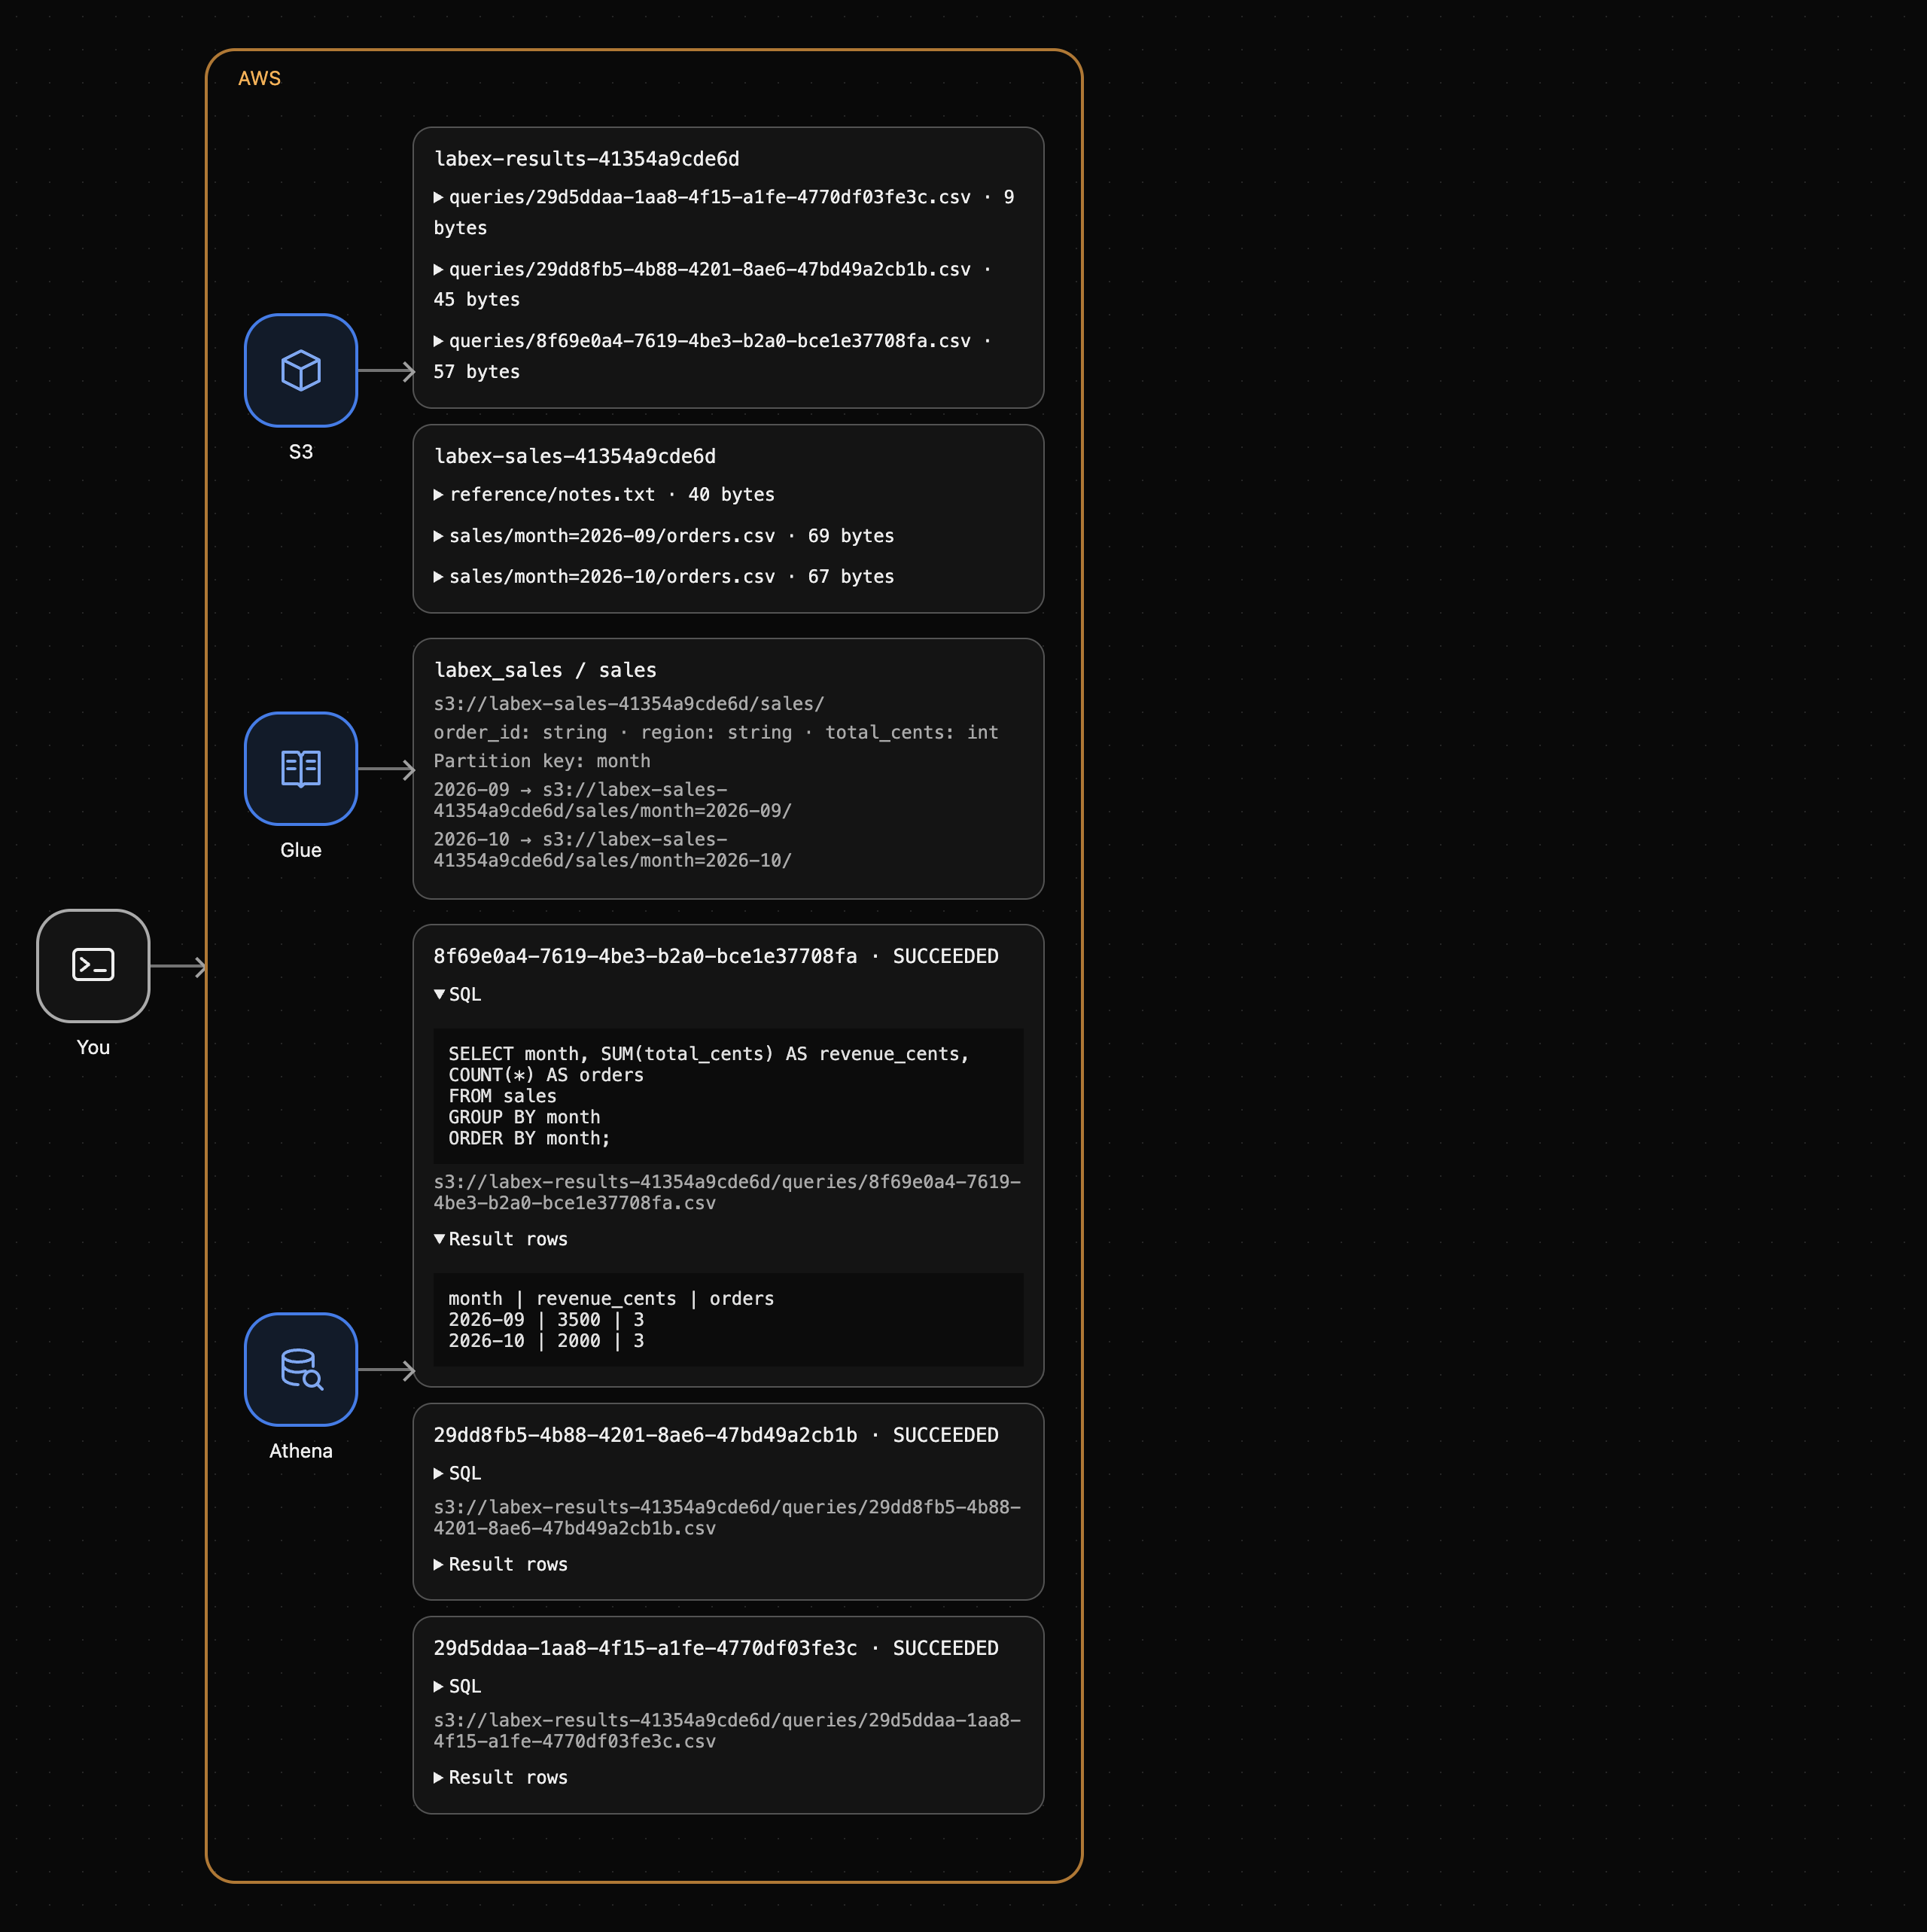
旧零计数仍作为之前目录状态下的独立查询结果存在。
总结
你上传月度 CSV,观察到未登记分区无查询记录,登记 Glue 位置与模式,再验证 October 和两月汇总。文件与目录元数据分开;此表查询新前缀之前需要正确分区登记。下一实验将实际计算结果转为可复用的销售汇总文件。
进一步阅读 AWS 官方资料:分区键、位置与注册。