



介绍
订单支持工具必须显示指定客户在选定月份的订单。只查找一个项目,或在过滤后的空页停止,都可能遗漏有效记录。你将构建复合键表,查询 Ada 的十月订单,并配置提供的应用,让已打包订单视图跟随继续读取键。
请先完成“为订单创建 DynamoDB 表”,掌握带类型的项目和更新。本单元独立开始,提供全新的一次性连接、合成数据文件和普通应用。使用 /home/labex/project、官方 AWS CLI 和 AWS View,不复用之前 VM 的资源。
根据访问模式设计键
在本步骤中,你将准备需要按客户和日期查找的订单。复合主键由分区键和排序键组成。分区键将客户的订单分组;排序键标识组内每个订单,并决定查询结果顺序。两个值一起标识一个项目。
日期使用固定宽度的 YYYY-MM-DD 字符串,后接 # 和订单 ID。字符串排序键比较 UTF-8 字节,因此这个格式使这些日期按时间顺序排列。这是小型订单模型,不是通用的单表设计。
cd /home/labex/project
aws sts get-caller-identity
aws dynamodb create-table --table-name labex-d02-orders --attribute-definitions AttributeName=customer_id,AttributeType=S AttributeName=order_key,AttributeType=S --key-schema AttributeName=customer_id,KeyType=HASH AttributeName=order_key,KeyType=RANGE --billing-mode PAY_PER_REQUEST
aws dynamodb wait table-exists --table-name labex-d02-orders
已准备好的 orders.json 包含五个合成订单,不包含凭据。cat 打印普通 API 请求,让你在加载前查看每个客户、日期和状态。
cat orders.json
aws dynamodb batch-write-item --cli-input-json file://orders.json
BatchWriteItem 加载这些不同的键。确认 UnprocessedItems 为 {}。在 AWS 上,未处理批次需要重试;仅有响应不保证全部写入已完成。示例包含 Ada 的九月、十月和十一月订单,以及 Bob 的十月订单,让你测试边界,而非只测试正常路径。
查询一个客户和日期范围
在本步骤中,你将通过键条件选择 Ada 的十月订单。Query 要求一个分区键相等,并可进一步限定排序键。Scan 检查整张表,而不是先选择键分区。下一步会添加过滤条件;现在先用键选择客户和日期范围。
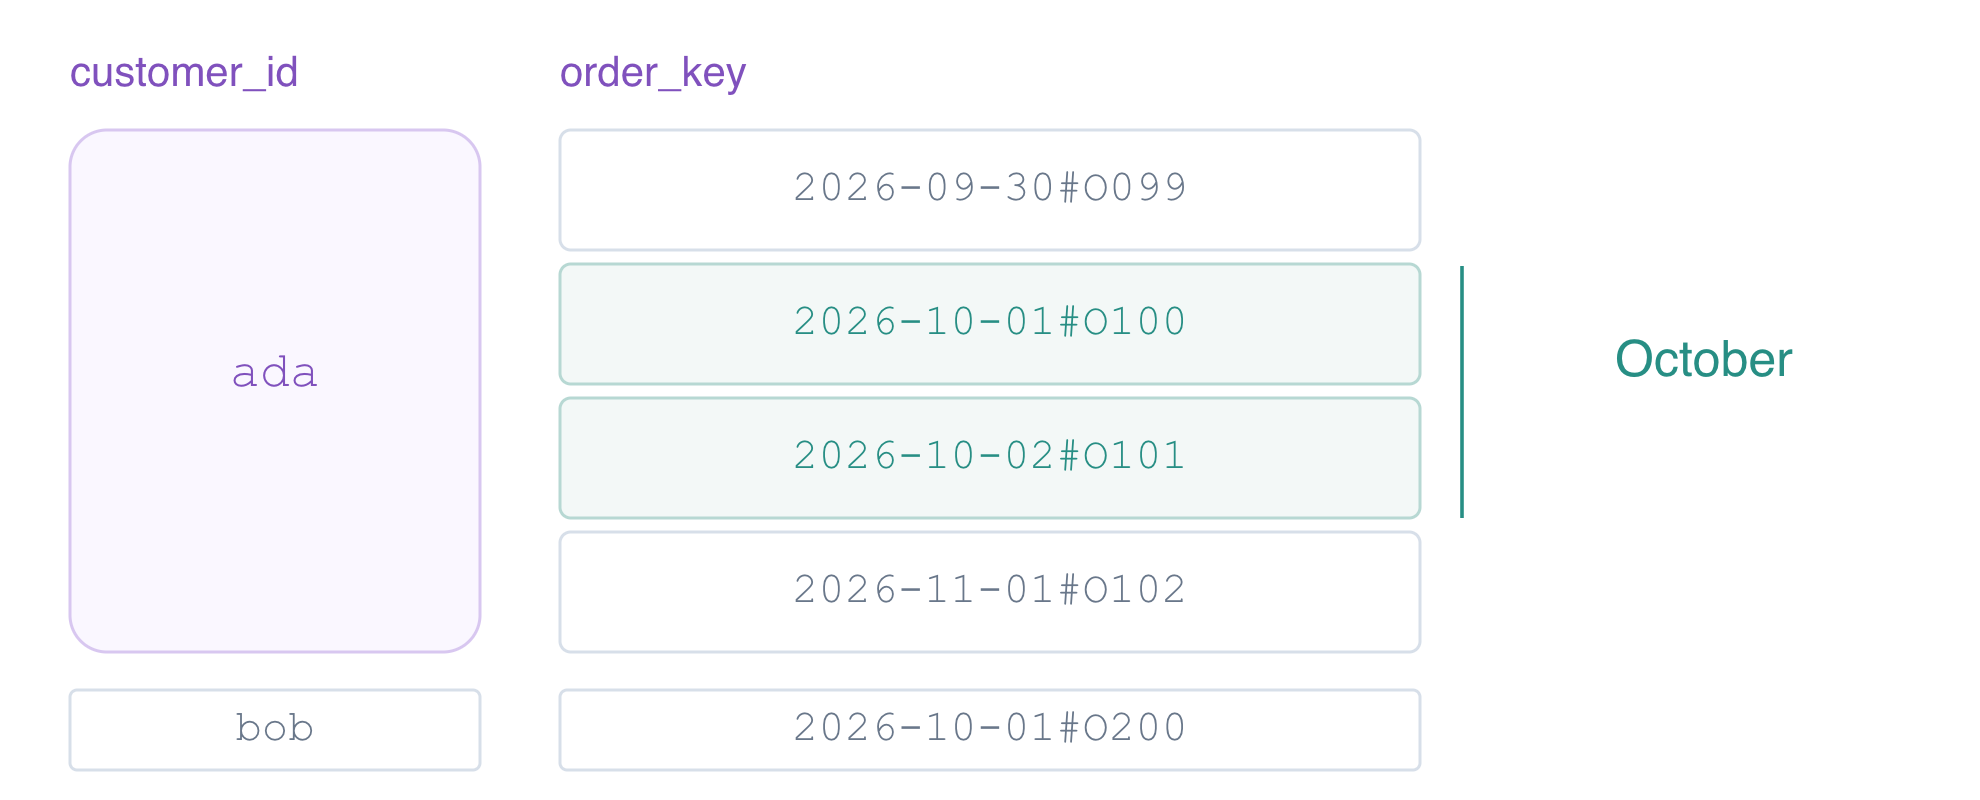
客户键选择 Ada 的分区,日期范围选择其中的十月订单。
先查看全部五条记录,理解扫描范围。
aws dynamodb scan --table-name labex-d02-orders --consistent-read --query 'Items'
提供的订单查询应用读取 lookup.json,并调用 DynamoDB Query API。可执行文件为 order-lookup;源码可供查看,不要求编写 Python。你将配置普通 Query 请求字段,并查看实际应用结果,而非命令历史。
BETWEEN 包含两个端点。订单键包含日期,后接 # 和 ID。起点 2026-10-01# 排在当天 ID 之前;2026-10-31#~ 排在它们之后,因为 ~ 排在这里使用的字母和数字之后。这个边界专用于当前键格式。
带引号的 heredoc 将 JSON 原样写入 lookup.json。request 保存 Query 字段。paginate: false 暂时要求应用只读取一页;下一步会启用继续读取。
cat > lookup.json <<'JSON'
{
  "paginate": false,
  "request": {
    "TableName": "labex-d02-orders",
    "KeyConditionExpression": "customer_id = :customer AND order_key BETWEEN :start AND :end",
    "ExpressionAttributeValues": {
      ":customer": {
        "S": "ada"
      },
      ":start": {
        "S": "2026-10-01#"
      },
      ":end": {
        "S": "2026-10-31#~"
      }
    },
    "ConsistentRead": true
  }
}
JSON
Query 值使用带类型字符串,与 GetItem 一样。应用文件还保存自己的 paginate 设置,因此将结果与使用相同键的直接 CLI 请求比较。
aws dynamodb query --table-name labex-d02-orders --key-condition-expression 'customer_id = :customer AND order_key BETWEEN :start AND :end' --expression-attribute-values '{":customer":{"S":"ada"},":start":{"S":"2026-10-01#"},":end":{"S":"2026-10-31#~"}}' --consistent-read
./order-lookup
两个结果都只包含 Ada 的 O100 和 O101,按排序键升序排列。Bob 的 O200 和 Ada 在其他月份的订单被排除。打开 AWS View,在存储表项目旁查看实际 Order lookup 结果。这些读取不会改变记录。
下面的官方 Console 示例显示分区键 Query。它的 Artist 和 songTitle 与这里的 customer_id 和 order_key 具有相同键角色。用它认识界面;继续在 Terminal 和 AWS View 完成本练习。
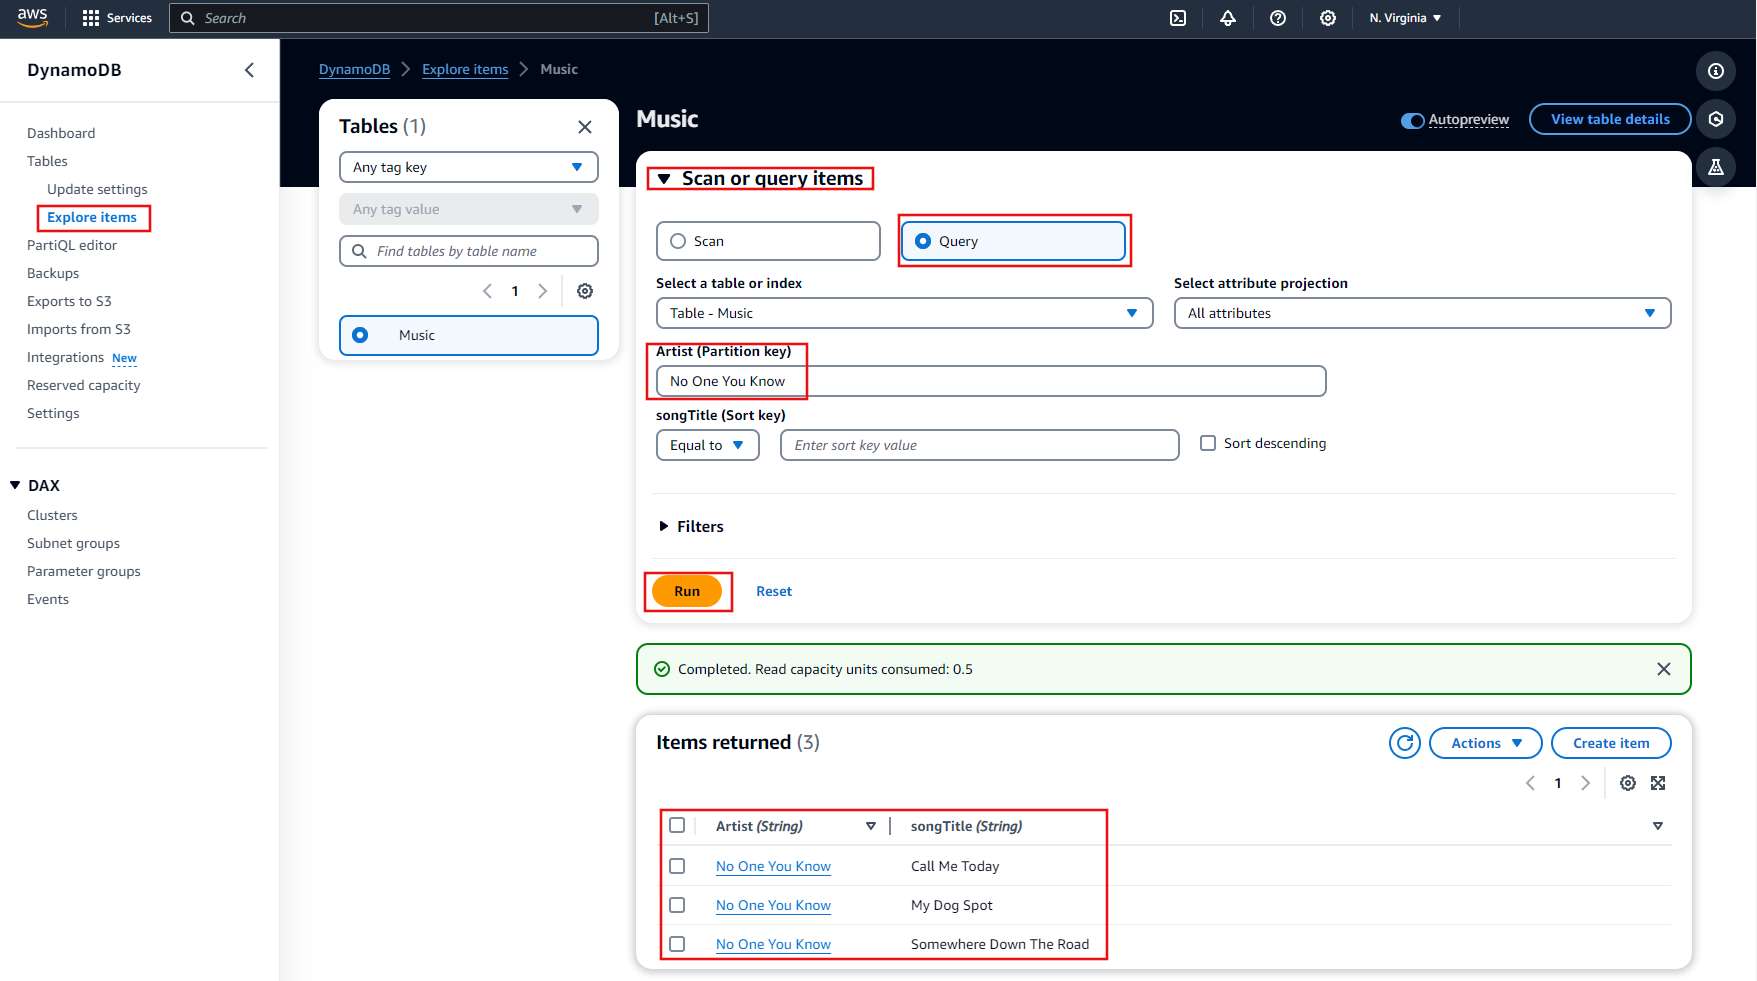
来源:AWS DynamoDB 教程。
过滤后页面为空时仍继续分页
在本步骤中,你将读取已打包的十月订单,不在空的第一页停止。DynamoDB 在过滤前将 Limit 应用于已评估项目。即使 Items 为空,Query 响应仍可能包含 LastEvaluatedKey。应用应根据这个继续读取键,而非项目数量,判断是否请求下一页。过滤不会减少已经完成的读取工作。
已准备好的 packed-page.json 保留相同键,添加 PACKED 状态过滤,并设置 Limit: 1。这个小限制让分页边界可见。--no-paginate 阻止 CLI 读取后续页,让你查看一次服务响应。
cat packed-page.json
aws dynamodb query --cli-input-json file://packed-page.json --no-paginate
第一个评估的订单是 NEW,因此预期为 Items: []、Count: 0、ScannedCount: 1,并有指向 O100 的 LastEvaluatedKey。这不是结果集结束。
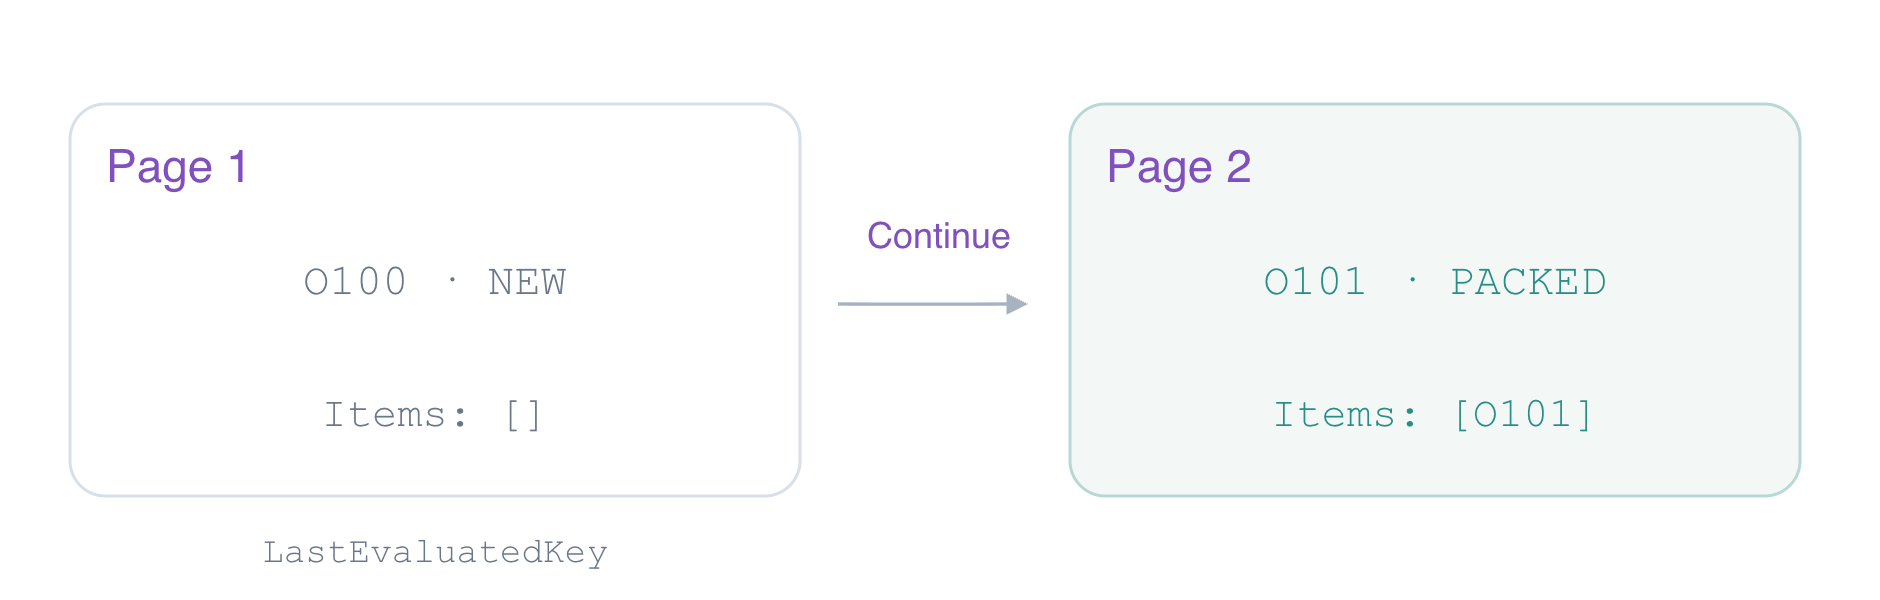
前两页:过滤使第 1 页为空,但继续读取键指向已打包订单。
编写应用配置,跟随这个键,直到 API 不再返回它。#state 避开保留字 status,:state 携带过滤值。
cat > lookup.json <<'JSON'
{
  "paginate": true,
  "request": {
    "TableName": "labex-d02-orders",
    "KeyConditionExpression": "customer_id = :customer AND order_key BETWEEN :start AND :end",
    "ExpressionAttributeValues": {
      ":customer": {
        "S": "ada"
      },
      ":start": {
        "S": "2026-10-01#"
      },
      ":end": {
        "S": "2026-10-31#~"
      },
      ":state": {
        "S": "PACKED"
      }
    },
    "ConsistentRead": true,
    "ExpressionAttributeNames": {
      "#state": "status"
    },
    "FilterExpression": "#state = :state",
    "Limit": 1
  }
}
JSON
./order-lookup
应用只返回 Ada 的 O101,状态为 PACKED,Count: 1、Evaluated: 2。在这个数据集中,Pages: 3 包含最后一次空请求,用于确认查询结束。继续读取键标记读取边界,不保证还有匹配项目。应用跟随 ExclusiveStartKey,直到服务不再返回继续读取键。在 AWS View 中,查询结果改变,但全部存储记录保持不变。
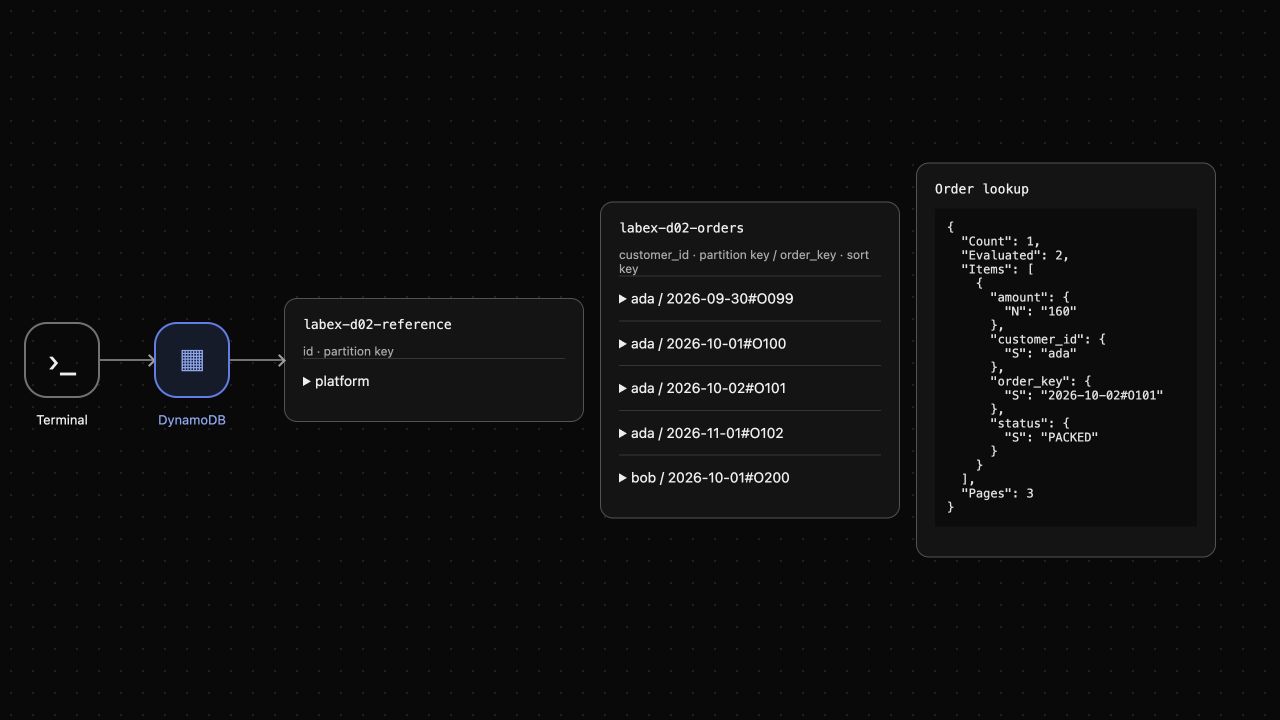
验证清单并删除自己的表
在本步骤中,你将在证明查询行为后清理。先检查目标表仍包含原始五条记录。读取和配置变化不应修改订单数据。
aws dynamodb scan --table-name labex-d02-orders --consistent-read --select COUNT
预期为 Count: 5。只删除 labex-d02-orders,再等待它不存在。参考表属于环境,必须保留。
aws dynamodb delete-table --table-name labex-d02-orders
aws dynamodb wait table-not-exists --table-name labex-d02-orders
aws dynamodb list-tables
aws dynamodb get-item --table-name labex-d02-reference --key '{"id":{"S":"platform"}}' --consistent-read
清单只保留 labex-d02-reference,其 note 仍为 keep unchanged。AWS View 移除练习表和查询结果。成功服务响应证明删除;连接不可用不能证明。一次性连接随这个 VM 结束。
总结
你按客户分组订单,并通过日期排序键排列。Query 选择目标分区和范围,Scan 检查更广的整张表。你看到过滤在评估后执行,空页仍可能需要继续读取。提供的应用使用实际 Query 请求,跨分页请求收集已打包订单,随后你只删除了自己的资源。


