介绍
客服团队需要为重复扣款报告起草回复。你将把工单发送给 Bedrock Runtime,完善起草指令,查看生成的响应,并将 token 用量与输出限额比较。新的 LabEx VM 已配置好 AWS CLI;只使用这里提供的合成工单。
你应掌握运行命令和读取文本文件的基本操作。本任务是生成并审阅草稿,不会发送客户消息或更改账单记录。
认证关联
| 认证 | 考试任务 | 练习内容 |
|---|---|---|
| AI Practitioner (AIF-C01) | 任务 3.1、3.2 | 调整输出长度,提供明确的起草指令,并审阅生成文本。 |
起草客服回复
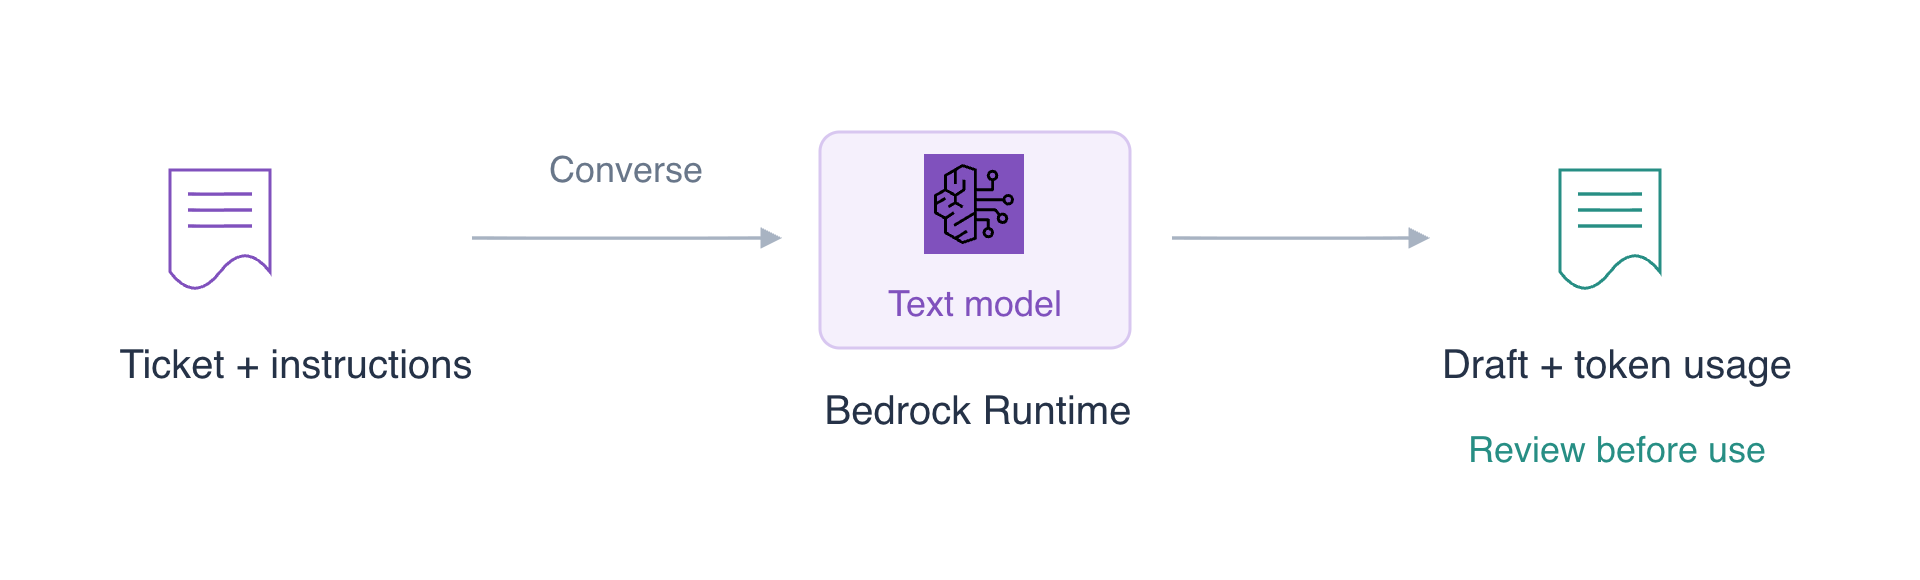
本步骤中,你将选择可用的文本模型,并把客服工单发送给 Bedrock Runtime。
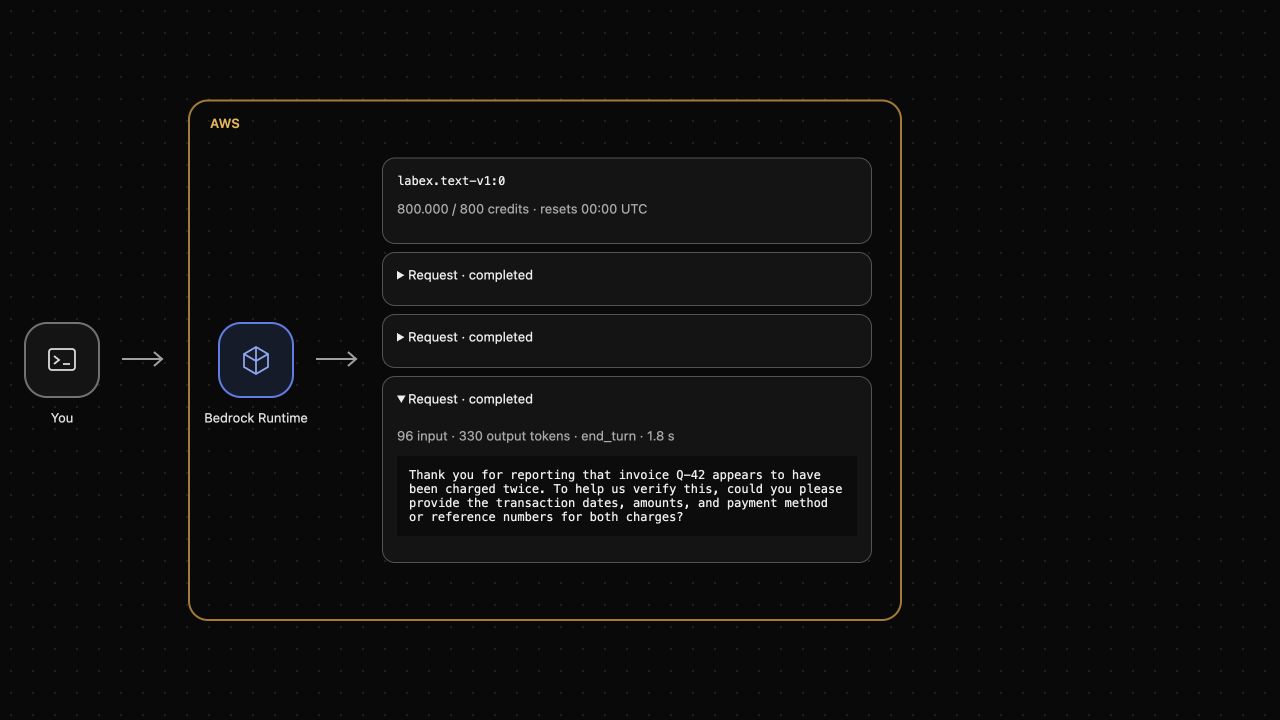
上方 AWS View 显示模型和实际请求结果,下方 Terminal 用于输入命令。发送请求前,View 中没有回复。发送后,它会显示等待中的请求,随后显示响应、用量和剩余额度。
Bedrock 提供基础模型的访问能力,这类模型可以为多种任务生成文本。模型标识符用于选择模型;Converse 是受支持对话模型的通用请求格式。这里使用工作区内可用的文本模型。
先进入练习目录。cd 改变 Terminal 的当前目录:
cd /home/labex/project
列出能够输出文本的模型。--by-output-modality TEXT 筛选目录;--query 选择标识符和易读名称;--output table 将这些字段显示为表格:
aws bedrock list-foundation-models \
  --by-output-modality TEXT \
  --query 'modelSummaries[].[modelId,modelName]' \
  --output table
表格包含下面将使用的 labex.text-v1:0。目录条目描述一个模型,并不代表推理请求已经执行。
Converse 请求包含 modelId、messages 列表和可选推理设置。每条消息都有 role 和内容块。user 消息承载问题或任务,文本内容块使用 text 字段。maxTokens 限制生成输出;temperature 控制采样变化。较低的 temperature 可以减少变化,但不保证回复准确或完全相同。
以 JSON 创建请求。cat > request.json 写入文件;<<'EOF' 标记开始按原样读取多行输入,最后的 EOF 结束输入。这里只替换指定的练习文件:
cat > request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. Draft an English support reply in two sentences."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
使用 bedrock-runtime converse 发送请求。--cli-input-json file://request.json 从该文件读取请求字段。末尾的 > reply.json 将 JSON 响应保存到文件,而不是打印出来:
aws bedrock-runtime converse \
  --cli-input-json file://request.json \
  > reply.json
等待 Terminal 提示符重新出现。生成文本通常需要几秒。第一个请求仍在等待时,不要运行另一个请求。
读取响应:
cat reply.json
寻找 output.message.role: "assistant" 和非空的 text 内容块。usage 报告处理的 token,metrics.latencyMs 报告以毫秒计的响应时间。在 Terminal 上方的 AWS View 中展开已完成请求,将回复与文件比较。
仔细阅读草稿。它是否声称调查已开始、退款已发出或扣款已确认?工单没有提供这些事实。流畅的响应也可能包含编造的细节;下一步将收紧指令。不要把模型生成的句子当成已完成的账单操作。
完善起草指令
本步骤中,你将添加明确指令,并根据同样的已报告事实生成新草稿。
system 字段提供任务和风格指令。将工单保留在 user 消息中,把起草约束放在 system 消息中。更具体的指令可以减少不需要的细节,但仍必须审阅响应。
创建独立请求,保留原始草稿以便比较:
cat > revised-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
生成修改后的草稿:
aws bedrock-runtime converse \
  --cli-input-json file://revised-request.json \
  > revised-reply.json
使用 Python 标准 JSON 格式化工具检查保存的响应。它会验证文件是否为有效 JSON,并格式化显示:
python3 -m json.tool revised-reply.json
在上方 AWS View 中展开新的已完成请求。根据给定工单比较两份草稿。修改后的请求应清楚表达你的要求;这一次响应是否遵循要求,仍需人工判断。若它编造了操作,不要在客户回复中使用该句子。
这些请求相互独立。复用同一模型不会自动把前一次响应作为对话历史发送。后续对话需要把先前的 user 和 assistant 消息明确加入 messages。
查看 token 用量和输出限额
本步骤中,你将为同一起草任务设置更小的输出上限,并查看实际用量。
Token 是模型处理文本的单位,并不一定等于一个单词。输入 token 包含任务、system 指令和提供的任何历史。输出 token 包含模型报告的生成 token,可能包括内部推理。返回的 totalTokens 是输入与输出 token 之和。
maxTokens 是上限,不是要求恰好生成该数量的 token。模型可能提前结束。创建输出上限为 384 token、而不是 512 的请求:
cat > bounded-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 384, "temperature": 0}
}
EOF
发送请求并保存响应:
aws bedrock-runtime converse \
  --cli-input-json file://bounded-request.json \
  > bounded-reply.json
查看结果:
python3 -m json.tool bounded-reply.json
将 usage.outputTokens 与 384 token 上限比较。stopReason: "end_turn" 表示模型正常结束;"max_tokens" 表示达到输出上限,因此文本可能不完整。不要将部分回复视为已完成文档。
上方 AWS View 显示相同的用量和当前剩余 credits。Credits 反映模型特定的输入与输出消耗;仅凭 token 数量不能得出不同模型的统一价格。重复请求可能由缓存的模型结果响应,因此即使有 token 用量,剩余 credits 也可能不变。上限有助于约束请求,但更小的上限不保证这次简短回复比每一次先前回复都消耗更少的 token。
如果请求失败或用量不确定,重试前先检查错误。不确定的请求可能保留预留额度,另发请求也可能增加消耗。课程后续会介绍应用如何处理这些情况。
清理练习文件
本步骤中,你将在审阅草稿后删除本地请求和响应文件。
Converse 发送推理请求,不会创建需要删除的服务器或数据库。六个 JSON 文件是本地练习产物。删除它们不会撤销 token 用量,也不会恢复已经消耗的 credits。
rm 删除指定文件。使用下面的准确文件名,并保留其他项目文件:
rm request.json reply.json revised-request.json revised-reply.json bounded-request.json bounded-reply.json
列出工作区剩余的可见条目:
ls
六个练习文件应已不存在。AWS View 为此 VM 保留实际已完成请求的结果和用量;删除本地文件不能把失败请求变成成功请求,也不能抹去消耗。
总结
你使用 Bedrock Converse 发送了实际文本请求,完善 system 指令,查看生成回复和 token 用量,限制输出长度,并删除本地练习文件。你还区分了看似合理的草稿与已验证的业务事实:响应在使用前必须审阅。
进一步阅读 AWS 官方资料:Converse 消息、指令与推理设置; Converse 响应内容、停止原因与用量。