介绍
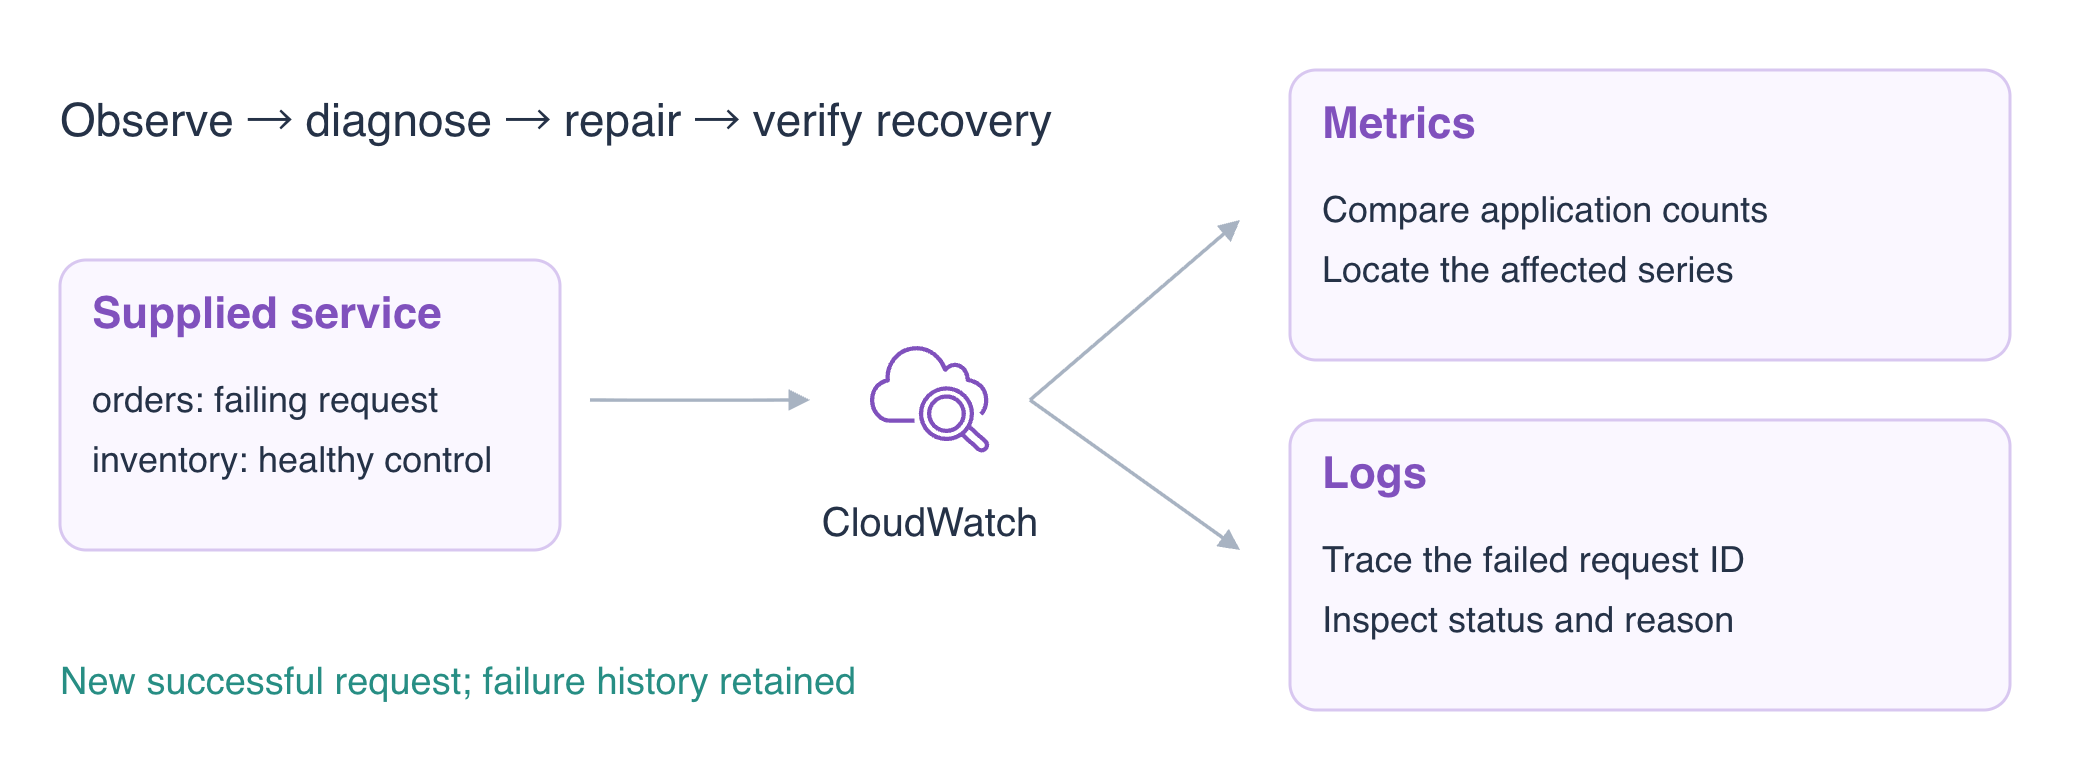
有效的订单请求失败了,而库存请求却成功。你将比较应用指标,在日志中追踪失败请求,修复一个小型配置故障,并在保留失败历史的情况下确认恢复。
请先完成 在 CloudWatch Logs 中查找失败请求 和 使用 CloudWatch 指标衡量应用健康。本实验提供独立的应用和故障场景。
认证考点
| 认证 | 考点 | 本实验练习 |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | 任务 1.2 | 通过日志与指标诊断应用故障。 |
| Developer – Associate (DVA-C02) | 任务 4.1 | 通过日志与指标诊断应用故障。 |
| DevOps Engineer – Professional (DOP-C02) | 任务 5.3 | 基础练习:通过日志与指标诊断应用故障。 |
| Solutions Architect – Professional (SAP-C02) | 任务 3.1 | 基础练习:通过日志与指标诊断应用故障。 |
| Data Engineer – Associate (DEA-C01) | 任务 3.3 | 基础练习:通过日志与指标诊断应用故障。 |
实验概览
复现故障并与对照请求比较
本步骤中,你将复现一个意外失败的有效订单请求。独立准备好的服务存在普通的配置故障。它的日志和指标最初为空,因此观察结果来自你自己的请求。
cd /home/labex/project
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-failure-1' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-failure-2' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-control' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/inventory
对于同一个有效的合成 apple 请求,预期得到两次 orders 的 HTTP 503 stock_unavailable 响应,以及一次 inventory 的 HTTP 200 accepted 响应。这个对照结果提示问题可能仅与 orders 有关,但不能证明整个系统健康。
使用近期 UTC 窗口和准确的 Application 维度比较服务端错误计数。指标汇总发生频率,而单条日志可以解释某个具体响应。
START=$(date -u -d '15 minutes ago' +%Y-%m-%dT%H:%M:%SZ)
echo "$START"
保存查询时间窗口的 UTC 结束时间:
END=$(date -u -d '1 minute' +%Y-%m-%dT%H:%M:%SZ)
echo "$END"
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=inventory \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
将返回的聚合时间段相加,预期 orders 的 Sum 为 2,inventory 的 Sum 为 0。保持 /labex/o05-reference 不变。
将错误计数与请求日志关联
本步骤中,你将把汇总的异常现象与具体的失败请求关联起来。先查询 ERROR,再查询准确的请求 ID。带引号的短语会匹配完整的 request_id 词项,避免混入名称相近的请求。
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern ERROR \
  --query 'events[].{Time:timestamp,Message:message}'
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern '"request_id=o05-failure-1"' \
  --query 'events[].message'
两次失败都标明 application=orders、status 503 和 reason stock_unavailable。近期窗口内的指标和日志覆盖了同一批请求。检查应用设置,找出它与有效 apple 请求不匹配的位置。
cat app.json
orders 的 accepted_sku 为 pear。Inventory 独立使用预期的 apple 设置。这是一个小型配置故障;替换服务或禁用可观测性会隐藏异常现象,却不能修复它。
失败请求提交的是 apple,但订单配置只接受 pear。这一不匹配为 stock_unavailable 提供了可验证的解释,正常的 inventory 请求则帮助缩小故障范围。下一步通过修改订单配置并再次发送有效请求来检验这个解释。恢复需要新的成功响应及其匹配日志作为证据,仅修改配置还不够。
修复设置并验证恢复
本步骤中,你将更改允许的 SKU,并证明业务响应恢复正常,同时遥测功能仍然启用。用修正后的设置替换普通的配置文件。
cat > app.json <<'JSON'
{"logging": {"enabled": true, "group": "/labex/o05-application", "stream": "requests"}, "metrics": {"enabled": true, "namespace": "LabEx/O05"}, "accepted_sku": "apple"}
JSON
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-recovered' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern '"request_id=o05-recovered"' \
  --query 'events[].message'
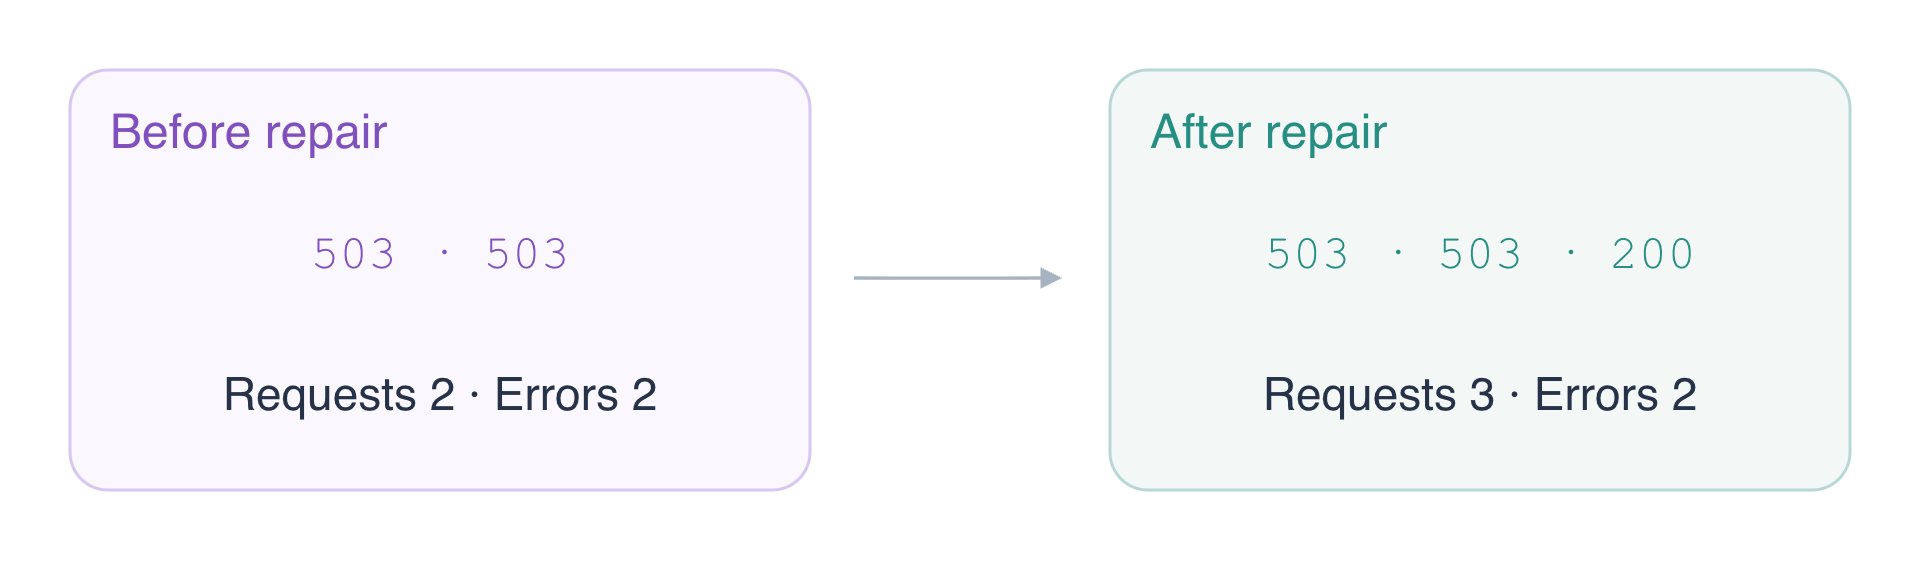
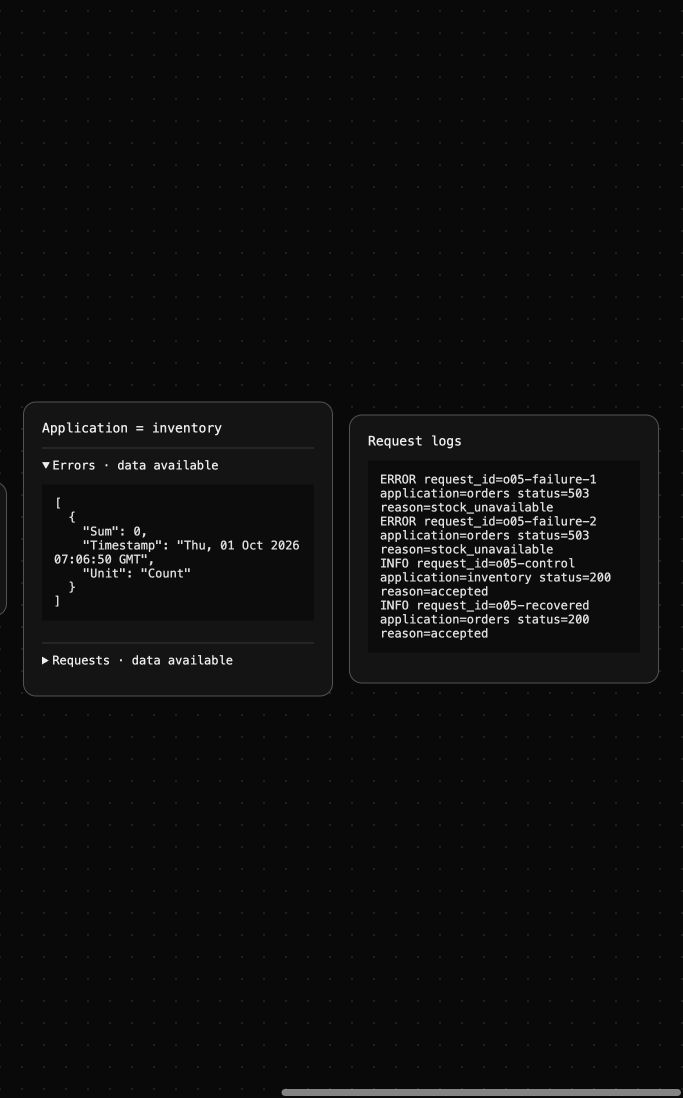
预期得到 HTTP 200 accepted,以及具有相同恢复请求 ID 的 INFO 日志。历史失败仍保留在窗口中。正常请求发布 Errors=0,因此累计错误 Sum 仍为 2,而 Requests 增加到 3。
START=$(date -u -d '15 minutes ago' +%Y-%m-%dT%H:%M:%SZ)
echo "$START"
保存查询时间窗口的 UTC 结束时间:
END=$(date -u -d '1 minute' +%Y-%m-%dT%H:%M:%SZ)
echo "$END"
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Requests \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
AWS View 显示实际的应用序列和请求日志。使用恢复请求的 ID,区分新的成功响应与保留下来的失败历史。
停止遥测并清理本实验的日志组
本步骤中,你将停止监测,并仅移除故障场景的日志组。已有指标按保留规则保存;没有用于删除单个指标的 API。
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o05-application", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O05"}, "accepted_sku": "apple"}
JSON
aws logs delete-log-group --log-group-name /labex/o05-application
aws logs describe-log-groups --query 'logGroups[].logGroupName'
aws logs get-log-events \
  --log-group-name /labex/o05-reference \
  --log-stream-name platform \
  --query 'events[].message'
预期只剩下 /labex/o05-reference,以及它原始的 INFO platform reference keep unchanged 消息。成功获取清单可验证定向删除;查询失败不能证明清理完成。
总结
你通过对照请求复现了故障,将指标计数与请求日志关联,修复了应用设置,验证了新的成功响应,并在定向清理前保留了历史证据。
进一步阅读 AWS 官方资料:指标身份、维度与统计量; 按词项与精确短语筛选日志事件。