介绍
配置 CloudWatch 告警,观察错误发布导致的网站失败,再恢复成功请求,使告警回到 OK。
请先完成请求日志实验。本节新环境独立提供网站、三张私有 S3 封面、作品列表、角色、日志和请求指标接入。告警由你创建,故障与恢复也由你操作,无需前节资源或凭据。
认证考点
| 认证 | 考试任务 | 练习内容 |
|---|---|---|
| AWS Certified Cloud Practitioner (CLF-C02) | Task 3.8 | 使用 CloudWatch 请求指标、告警和日志观察应用故障与恢复。 |
实验概览
配置网站错误告警
本步骤,你将为作品站主页的实际错误请求创建告警。
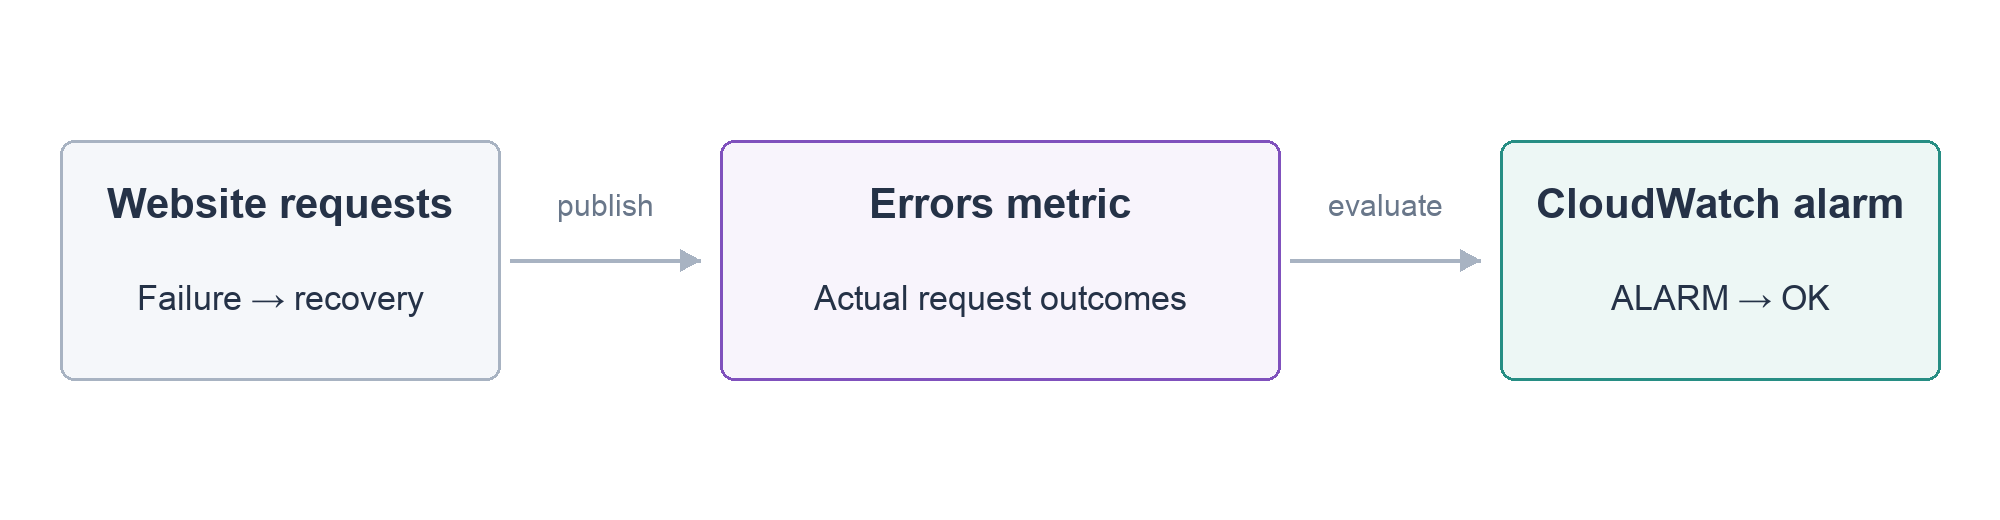
从 AWS View 打开作品站,确认正常。每次 /website 请求产生一个 Errors 指标值:失败为 1,成功为 0。图片和其他请求各有日志,但不计入这个主页指标。
指标(metric)是随时间记录的数值。namespace(命名空间)为指标分组,dimension(维度)标识应用。本节使用 LabEx/Portfolio 中的 Errors,维度 Application=portfolio。告警(alarm)将已评估数据与阈值比较,发现异常,本身不会修复网站。
加载并显示本节标识:第一个值是实例 ID,第二个是 SCP 使用的地址,第三个是日志组:
cd /home/labex/project
source website.env
echo "$INSTANCE_ID"
echo "$PUBLIC_IP"
echo "$LOG_GROUP"
查看准备好的告警文件。下表解释它要评估的内容:
cat website-alarm.json
| 设置 | 含义 |
|---|---|
MetricName: Errors |
作品站主页请求错误 |
Statistic: Sum |
对周期内错误值求和 |
Period: 10 |
评估十秒周期 |
EvaluationPeriods: 1 |
一个评估周期即可判断 |
Threshold: 0 / GreaterThanThreshold |
存在错误时总和大于零 |
TreatMissingData: missing |
没有请求数据不等于健康 |
Unit: Count |
按失败请求次数计数 |
十秒告警需要高分辨率自定义指标,提供好的接入代码以一秒分辨率发布。本节不配置通知目标。像 launch.json 一样,--cli-input-json 通过 file:// 读取本地文件:
aws cloudwatch put-metric-alarm \
  --cli-input-json file://website-alarm.json
更新成功没有输出。用 --query 只读取告警名称、状态和原因:
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
开始的 StateValue 可能为 INSUFFICIENT_DATA,表示尚缺已评估的数据。AWS View 显示同一告警。后续用真实失败和成功请求驱动状态,不手动设置它。
观察一次错误发布
本步骤,你将发布有意准备的无效简介,把实际失败请求与告警对应起来。
查看 profile-broken.json。其中的 {invalid-json 是故意准备的练习故障,应用无法把它解析为 JSON。沿用之前学过的 SCP 连接和目标路径发布:
cat profile-broken.json
scp -F ssh_config profile-broken.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
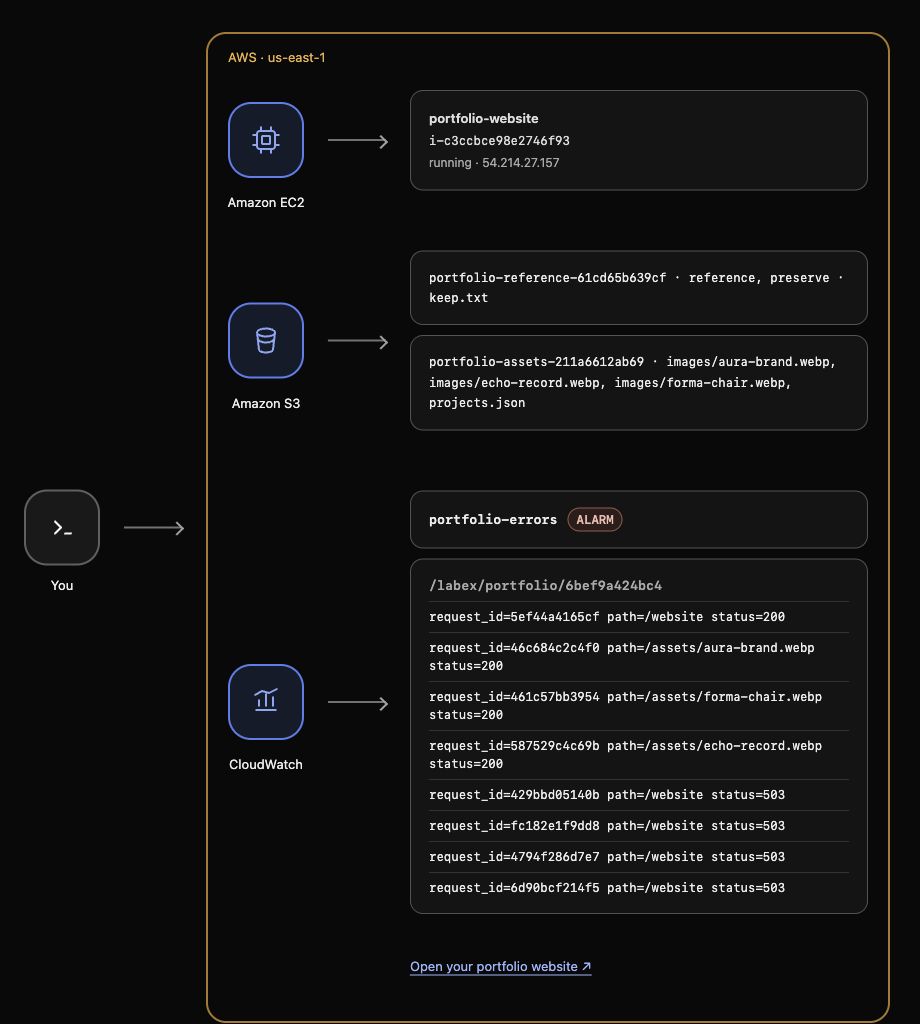
刷新作品站,应显示 Website unavailable,AWS View 中 EC2 仍为 running。服务器正在运行,但应用无法处理主页请求。到日志组找到失败响应:
aws logs filter-log-events \
  --log-group-name "$LOG_GROUP" \
  --filter-pattern '"status=503"' \
  --query 'events[].message'
确认 path=/website status=503。HTTP 503 记录应用未成功处理请求。本节刚进行的发布给出了具体排查方向;仅凭状态码不能解释所有可能原因。
给评估约十秒,再读告警。如果尚未到 ALARM,就刷新出错页面提供新的真实样本,再等一个评估周期,重运行同一条查询:
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
确认响应和 AWS View 中的 StateValue: ALARM。历史 503 日志不等于新指标样本;确认期间持续提供近期失败请求。现在,错误发布与实际测量的错误已经对应起来了。
等待十秒评估期间,约每五秒刷新一次页面,让相邻周期持续有请求样本。读到预期状态后,趁请求仍为近期数据,及时点击本步骤的 Check 按钮。
恢复网站并确认正常
本步骤,你将恢复已知有效的简介,并确认成功请求与告警都恢复正常。
查看 profile-working.json。它提供应用需要的三个有效字段,发布到同一目标:
cat profile-working.json
scp -F ssh_config profile-working.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
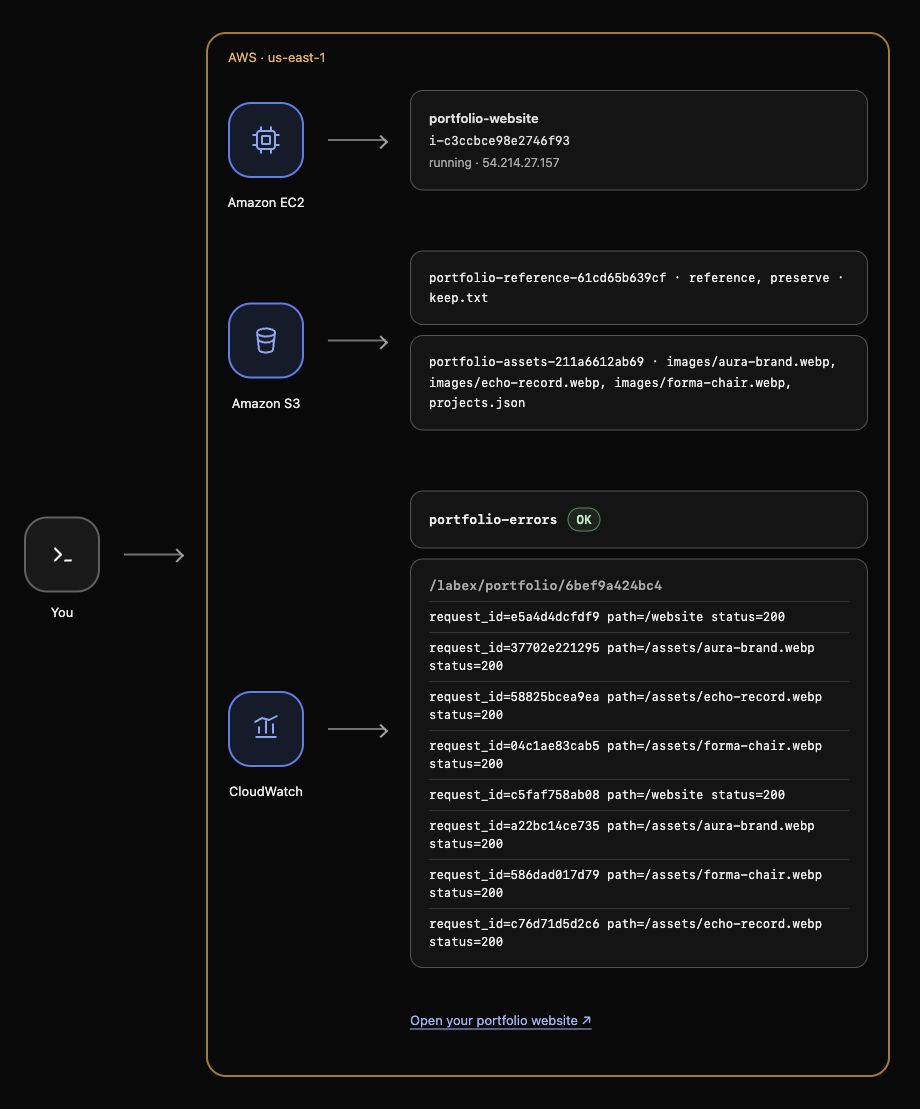
刷新作品站,Alex Morgan、Make it memorable. 和三张封面应重新出现,证明应用修复成功。读取成功请求消息:
aws logs filter-log-events \
  --log-group-name "$LOG_GROUP" \
  --filter-pattern '"status=200"' \
  --query 'events[].message'
找到故障之后新增的 path=/website status=200。先前的 503 仍在组内历史中。页面可能先于告警恢复:此前周期已计入的错误,不会被后来的成功请求抹掉。
让成功流量进入新的评估周期。约每五秒刷新正常页面,必要时重复状态查询,直到 StateValue: OK。OK 表示已评估请求数据未超过错误阈值。如果停止请求,缺失数据处理可能让状态回到 INSUFFICIENT_DATA,它不证明网站健康。
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
等待十秒评估期间,约每五秒刷新一次页面,让相邻周期持续有请求样本。读到预期状态后,趁请求仍为近期数据,及时点击本步骤的 Check 按钮。
总结
你完成了真实运行闭环:发布导致失败,日志显示响应,告警检测测量到的错误,有效发布恢复网站和 OK 状态。你也区分了无数据与成功流量。作品站保持可用,供你继续查看。
官方参考:CloudWatch 告警、高分辨率自定义指标。