介绍
商店需要可分享的月度销售 CSV。用 Athena 计算总额,从 S3 读取实际输出,更正销售金额后生成新汇总。比较两次输出,理解结果对应执行时的输入。
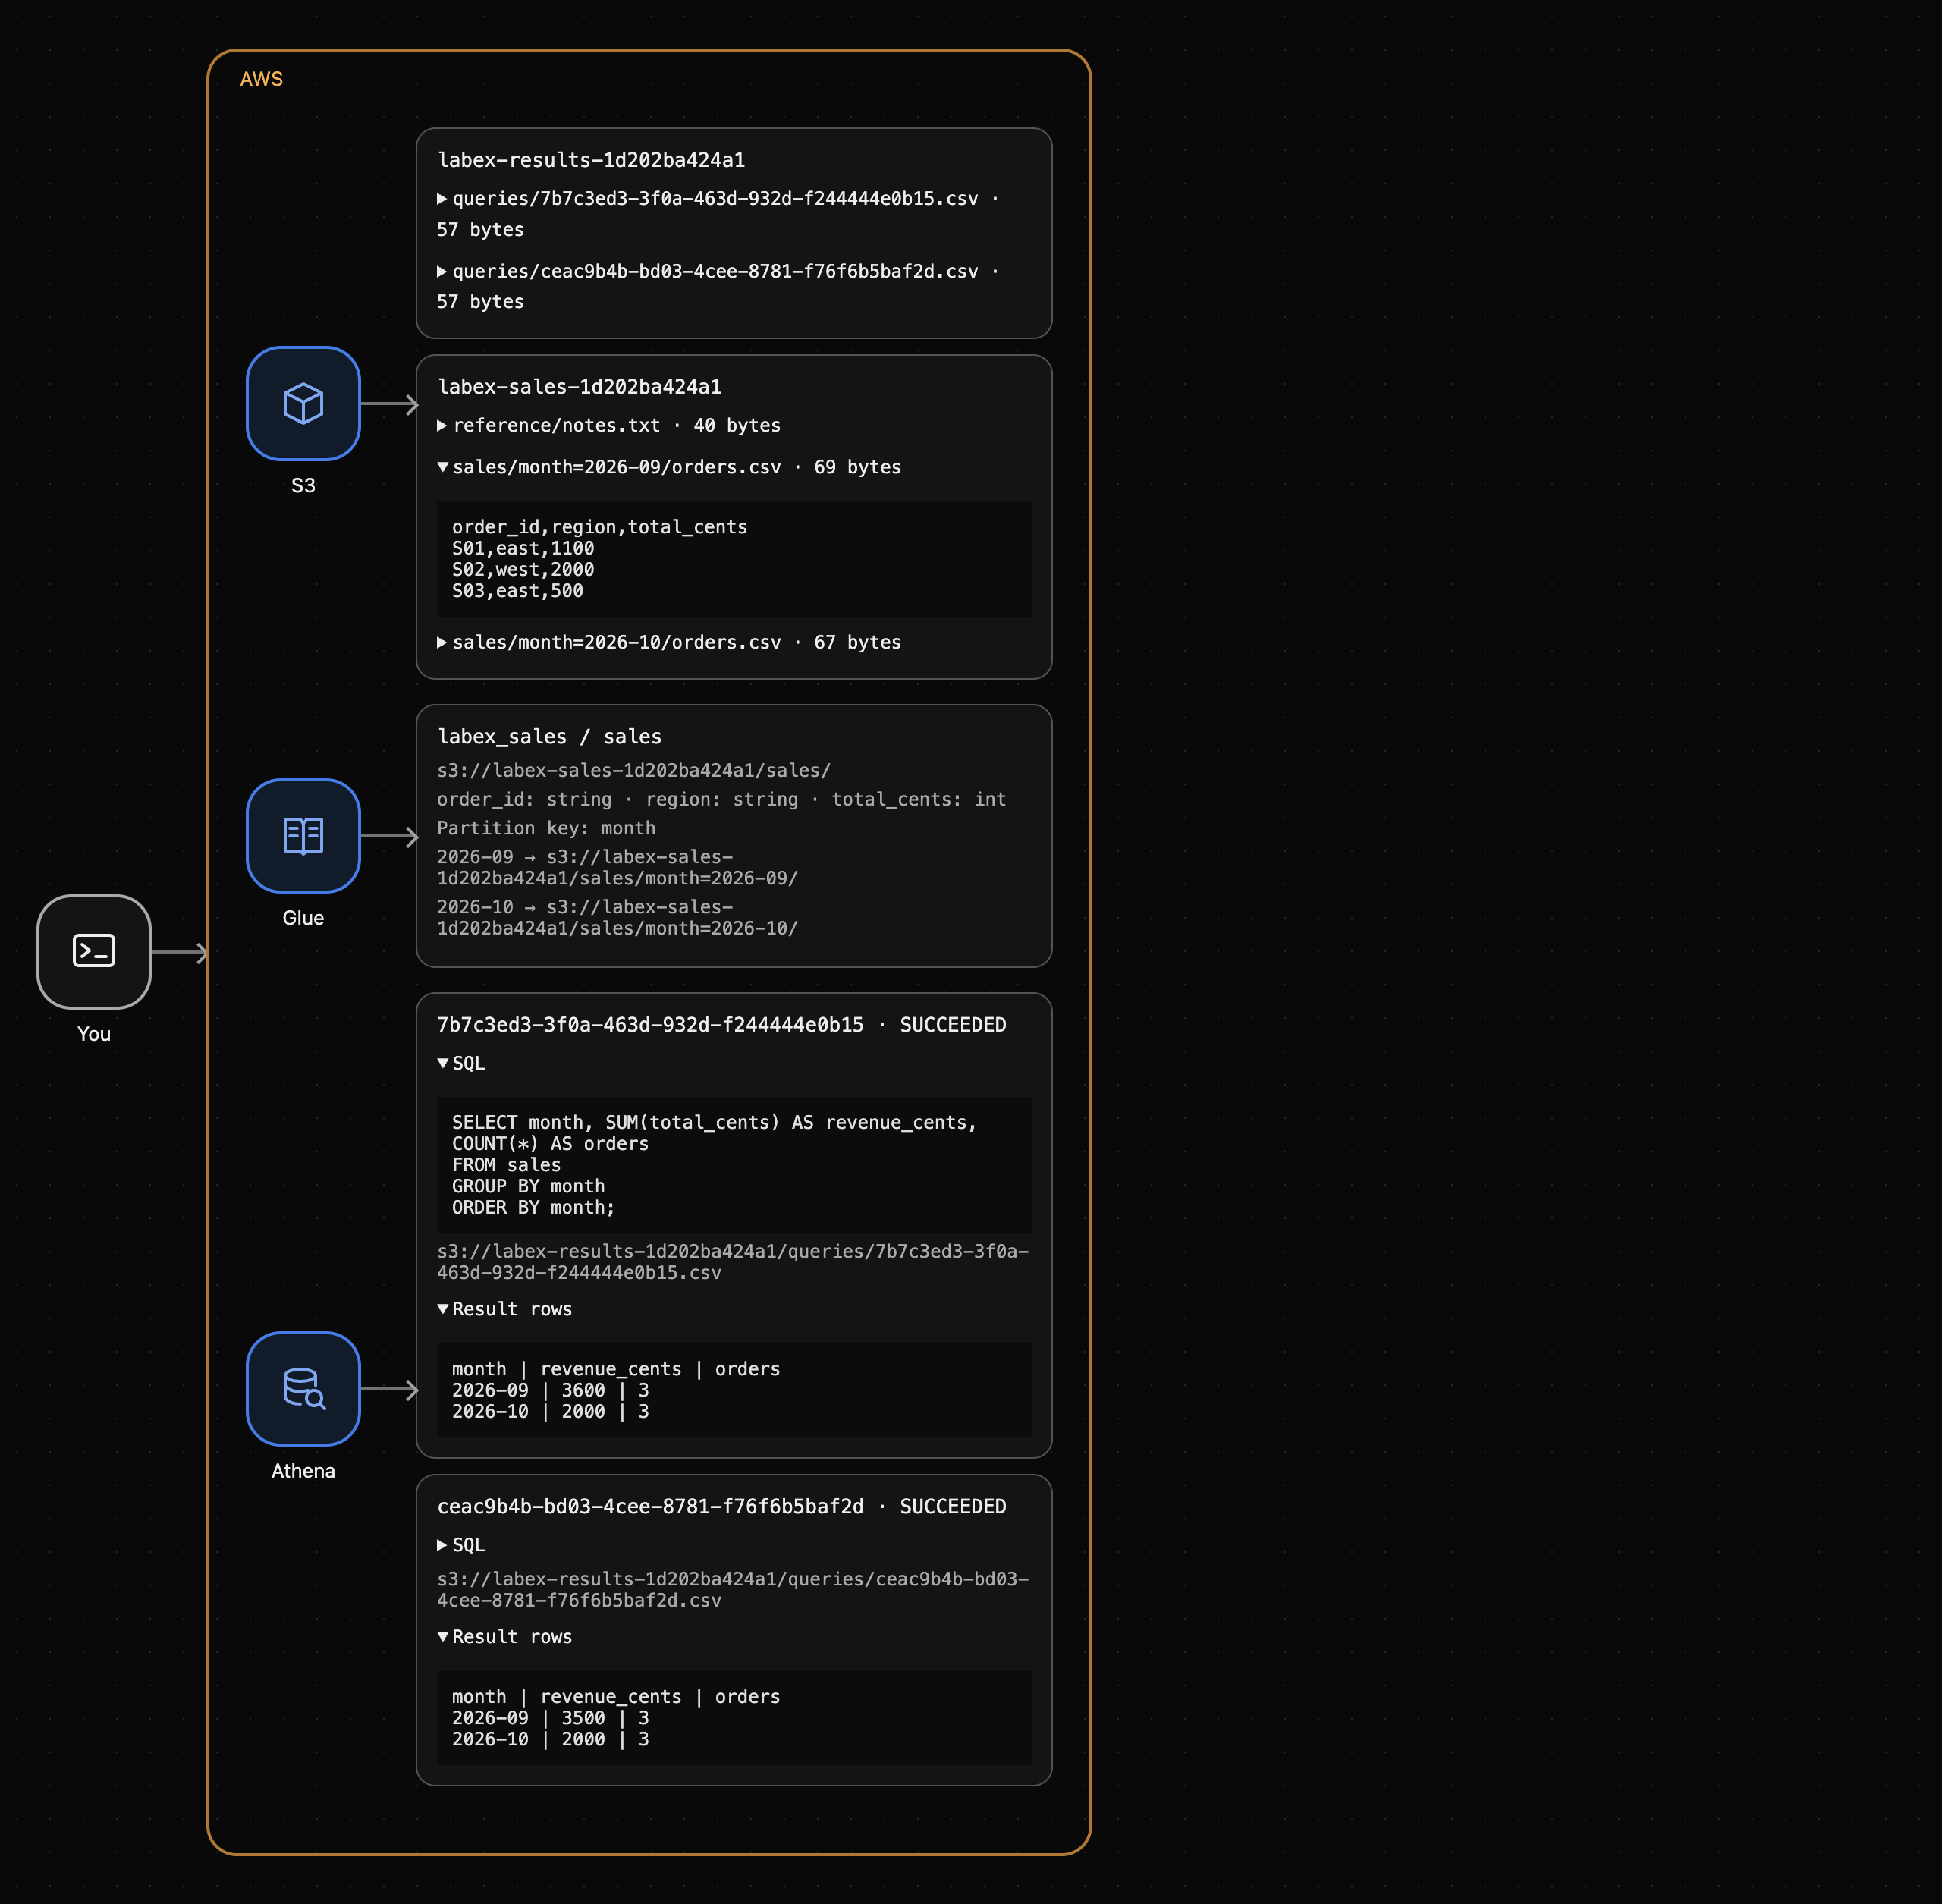
先完成 Query Partitioned Sales Data。本独立环境提供两个月的 S3 文件、已登记的 Glue 分区、AWS 身份及本地更正版 September 文件,无需个人账户或前一 VM 资源。在 Terminal 使用官方 AWS CLI,在 AWS View 检查实际文件、目录位置及查询结果。
认证考点
| 认证 | 考试任务 | 实践内容 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | 使用 Athena 和 Glue 分析 S3 数据,读取实际计算结果。 |
计算月度汇总
本步骤从当前销售文件计算汇总。Glue 保存模式及月度位置,Athena 读取相应数据并按月分组。每次执行都有独立 ID 和结果文件。
进入项目并确认身份:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN 以 labex-an04-operator 结尾。jq -r 提取 JSON 字符串,$(...) 将输出保存到变量:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
检查已登记位置:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
September、October 均已登记。以整数分金额对 total_cents 求和可避免货币舍入。COUNT(*) 数订单,GROUP BY month 每月一组,ORDER BY month 便于对照;带引号的 heredoc 原样写入 SQL:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
使用数据库和 S3 输出前缀提交。file:// 读本地 SQL,CLI 的 --query、--output text 提取执行 ID:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
读取前检查状态。QUEUED、RUNNING 时重复,仅 SUCCEEDED 后继续;FAILED 时检查 Reason:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
读取实际计算行。嵌套 [*] 投影保留每行的列结构:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September 为 3500 分/3 单,October 为 2000 分/3 单。在 AWS View 展开 SQL 和结果,与两个月的位置比较。
下载实际 S3 结果文件
本步骤读取本次执行生成的 CSV。Athena 结果 API 显示行,执行元数据提供 S3 输出位置。读取精确位置,不猜桶名或 ID。
提取并显示 URI:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
URI 以 /queries/<your-execution-id>.csv 结尾,ID 将文件关联到刚执行的查询。下载为 summary.csv:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
查看本地内容:
cat summary.csv
表头和两条记录为:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
数值与 API 一致。这是实际下载的 S3 文件,不是手写报告。保留 summary.csv 及原 S3 输出,供下一步比较。
更正输入后重新计算
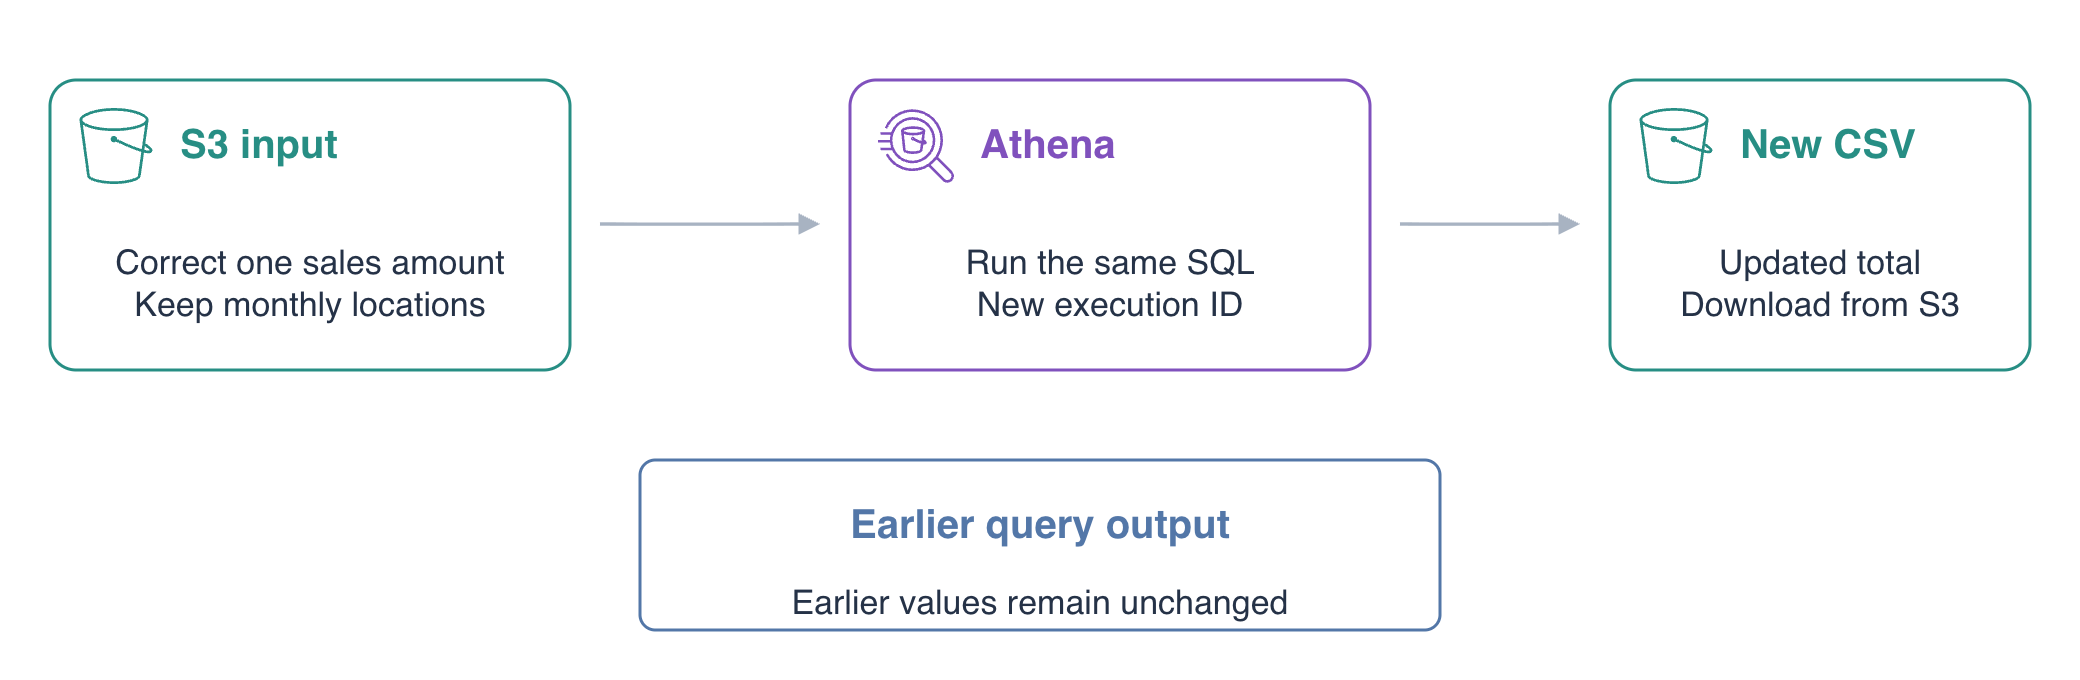
本步骤更正 September 的一笔金额,再执行相同 SQL。旧结果记录旧执行,不会随输入变化自动刷新;新执行必须读取当前输入才能更新总额。
查看提供的更正文件:
cat september-revised.csv
S01 从 1000 改为 1100 分,其余 September 记录不变,预计总额 3600。覆盖既有 September 对象,保留 October 和 reference/notes.txt:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
读回确认更正:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
末尾的 - 打印对象。位置和模式未变,原 Glue 分区仍适用。用相同 SQL 创建新执行:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
确认成功;排队或运行时重复状态命令,失败检查原因:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
读取行:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September 变为 3600 分/3 单,October 保持 2000 分/3 单,输入变化确实改变计算结果。
获取新执行自己的输出位置:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
下载到另一文件,不覆盖旧本地汇总:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
检查新 CSV:
cat summary-revised.csv
读回原 S3 输出进行对照:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
旧 September 总额仍为 3500。两个 ID 指向不同文件,分别描述旧输入和更正输入。AWS View 展示当前源及两次真实结果。本实验验证正确性,不测生产扫描费用或性能。
总结
你从已登记的 S3 数据计算月度总额,下载精确 Athena CSV,更正源值并重新计算。September 从 3500 变为 3600 分,October 保持 2000。旧结果保留旧值,因此输入变化后需要重新执行汇总。
进一步阅读 AWS 官方资料:按查询执行定位输出文件; SELECT 筛选、分组与排序。