介绍
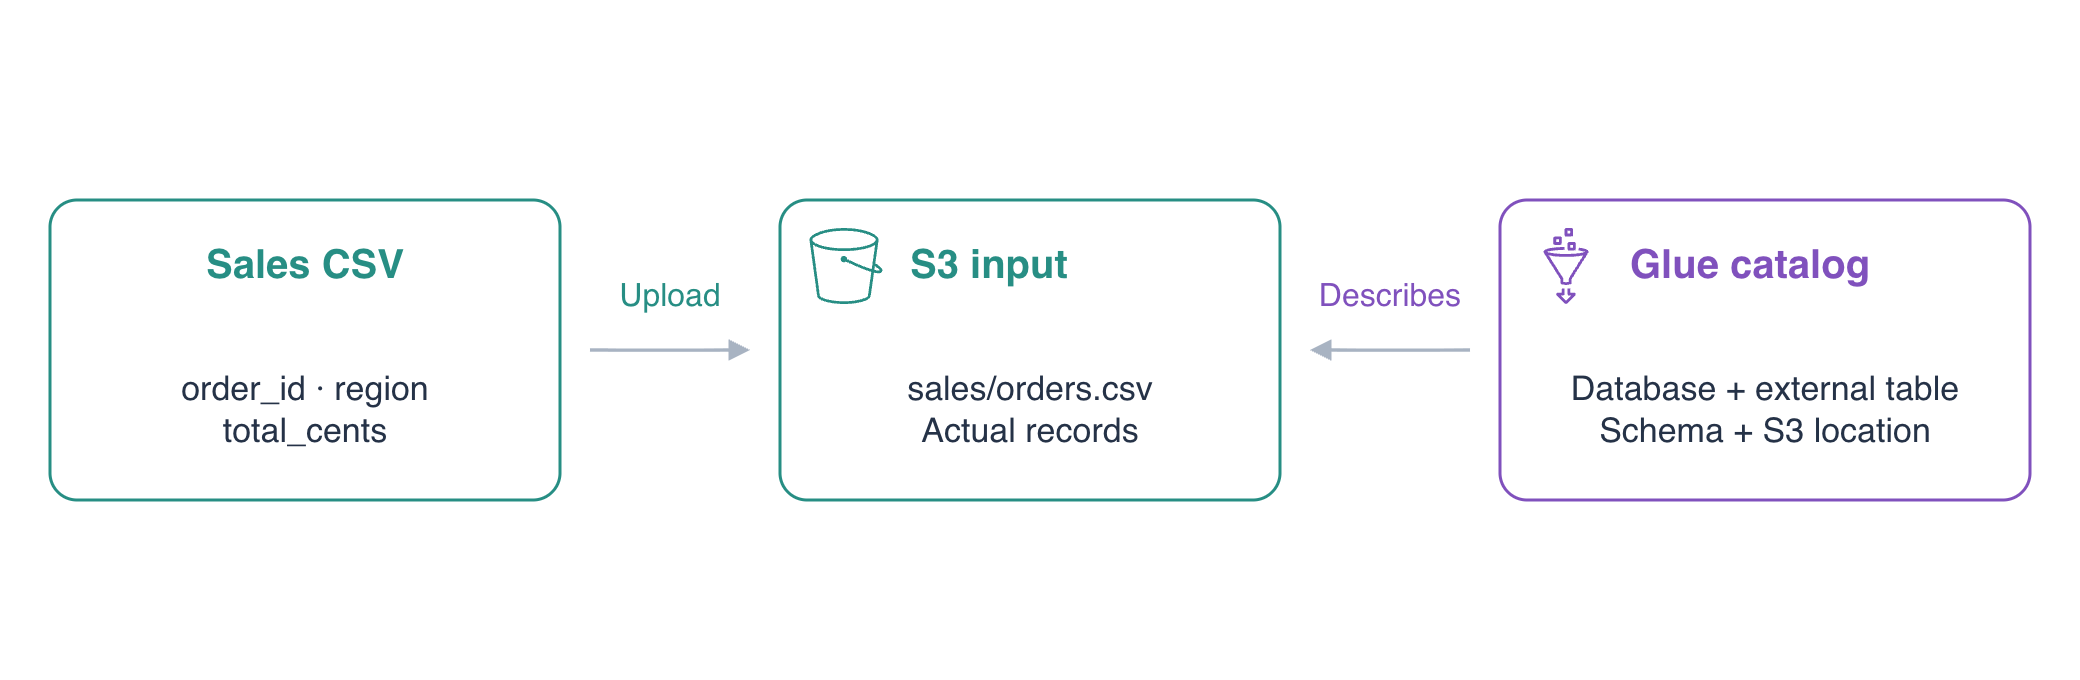
小商店将销售导出为 CSV,分析人员希望直接查询文件,而不将其复制到数据库服务器。把文件放入 Amazon S3,再用 AWS Glue Data Catalog 描述它。该元数据目录告诉查询服务数据在哪里、应如何读取。
先完成 AWS Foundations for Beginners,掌握基本 S3 对象操作及 IAM 身份知识。本独立环境提供空 S3 桶、CSV 文件和已配置的 AWS CLI 身份,无需个人 AWS 账户或另一实验的资源。使用 Terminal 执行命令,通过 AWS View 观察实际对象和目录项。目录仅描述文件,不复制、转换或查询内容;下一实验再使用 Athena。
认证考点
| 认证 | 考试任务 | 实践内容 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | 认识 Glue 在文件分析中的目录作用,并区分它与 S3 数据存储。 |
上传销售文件
本步骤检查提供的数据并上传到 S3。CSV 每行表示一条记录,字段以逗号分隔,第一行是字段名。模式描述字段名称、顺序及类型,让查询正确解释记录。
进入项目目录并确认已配置的身份:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN 以 labex-an01-operator 结尾;后续使用此身份的 S3 与 Glue 资源。查看 September 文件:
cat september.csv
三条记录的字段是 order_id、region 和 total_cents。前两列是字符串,最后一列是整数分金额。1000、2000、500 合计 3500 分。文件使用不加引号的普通值和一行表头。
新环境提供唯一命名的输入桶。jq -r 将 JSON 字段提取为文本,$(...) 将输出保存到变量。保存并显示桶名:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
上传到 sales/orders.csv。sales/ 前缀组织表将读取的数据:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
直接读回上传后的对象:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
末尾的 - 将 S3 对象打印到终端,表头及三条记录应与 september.csv 一致。打开 AWS View,展开对象并比较内容。无关对象 reference/notes.txt 位于 sales/ 外,保持不变。
创建目录数据库
本步骤创建容纳表定义的命名空间。Glue 数据库组织目录表,保存元数据而不运行数据库服务器;创建它不会移动 S3 文件。
从资源清单读取数据库名:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input 接受包含名称和描述的普通 JSON 定义:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
创建成功时不输出正文。读回数据库确认其存在:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
名称为 labex_sales,描述与你提供的一致。AWS View 显示数据库及尚无表的状态,S3 文件仍在原位置。
使用外部表描述文件
本步骤创建目录表,将每个 CSV 字段映射到具名类型,并指向实际 S3 前缀。外部表描述目录之外的数据;删除表定义本身不会删除 S3 对象。
存储描述符记录列、位置及文件读取配置。SerDe 是序列化器/反序列化器,将文件记录解释为表字段。LazySimpleSerDe 读取这里不加引号、逗号分隔的记录。表头不是销售记录,skip.header.line.count 指示跳过首行。
保存并显示表位置前缀:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF 将后面的文本写入 table.json,直到结束的 EOF。未加引号的分隔符会把 $SALES_LOCATION 展开为实际桶前缀:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys 为空,因为本表读取单个未分区前缀;后续再学习月分区。两个格式类描述文本输入和普通 Hive 兼容输出,无需自行安装或运行。
从 JSON 创建表,file:// 让 CLI 读取本地文件:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
从 Glue 读回定义:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
确认列顺序匹配 CSV 表头、total_cents 为 int、位置以 /sales/ 结尾、表头设置为 1。AWS View 并排显示 S3 对象及 Glue 定义。
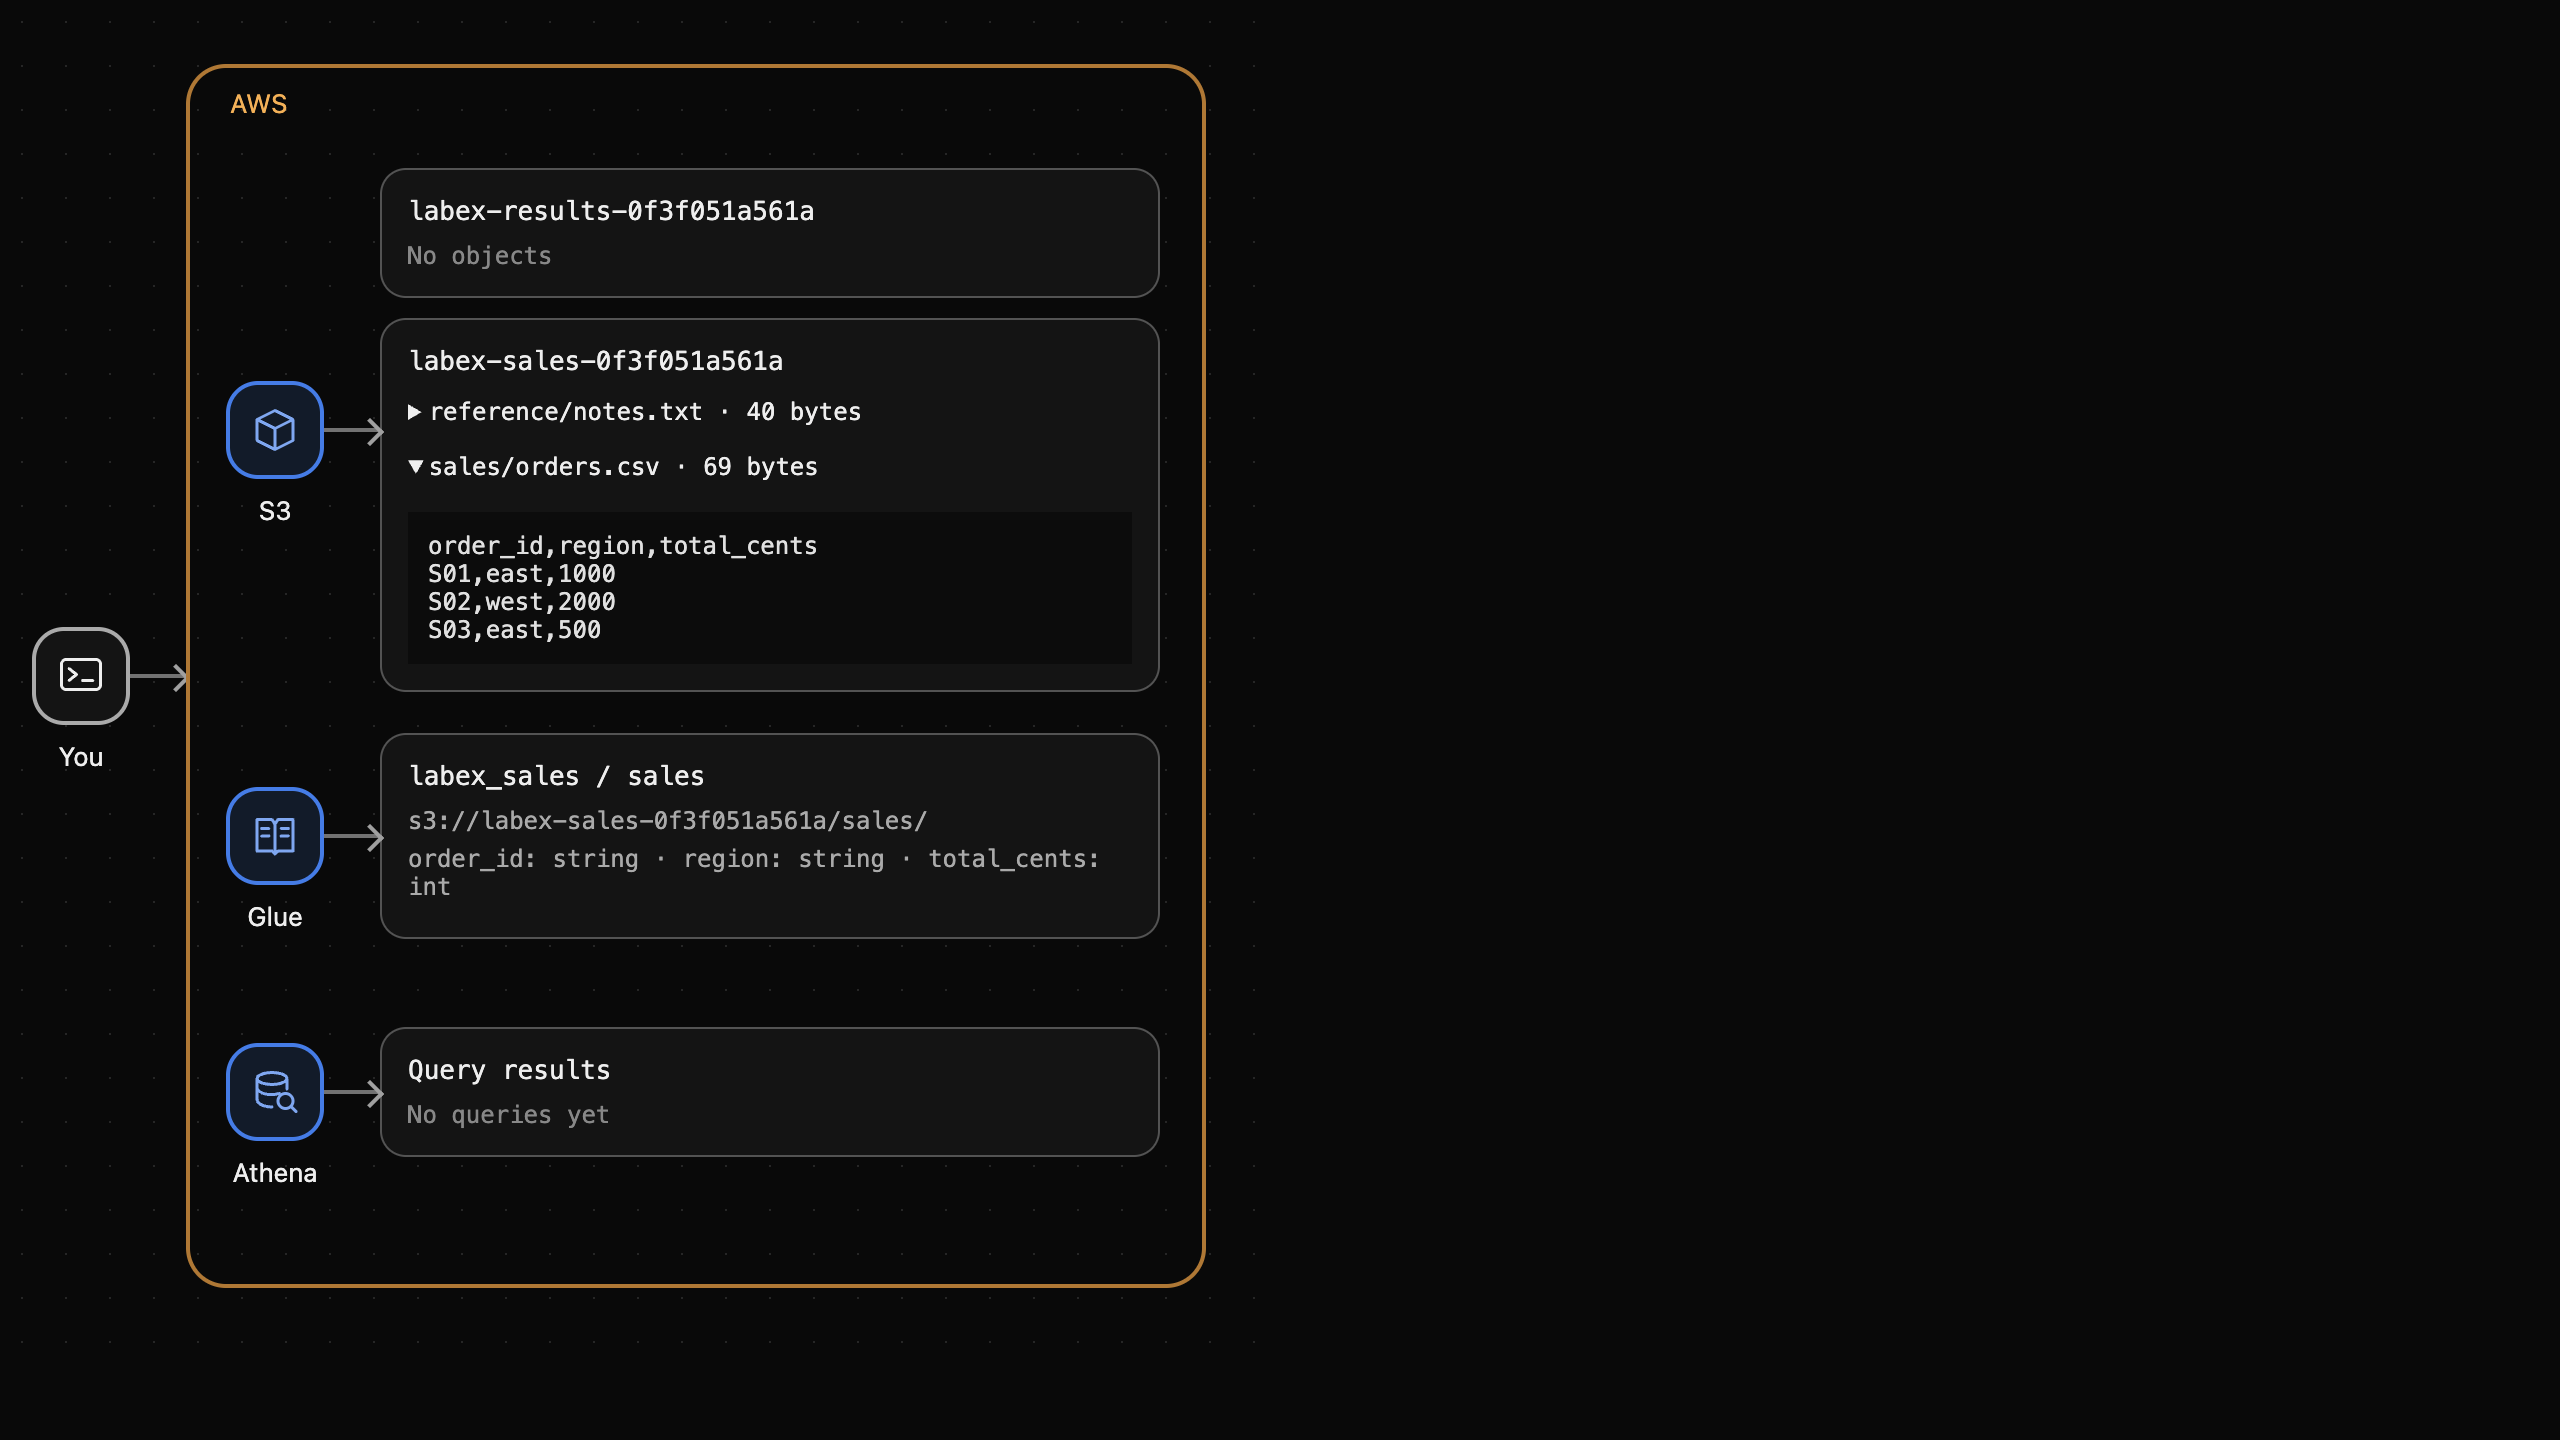
目录创建没有改变 CSV,也没有产生 Athena 结果。错误的模式或位置会导致后续查询失败或读取错误记录;现在匹配元数据可以建立正确基础。
总结
你上传了实际销售记录,创建 Glue 目录数据库,并定义列、CSV 格式、存储位置匹配的外部表。S3 保存数据,Glue 保存元数据。下一实验通过此目录模型,使用 Athena 查询独立准备的数据。
进一步阅读 AWS 官方资料:手动定义目录元数据; 无引号 CSV 字段与表头处理。