介绍
运维团队需要一个错误信号,在请求失败时触发,并在流量恢复正常后恢复。你将配置指标告警,观察实际请求引发的这两种状态变化,比较零值与缺失数据,并删除自己的告警。
请先完成 使用 CloudWatch 指标衡量应用健康,包括指标维度和 Sum。本实验提供全新的应用和指标序列。
认证考点
| 认证 | 考点 | 本实验练习 |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | 任务 1.1 | CloudWatch 告警求值、恢复与缺失数据。 |
| DevOps Engineer – Professional (DOP-C02) | 任务 4.2 | 基础练习:CloudWatch 告警求值、恢复与缺失数据。 |
| Solutions Architect – Professional (SAP-C02) | 任务 3.1 | 基础练习:CloudWatch 告警求值、恢复与缺失数据。 |
实验概览
配置指标告警
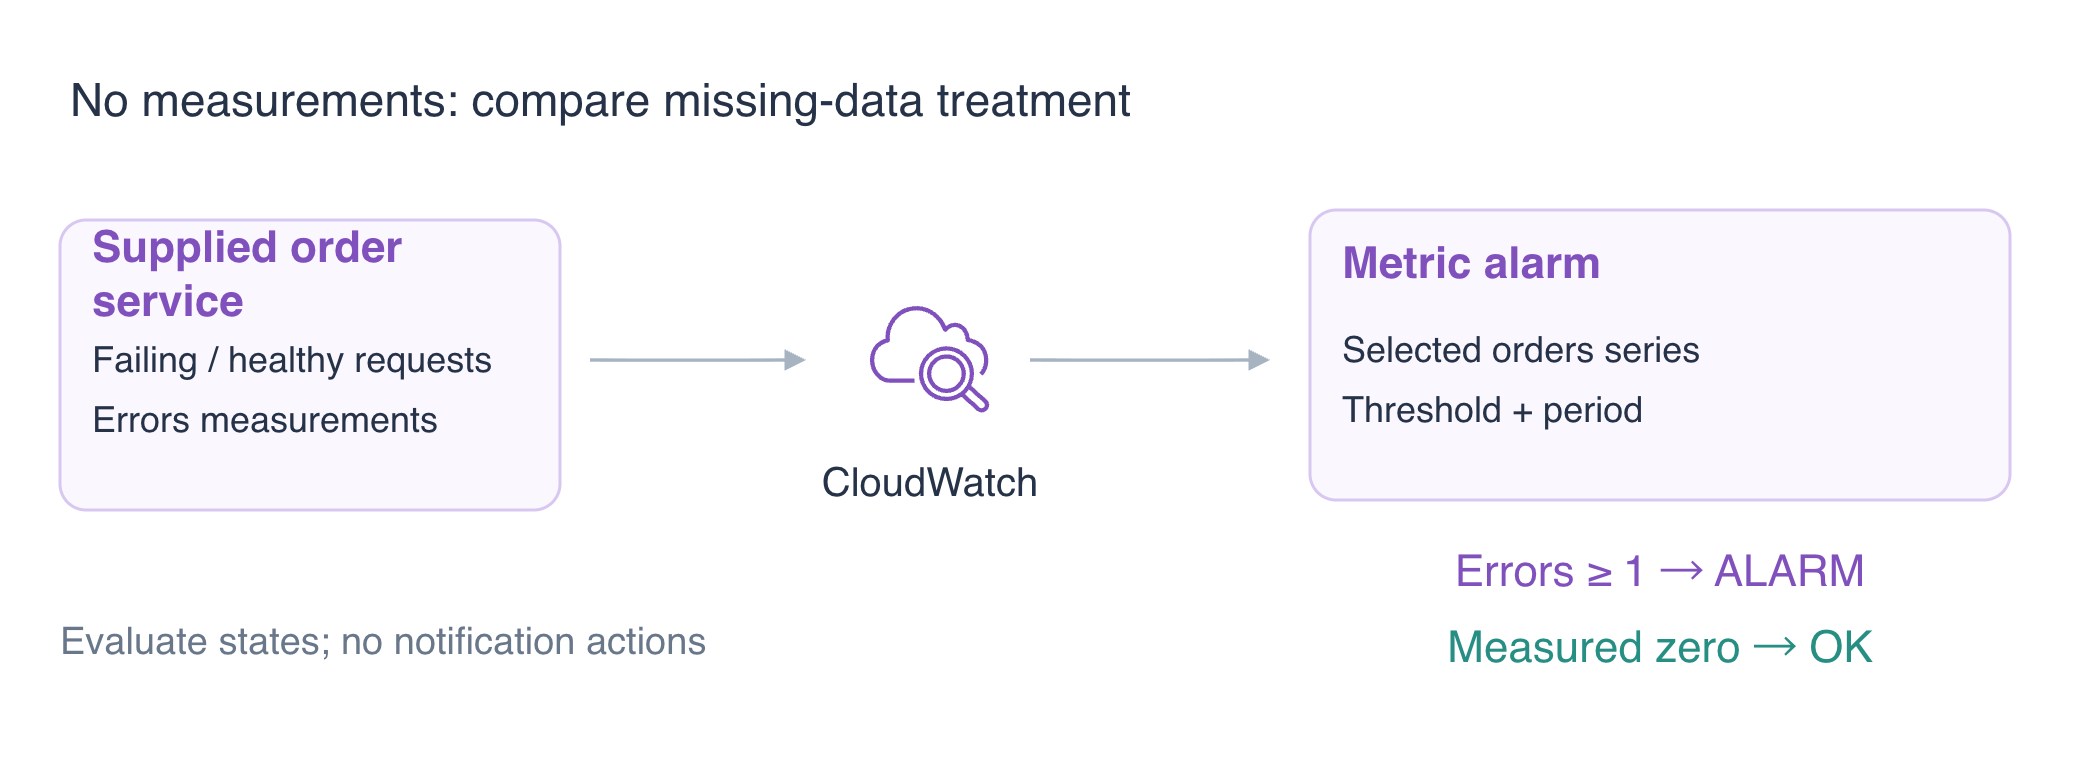
本步骤中,你将监控订单应用的服务端错误计数。告警将指标与阈值进行比较,并报告 OK、ALARM 或 INSUFFICIENT_DATA。只有配置了动作,告警才会发送通知;本实验专注于评估过程。
独立准备好的应用发布真实请求指标。HTTP 5xx 请求的 Errors 指标为 1,正常请求为 0。高分辨率发布支持 10 秒周期,让你能够快速观察多个周期。生产环境中的周期和阈值取决于工作负载与成本。
cd /home/labex/project
创建一个单指标告警。命名空间、名称和维度选择指标序列;Sum 统计每个已完成周期内的错误数。
告警评估一个已完成的 10 秒周期(--period 10、--evaluation-periods 1)。Sum 至少为 1 时达到阈值;GreaterThanOrEqualToThreshold 表示“大于或等于”。notBreaching 将没有测量值的周期视为未达到阈值。这会让空闲周期保持 OK,但不能证明应用健康。
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
使用下方命令读取告警。如果评估尚未完成,等待几秒,再重复这个读取命令,直到它报告 OK。
初始的 OK 来自缺失数据处理策略,而不是成功的健康检查。查看评估原因:
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
保持 /labex/o03-reference 不变。每个实验独立开始,不需要先前的指标数据。
通过真实失败触发告警
本步骤中,你将产生实际失败请求,并等待自动评估。已完成的周期不包含当前尚未完成周期内的数据点;观察 HTTP 响应和观察告警状态是两项独立操作。
提供的服务中,pear 不可用。这个循环每隔两秒发送一次请求,共九次,以跨越多个 10 秒周期。for 重复执行命令;sleep 2 在请求之间暂停。没有 -f 的 curl 即使收到 HTTP 503 也会返回响应体,使失败结果可见。
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
读取评估后的状态。如果尚未达到 ALARM,等待几秒,再重复这个命令。StateReasonData 是作为字符串存储的 JSON,因此响应中的引号会显示为转义形式;recentDatapoints 列出已评估周期的总和。
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
预期看到 ALARM,且 StateReasonData 中的 recentDatapoints 值至少为 1。如果评估仍显示较早的周期,等待几秒,再重复读取命令。状态随实际请求产生的数据点变化;不要手动设置告警状态。告警仅监控 orders,因此其他应用的序列不会参与这次评估。
对订单团队而言,ALARM 回答的是所选周期内是否发生服务器错误。它不能说明具体哪次请求失败或库存为何不可用。HTTP 响应证明业务请求失败,求值数据点证明告警状态变化,请求日志提供诊断细节。决定调查方向时,应分别阅读这些证据。
观察恢复与缺失数据
本步骤中,你将区分实际的零值与缺失的遥测数据。发送正常的 apple 请求,使已完成周期包含测得的 Errors=0。跨周期重复请求,可以避免将当前尚未完成的聚合时间段误认为已经恢复。
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
读取评估后的状态。如果尚未达到 OK,等待几秒,再重复这个命令。
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
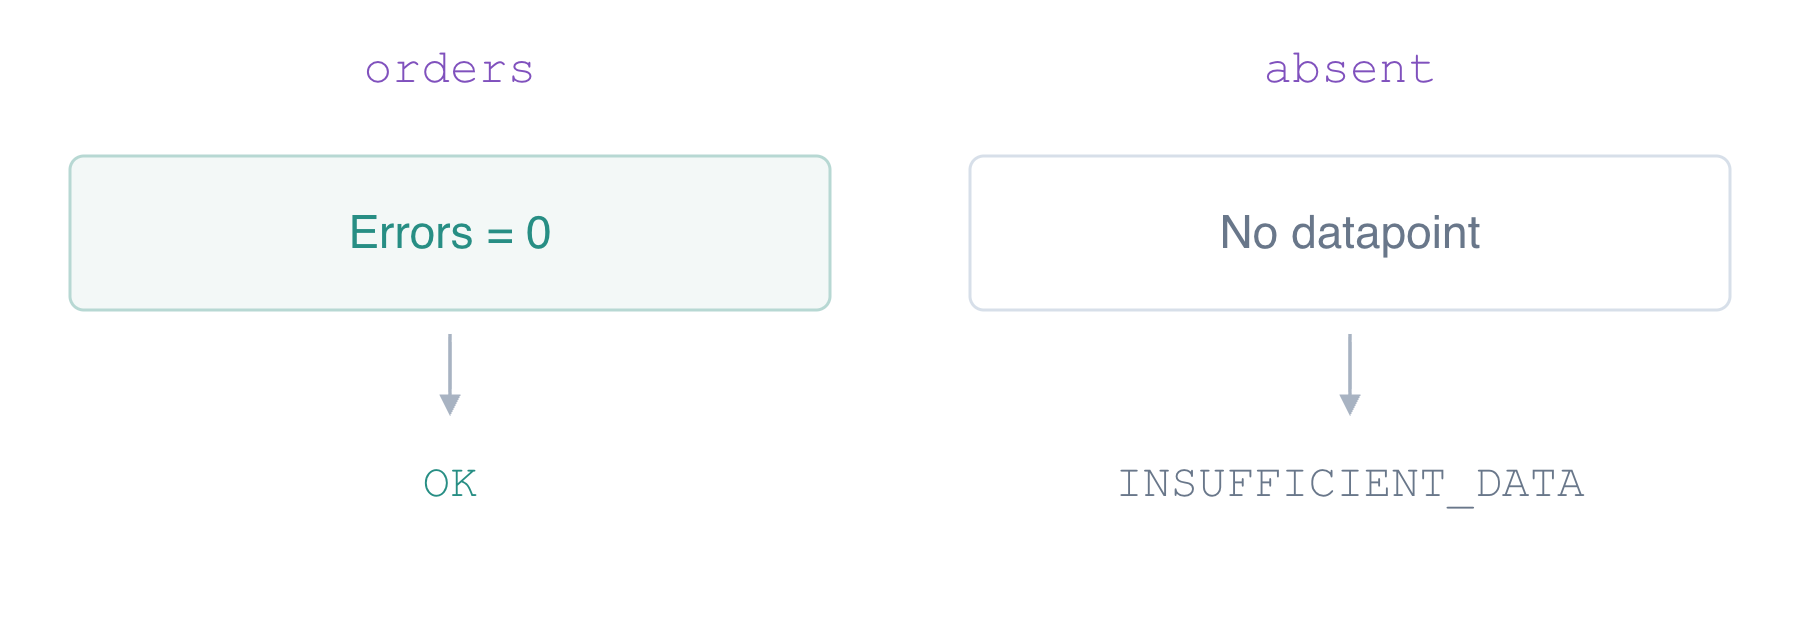
预期看到 OK 和 recentDatapoints: [0]。空列表表示缺少遥测数据,因此继续之前要确认测得的零值。
为 Application=absent 创建另一个告警,应用从不发布这个序列。将缺失数据视为缺失,而不是健康。
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
新告警应保持 INSUFFICIENT_DATA,因为它选择的序列没有测量值。
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
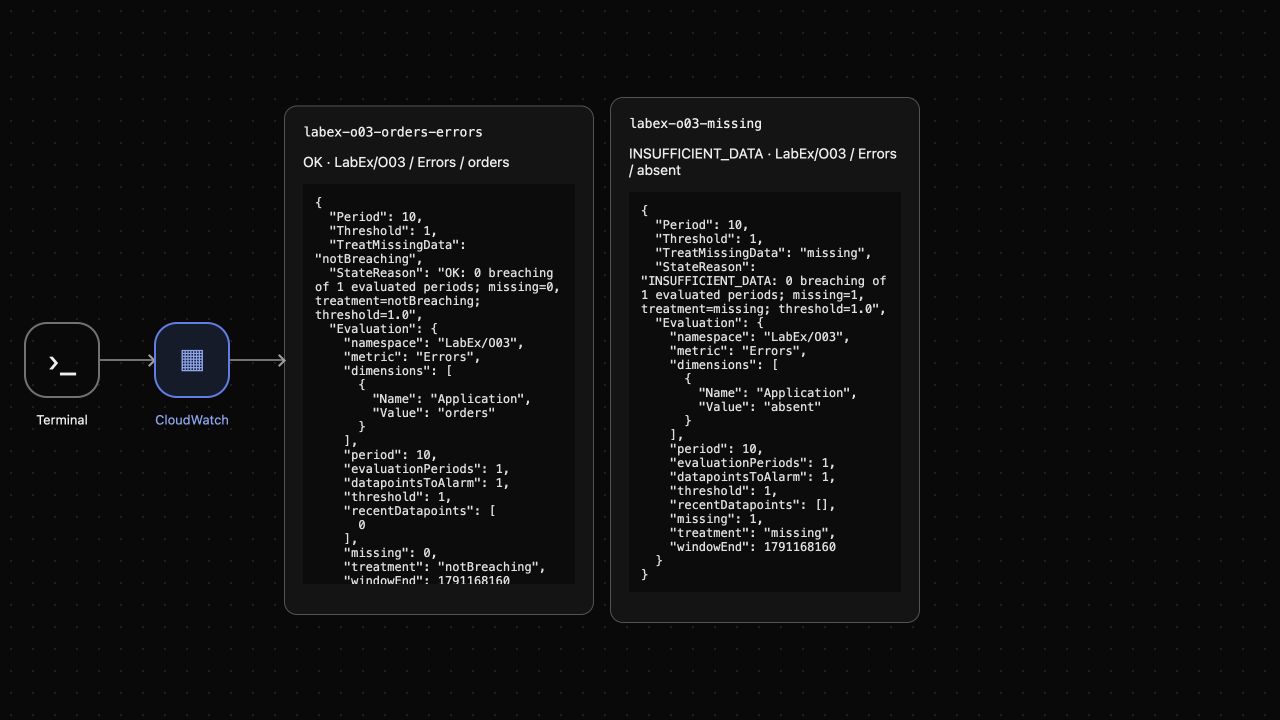
预期 orders 因测得的零值处于 OK,而 absent 处于 INSUFFICIENT_DATA。使用评估原因区分测得的零值与缺失的遥测数据。
AWS View 显示实际服务状态和参与评估的数据点。比较原因,不要把每个 OK 都视为应用健康的证明。
删除本实验的告警并停止发布
本步骤中,你将仅移除本实验的告警,并保留无关数据。清理之前禁用监测功能,让应用停止发布新数据点。
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
预期得到空的告警清单和 INFO platform reference keep unchanged。已有指标数据点会保留;CloudWatch 没有用于删除单个指标的显式 API。作者/平台随后清理这个临时环境。
总结
你配置了错误告警,观察了真实请求引发的自动触发和恢复,区分了测得的零值与缺失数据,并在保留参考日志的同时移除了本实验的告警。
进一步阅读 AWS 官方资料:指标告警与操作; 缺失数据时的告警求值。