



介绍
文档摘要命令需要为其 AI 依赖设置可预测的边界。你将为提供的应用添加有明确边界的 Bedrock 客户端,在推理前拒绝过长输入,并处理服务故障或慢响应而不暴露原始异常。
你应了解 Python 入门知识,以及上一引导式实验中的结构化输出验证。命令界面和响应解析器已经提供,让你专注于请求边界。这个 fresh VM 有自己的源文档、已配置身份和推理额度。
认证关联
| 认证 | 考试任务 | 练习内容 |
|---|---|---|
| AI Practitioner (AIF-C01) | 任务 3.1、3.2 | 限制推理输出,并在应用内处理生成的响应。 |
连接有明确边界的 Bedrock 客户端
本步骤中,你将实现提供的命令所调用的客户端,并生成实际结构化摘要。
先进入工作区:
cd /home/labex/project
读取源文档和命令选项:
cat incident.txt
/opt/labex/aws/venv/bin/python application.py --help
事件为 INC-204。application.py 读取文档并打印 JSON 结果。它调用 client.request_summary;提供的 response_parser.py 检查完成原因和此前练习的三个字符串字段。初始 client.py 报告工作未完成,不发送请求。
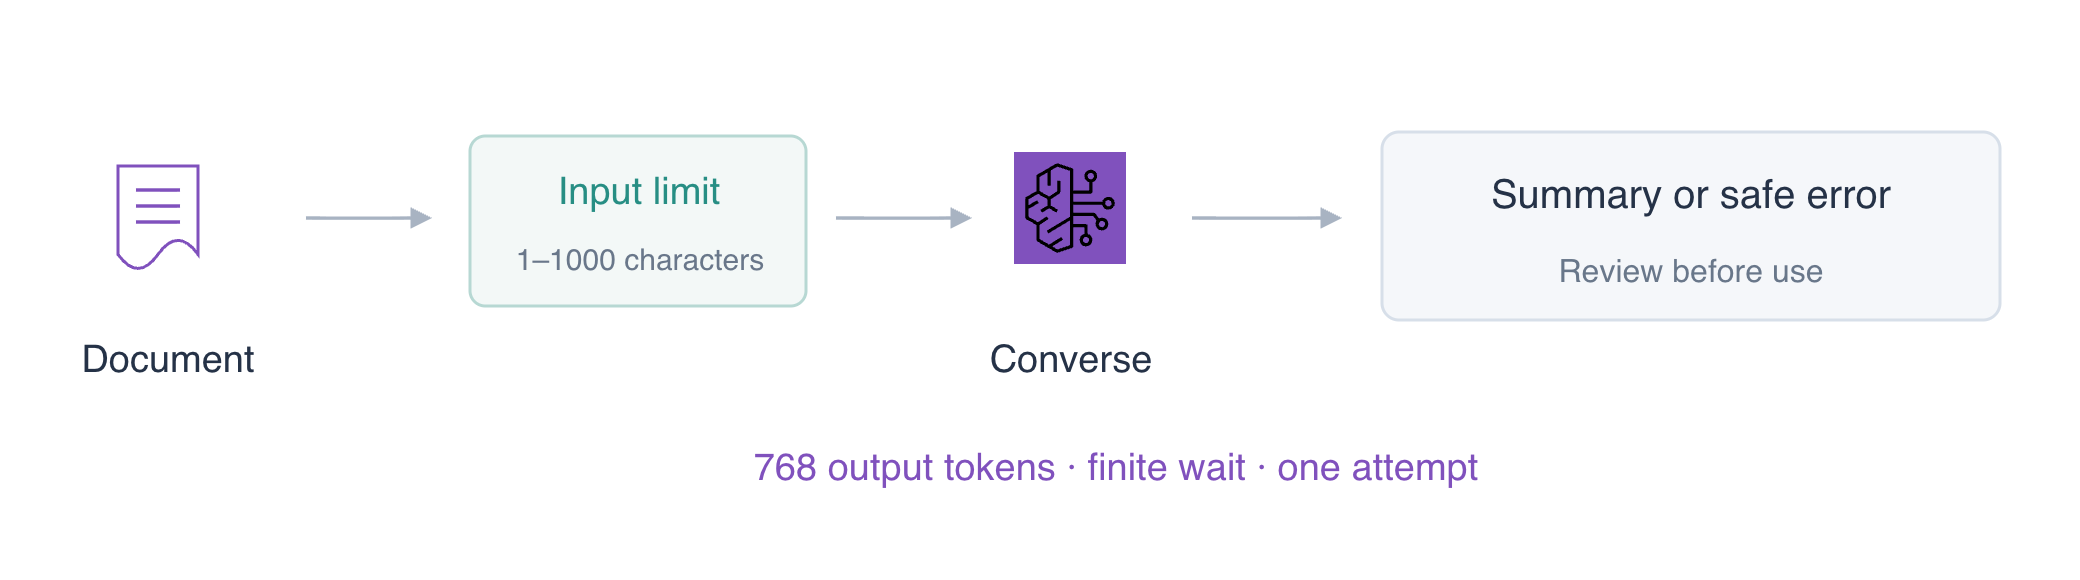
输入限额在消耗推理额度前保护应用。本示例接受长度为 1–1000 的非空文本,将模型输出上限固定为 768 token,并设置明确的 SDK 连接与读取超时。total_max_attempts: 1 表示只发送一次初始请求,不自动重试。读取超时限制连接上的等待,不保证每个应用操作都恰好在该时刻结束。
使用此实现替换初始客户端。ClientError 表示服务返回的错误响应;ReadTimeoutError 表示读取等待超时。两者都会变成简短的诊断 JSON 结果。结果不会包含原始异常、请求头或凭据:
cat > client.py <<'EOF'
import boto3
from botocore.config import Config
from botocore.exceptions import BotoCoreError, ClientError, ReadTimeoutError
from response_parser import summarize_response


def request_summary(document, endpoint_url, read_timeout):
    if not document.strip() or len(document) > 1000:
        return {'status': 'rejected', 'reason': 'input_limit'}
    client = boto3.client('bedrock-runtime', endpoint_url=endpoint_url,
        config=Config(proxies={}, connect_timeout=3, read_timeout=read_timeout,
                      retries={'total_max_attempts': 1}))
    try:
        response = client.converse(
            modelId='labex.text-v1:0',
            system=[{'text': 'Summarize only facts supplied in the incident document. Return exactly one JSON object with string fields incident_id, impact and next_action. No Markdown fences, extra keys or surrounding prose. Do not turn planned work into completed work.'}],
            messages=[{'role': 'user', 'content': [{'text': document}]}],
            inferenceConfig={'maxTokens': 768, 'temperature': 0})
    except ReadTimeoutError:
        return {'status': 'unavailable', 'reason': 'read_timeout'}
    except ClientError as error:
        code = error.response.get('Error', {}).get('Code')
        reason = 'busy' if code == 'ThrottlingException' else 'service_unavailable'
        return {'status': 'unavailable', 'reason': reason}
    except BotoCoreError:
        return {'status': 'unavailable', 'reason': 'connection_failed'}
    return summarize_response(response)
EOF
使用应用正常配置的 Bedrock 端点运行命令。> accepted.json 保存打印输出:
/opt/labex/aws/venv/bin/python application.py > accepted.json
读取结果:
cat accepted.json
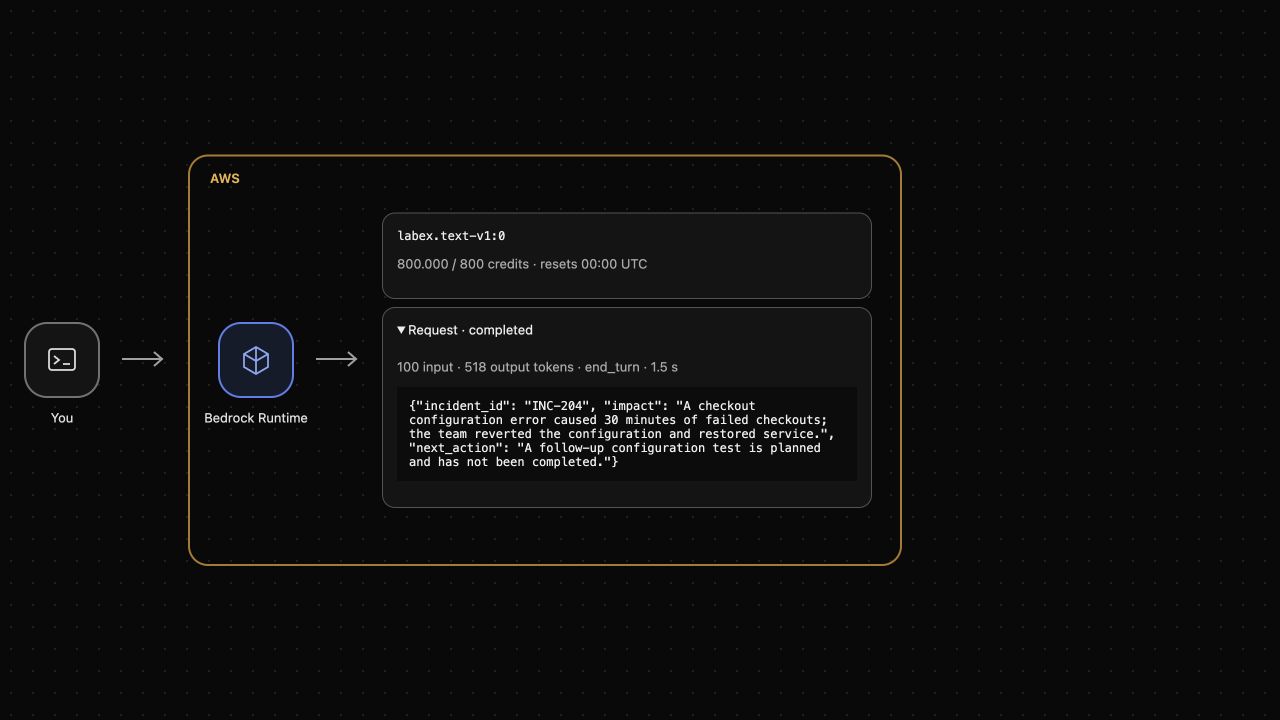
预期返回 status: ok 和三个摘要字段。根据文档审阅它们的含义。在上方 AWS View 中展开实际已完成请求并比较文本。输出上限限制生成 token,输入字符限额则是独立的应用策略。缓存响应可能复用实际模型输出,不产生新的 credits 扣减。
在推理前拒绝过长输入
本步骤中,你将确认客户端会拒绝超出输入预算的文档。
提供的 oversized.txt 包含超过 1000 个字符。wc -m 统计字符数:
wc -m oversized.txt
将该文件交给同一个应用处理:
/opt/labex/aws/venv/bin/python application.py --document oversized.txt > too-long.json
这一预期拒绝会以退出码 2 结束。echo $? 打印前一个命令的退出码:
echo $?
读取安全结果:
cat too-long.json
预期返回 status: rejected 和 reason: input_limit。客户端在构造推理请求前检查输入,因此 AWS View 仍应只有先前的已完成请求。拒绝输入防止新的模型消耗;删除结果文件并不能撤销此前的扣减。
处理服务故障和读取超时
本步骤中,你将使用两个明确的本地传输测试服务检查客户端错误边界。
下面的端点刻意返回服务错误或延迟响应。它们不发送模型请求,不消耗推理 credits。它们是测试依赖,不是替代的成功推理提供方。
使用端口 5001 上的服务不可用测试端点:
/opt/labex/aws/venv/bin/python application.py --endpoint-url http://127.0.0.1:5001 > unavailable.json
此预期失败以退出码 3 结束。查看其诊断结果:
cat unavailable.json
预期返回 status: unavailable 和 reason: service_unavailable,不包含堆栈、SDK 异常文本或凭据。
端口 5002 的测试服务等待三秒。将本次测试的读取超时改为一秒:
/opt/labex/aws/venv/bin/python application.py --endpoint-url http://127.0.0.1:5002 --read-timeout 1 > timed-out.json
读取结果:
cat timed-out.json
预期返回 status: unavailable 和 reason: read_timeout。SDK 只发送一次尝试。超时不能证明上游模型请求已取消或不收费:客户端停止等待后,真实上游仍可能完成。重试前查看等待中或失败的请求以及额度;不要添加无条件重试循环。
AWS View 仍应只有步骤 1 中的实际请求。正常命令的 150 秒读取超时是本练习采用的有限值;真实应用应根据延迟预算选择超时、重试策略和用户反馈。官方 Config 参考解释了独立的连接与读取超时及尝试次数控制。
删除测试输出并保留工作应用
本步骤中,你将清理四个本地结果文件,并保留能工作的客户端及提供的应用。
清理前应通过功能和失败检查。只删除指定输出:
rm accepted.json too-long.json unavailable.json timed-out.json
列出剩余文件:
ls
保留 application.py、client.py、response_parser.py、文档和测试样例。Converse 没有创建持久云工作负载;删除本地输出不会恢复 credits。应用源码会保留至此 VM 结束,供你继续练习。
总结
你为提供的摘要命令接入了实际 Bedrock 请求,限制输入和生成输出,禁用自动重试,并配置有限的连接与读取等待。你测试了服务故障和超时,没有用预设的成功推理替代正常路径;返回了安全诊断结果,并只删除本地测试输出。


