Введение
Магазин хранит продажи по месяцам. September уже зарегистрирован; новый файл October находится локально. Загрузите его в месячный префикс S3, зарегистрируйте раздел Glue и запросите новый месяц и оба месяца в Athena.
Сначала завершите Query S3 Data with Athena. Независимая среда содержит таблицу sales с разделами, September и его регистрацию, новый CSV и настроенную AWS-идентичность. Личный аккаунт и ресурсы прежней VM не нужны. Используйте обычные команды S3/Glue/Athena в Terminal, сравнивайте файлы, разделы и реальные результаты в AWS View.
Связь с сертификацией
| Сертификация | Задача экзамена | Практика |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Объяснить, как метаданные Glue открывают разделённые данные S3 для аналитики Athena. |
Добавить файл нового месяца
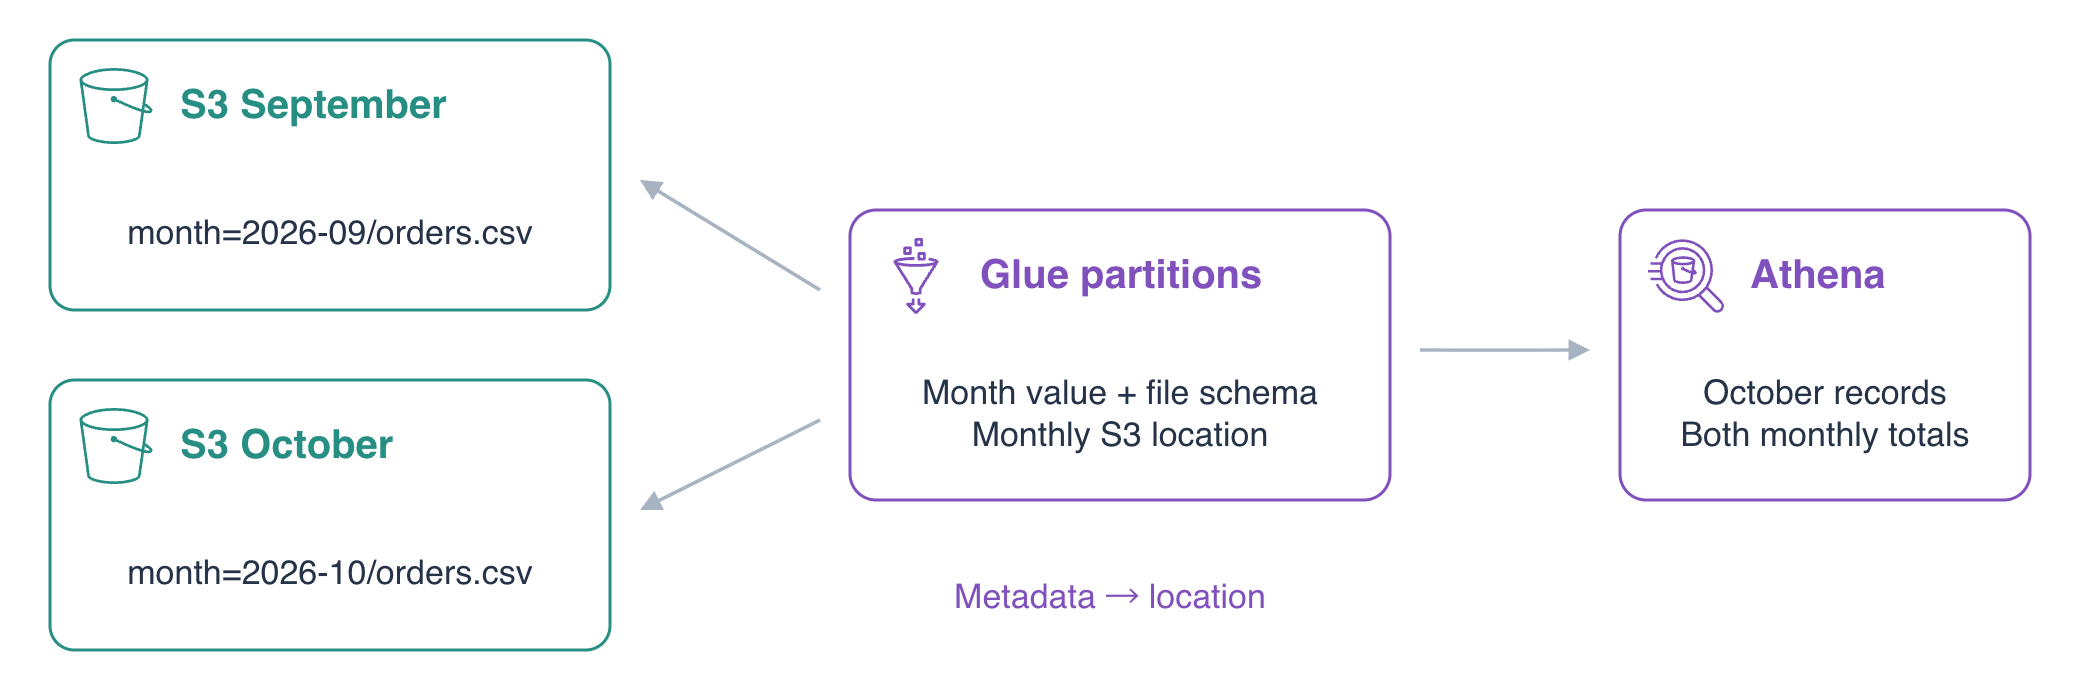
На этом шаге загрузите October, сохранив September. Раздел группирует данные по ключу, например месяцу. sales/month=2026-09/ содержит September, sales/month=2026-10/ предназначен для October. key=value показывает группировку, но загрузка не регистрирует раздел автоматически.
Перейдите в проект и проверьте идентичность:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN заканчивается на labex-an03-operator. jq -r извлекает текст JSON, $(...) сохраняет вывод в переменных:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive включает вложенные префиксы:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
Должен быть sales/month=2026-09/orders.csv. Суммы September — 1000, 2000 и 500 центов, всего 3500. Сохраните файл и reference/notes.txt. Проверьте October:
cat october.csv
O01/east/700, O02/west/900, O03/east/400 — три заказа на 2000 центов с теми же тремя столбцами. Загрузите в отдельный префикс:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
Прочитайте реальный объект обратно:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
Последний - выводит содержимое. AWS View показывает два файла S3, но только раздел September в Glue. Появление файла и регистрация различаются.
Зарегистрировать October в каталоге
На этом шаге покажите недостаточность загрузки и добавьте метаданные. Раздел связывает значение ключа с путём S3 и схемой. Строковый month — ключ раздела. CSV содержит только order_id, region, total_cents; значение month в запросе берётся из определения.
Проверьте ключ:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
Это month типа string. До регистрации посчитайте записи. COUNT(*) считает совпадения; кавычки разделителя heredoc сохраняют SQL:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
Отправьте с готовыми базой и выходным префиксом, выведите ID:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
Повторяйте при QUEUED или RUNNING, продолжайте при SUCCEEDED, при ошибке читайте Reason:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Прочитайте результат:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Число равно 0, хотя файл есть. Таблица читает зарегистрированные пути; имя директории не создаёт метаданные.
Повторно используйте дескриптор хранения для тех же столбцов и CSV-формата. > записывает JSON в файл:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg передаёт реальный путь строкой; .Location = $location заменяет расположение на October. Values задаёт значение единственного ключа:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
Проверьте обычный JSON:
cat october-partition.json
Убедитесь в 2026-10 внутри Values, соответствии столбцов и окончании /sales/month=2026-10/. Скобки ${SALES_LOCATION} отделяют переменную от суффикса. file:// читает локальный JSON для регистрации:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
Выведите оба раздела:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Каждый месяц указывает на свой префикс; AWS View показывает обе связи. Меняются только метаданные, CSV не копируются и не переписываются.
Запросить новый месяц и оба итога
На этом шаге докажите доступность October и правильность September. WHERE по ключу выбирает месяц. Проверяются записи, а не стоимость сканирования или скорость в облаке.
Запишите запрос October:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
Отправьте новое выполнение: регистрация не переписывает прежний нулевой результат:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
Проверьте состояние, повторяйте при ожидании, продолжайте после успеха и изучайте ошибки:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Прочитайте строки:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
После заголовка идут O01/700, O02/900, O03/400. Тот же ранее невидимый файл теперь даёт три записи.
SUM складывает центы, COUNT(*) считает заказы в каждой группе GROUP BY month:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Отправьте и выведите отдельный ID:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
Подтвердите успех, повторяйте состояние при необходимости и проверяйте причины ошибок:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Прочитайте группы:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September — 3500 центов/3 заказа, October — 2000/3. Первый месяц не изменился. Сравните пути Glue, SQL и строки в AWS View.
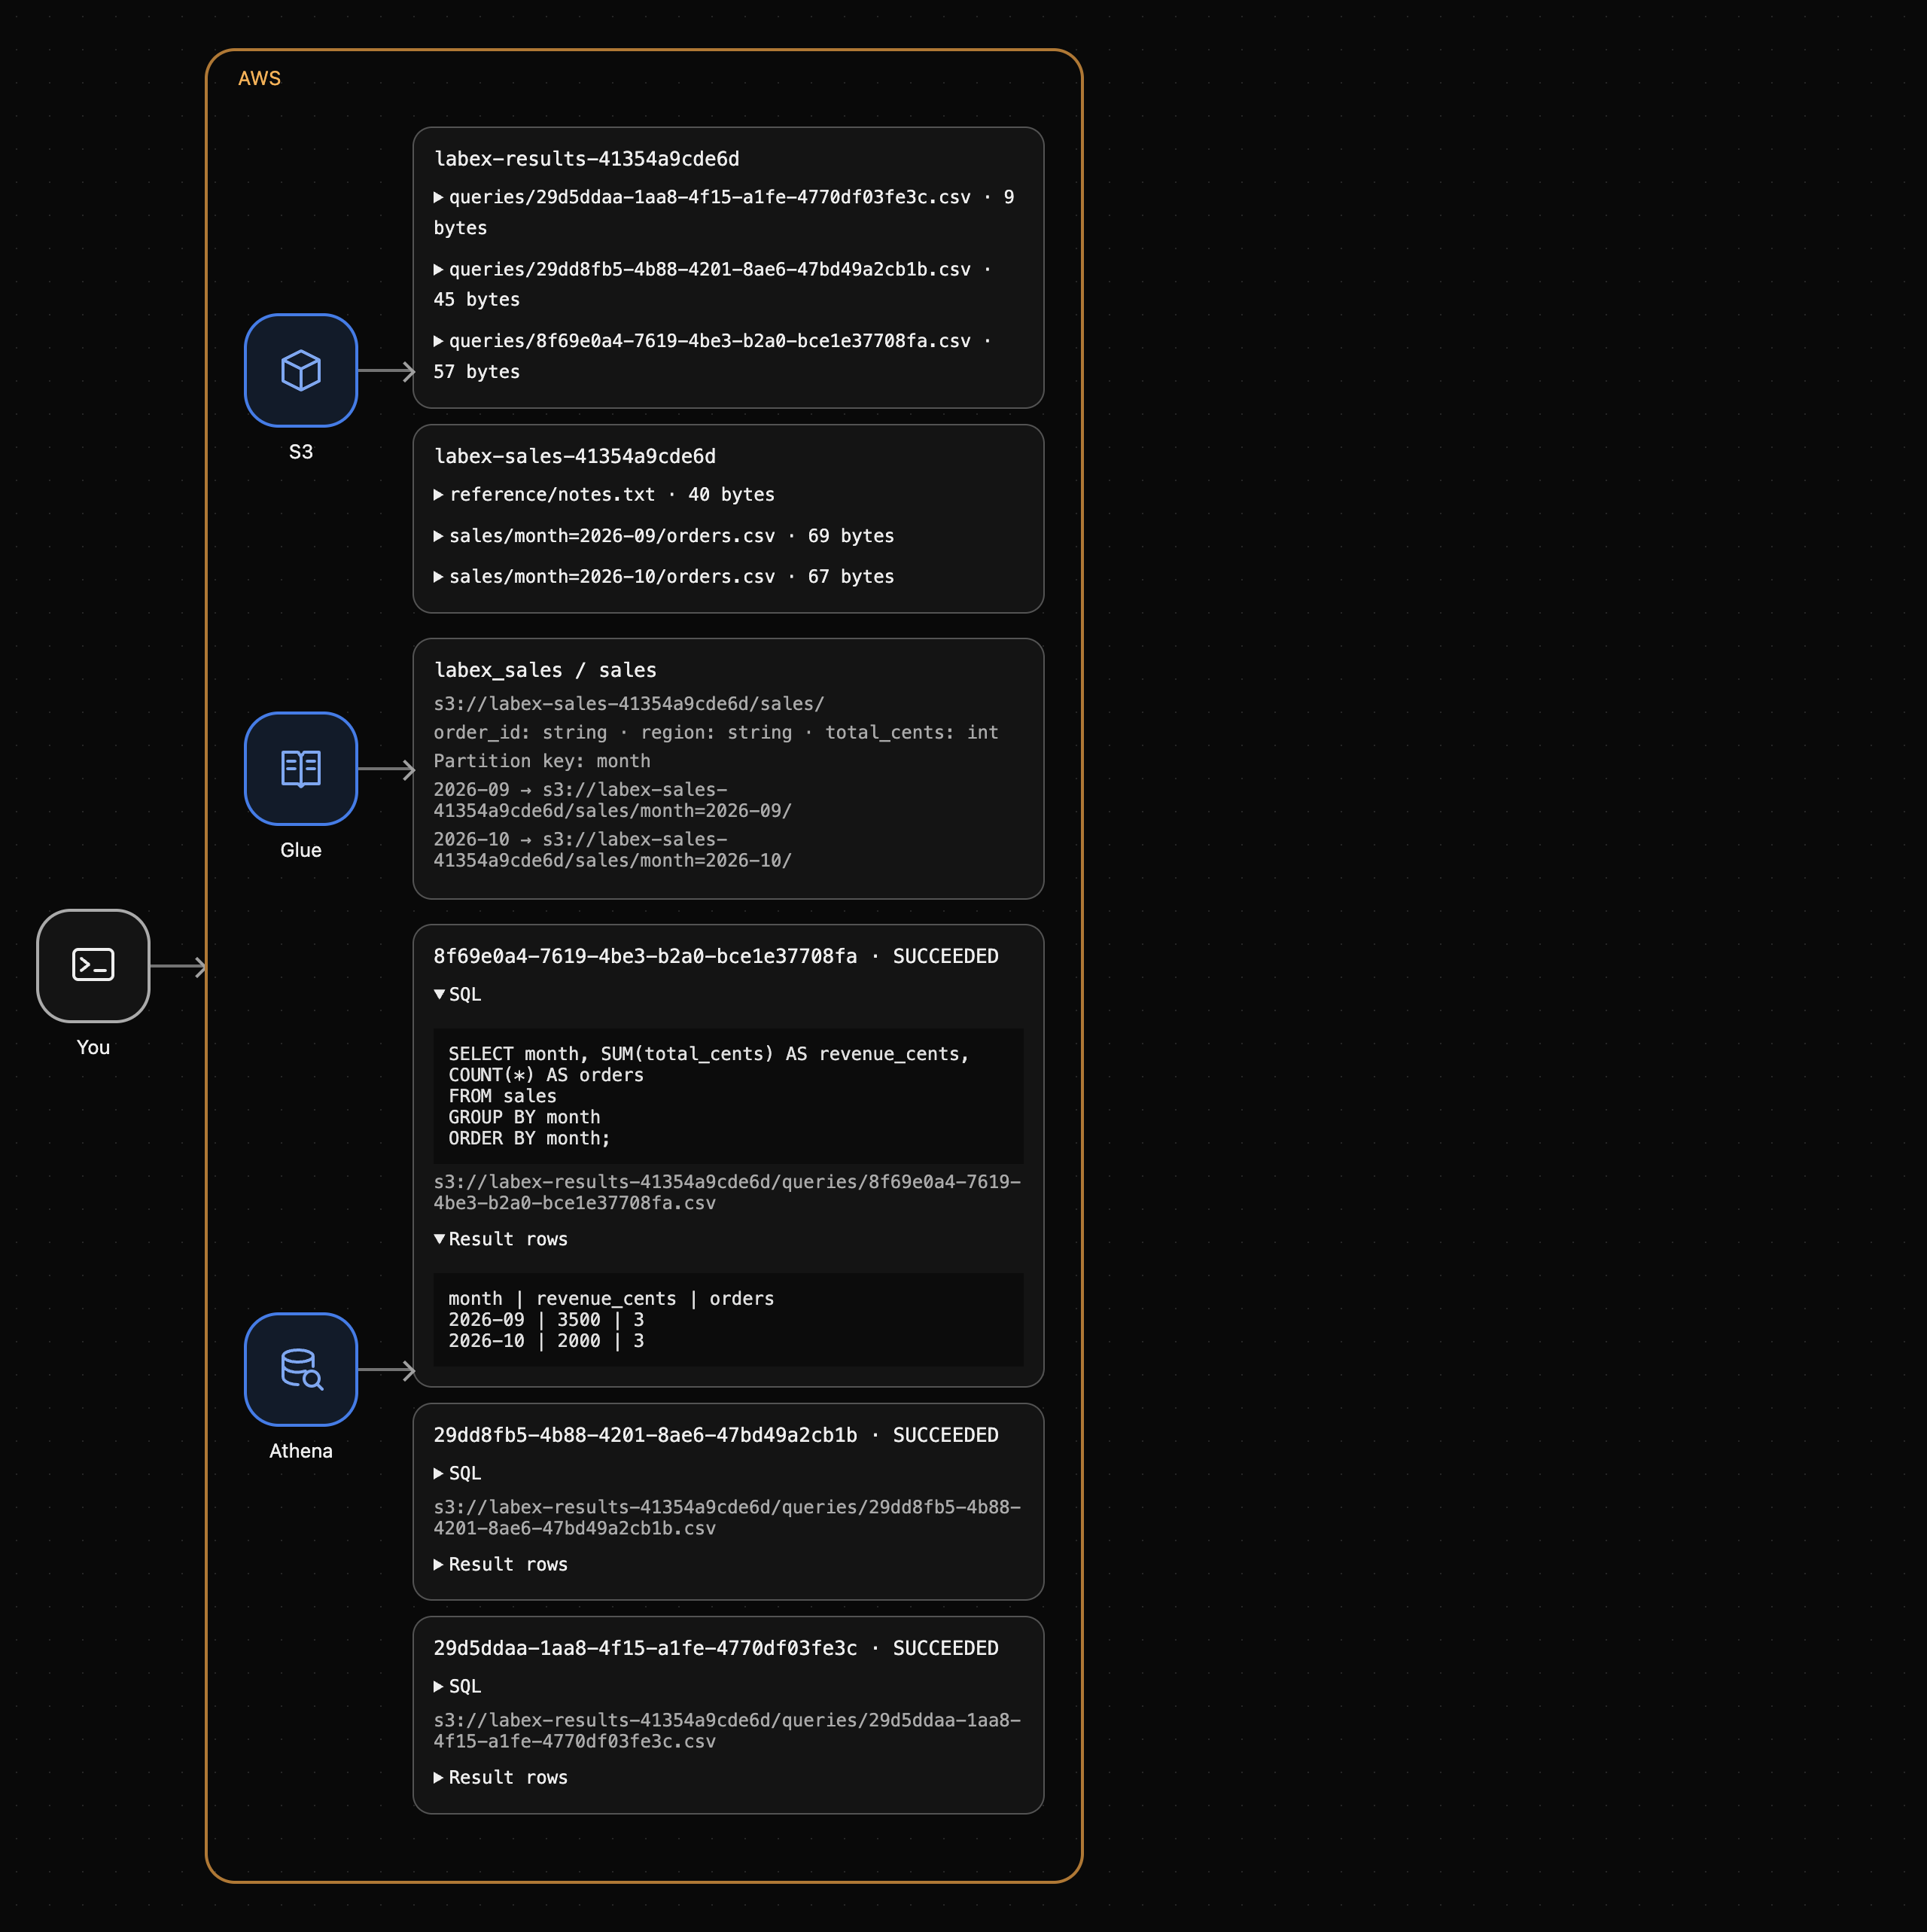
Прежний нулевой результат остаётся отдельным выводом предыдущего состояния каталога.
Резюме
Вы загрузили месячный CSV, увидели отсутствие строк без регистрации, зарегистрировали путь и схему Glue и проверили October и оба итога. Файлы и метаданные различаются: таблице нужна регистрация нового префикса. Далее реальные результаты станут повторно используемым файлом сводки.
Подробнее см. в документации AWS: Ключи, расположения и регистрация разделов.