Введение
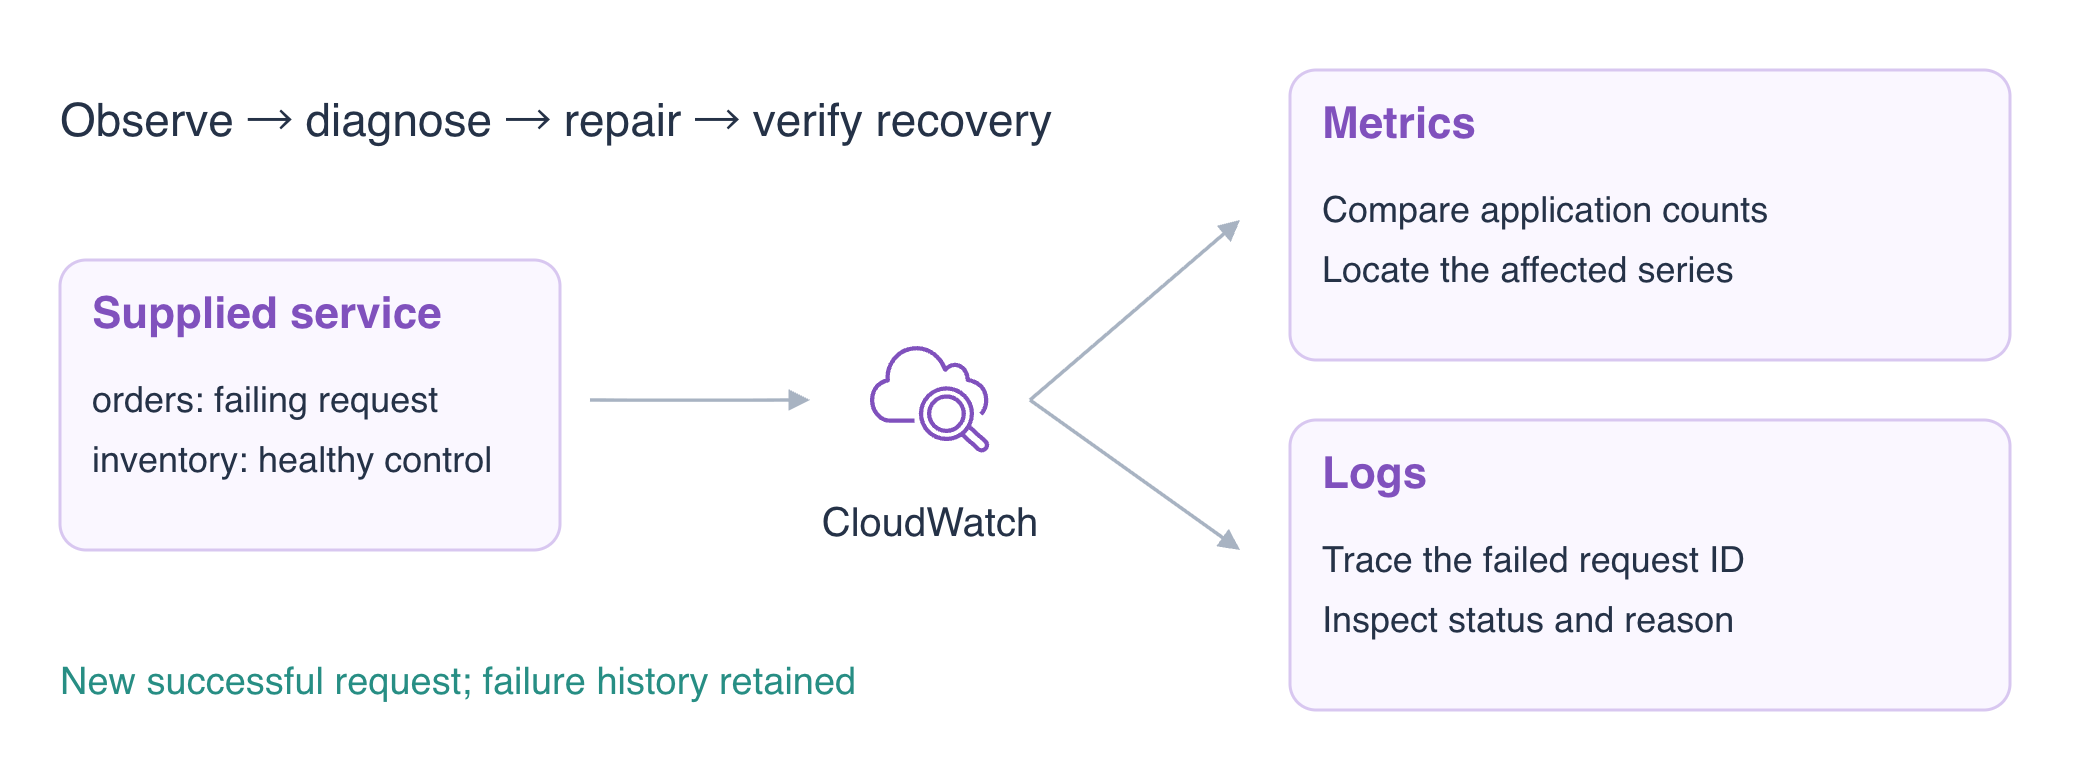
Допустимые заказы завершаются с ошибкой, тогда как запрос inventory выполняется успешно. Вы сравните метрики приложений, проследите неудачный запрос в журналах, исправите небольшую ошибку конфигурации и подтвердите восстановление, не стирая историю сбоев.
Сначала выполните Поиск неудачного запроса в CloudWatch Logs и Измерение состояния приложения с помощью метрик CloudWatch. Эта работа предоставляет своё приложение и свой инцидент.
Связь с сертификацией
| Сертификация | Задача экзамена | Практика |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Задача 1.2 | Диагностика сбоев приложения по журналам и метрикам. |
| Developer – Associate (DVA-C02) | Задача 4.1 | Диагностика сбоев приложения по журналам и метрикам. |
| DevOps Engineer – Professional (DOP-C02) | Задача 5.3 | Базовая практика: Диагностика сбоев приложения по журналам и метрикам. |
| Solutions Architect – Professional (SAP-C02) | Задача 3.1 | Базовая практика: Диагностика сбоев приложения по журналам и метрикам. |
| Data Engineer – Associate (DEA-C01) | Задача 3.3 | Базовая практика: Диагностика сбоев приложения по журналам и метрикам. |
Обзор лабораторной работы
Воспроизведите инцидент и сравните контрольный запрос
На этом шаге вы воспроизведёте допустимый запрос заказа, который неожиданно завершается с ошибкой. В независимо подготовленном сервисе есть обычная ошибка конфигурации. Его журналы и метрики изначально пусты, поэтому наблюдения будут получены из ваших собственных запросов.
cd /home/labex/project
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-failure-1' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-failure-2' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-control' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/inventory
Ожидайте два ответа orders HTTP 503 stock_unavailable и ответ inventory HTTP 200 accepted для одного и того же допустимого синтетического запроса apple. Контрольный запрос указывает на проблему, специфичную для orders; он не доказывает исправность всей системы.
Используйте недавнее окно UTC и точные измерения Application для сравнения числа серверных ошибок. Метрика обобщает частоту, а отдельные журналы могут объяснить конкретный ответ.
START=$(date -u -d '15 minutes ago' +%Y-%m-%dT%H:%M:%SZ)
echo "$START"
Сохраните время окончания интервала запроса в UTC:
END=$(date -u -d '1 minute' +%Y-%m-%dT%H:%M:%SZ)
echo "$END"
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=inventory \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
Ожидайте суммарное Sum 2 для orders и Sum 0 для inventory по возвращённым интервалам. Сохраните /labex/o05-reference неизменной.
Свяжите счётчик ошибок с журналами запросов
На этом шаге вы свяжете обобщённый симптом с конкретными неудачными запросами. Сначала найдите ERROR, затем точный идентификатор запроса. Фраза в кавычках сопоставляется с полным токеном request_id; это предотвращает смешивание запросов с похожими именами.
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern ERROR \
  --query 'events[].{Time:timestamp,Message:message}'
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern '"request_id=o05-failure-1"' \
  --query 'events[].message'
Оба сбоя указывают application=orders, status 503 и reason stock_unavailable. Метрики и журналы охватывают одни и те же запросы в недавнем окне. Изучите настройки приложения, чтобы найти несоответствие допустимому запросу apple.
cat app.json
Для orders accepted_sku равно pear. Inventory независимо использует ожидаемую настройку apple. Это небольшая ошибка конфигурации; замена сервиса или отключение наблюдения скрыли бы симптом, не исправив его.
В неудачном запросе указан apple, а настройка orders принимает pear. Это несоответствие даёт проверяемое объяснение stock_unavailable; успешный запрос inventory помогает сузить область поиска. Следующий шаг проверяет это объяснение изменением настройки orders и повторным корректным запросом. Восстановление подтверждают успешный ответ и соответствующая новая запись журнала, а не только правка конфигурации.
Исправьте настройку и проверьте восстановление
На этом шаге вы измените допустимый SKU и докажете восстановление бизнес-ответа при включённой телеметрии. Замените обычную конфигурацию исправленной настройкой.
cat > app.json <<'JSON'
{"logging": {"enabled": true, "group": "/labex/o05-application", "stream": "requests"}, "metrics": {"enabled": true, "namespace": "LabEx/O05"}, "accepted_sku": "apple"}
JSON
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-recovered' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern '"request_id=o05-recovered"' \
  --query 'events[].message'
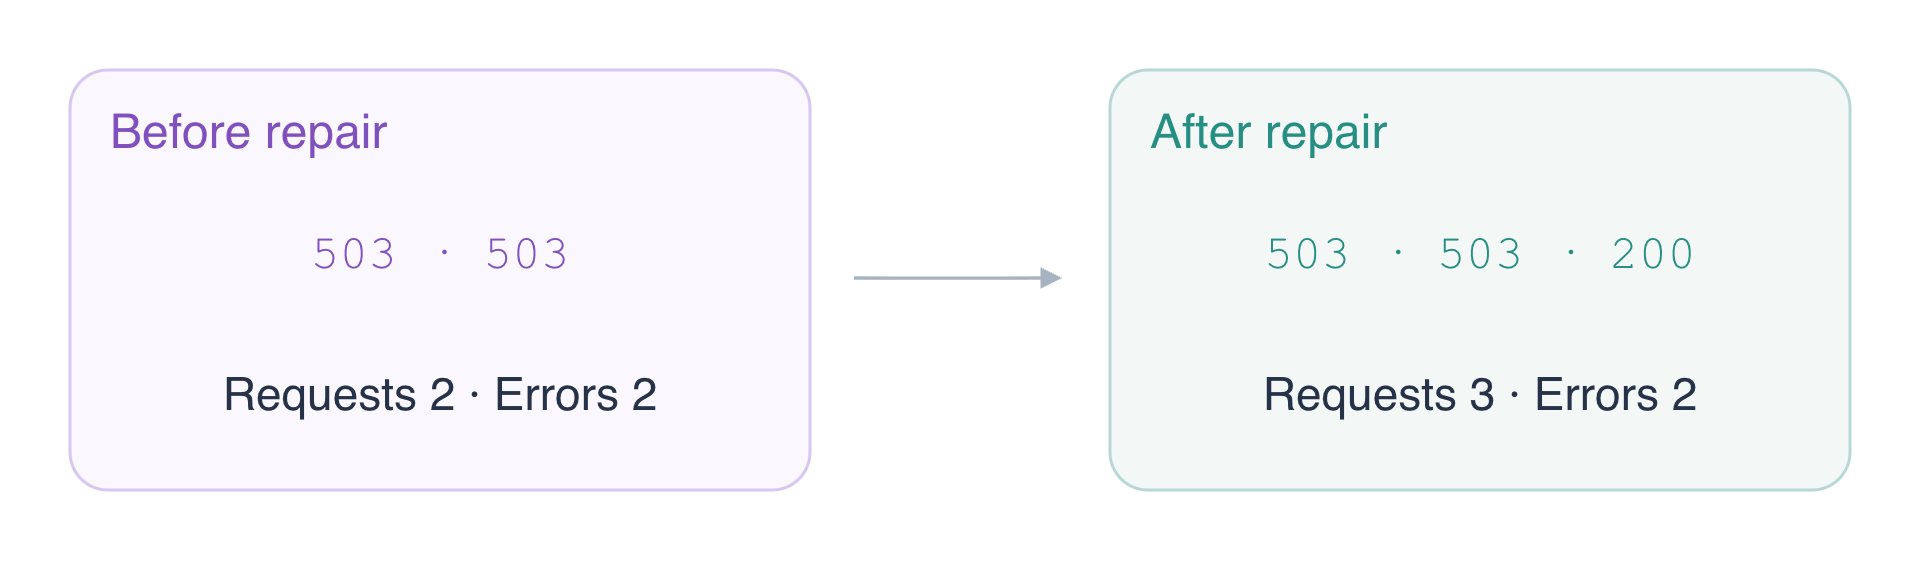
Ожидайте HTTP 200 accepted и журнал INFO с тем же идентификатором восстановленного запроса. Прежние сбои остаются в окне. Успешный запрос публикует Errors=0, поэтому накопленная сумма ошибок Sum остаётся равной 2, а Requests увеличивается до 3.
START=$(date -u -d '15 minutes ago' +%Y-%m-%dT%H:%M:%SZ)
echo "$START"
Сохраните время окончания интервала запроса в UTC:
END=$(date -u -d '1 minute' +%Y-%m-%dT%H:%M:%SZ)
echo "$END"
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Requests \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
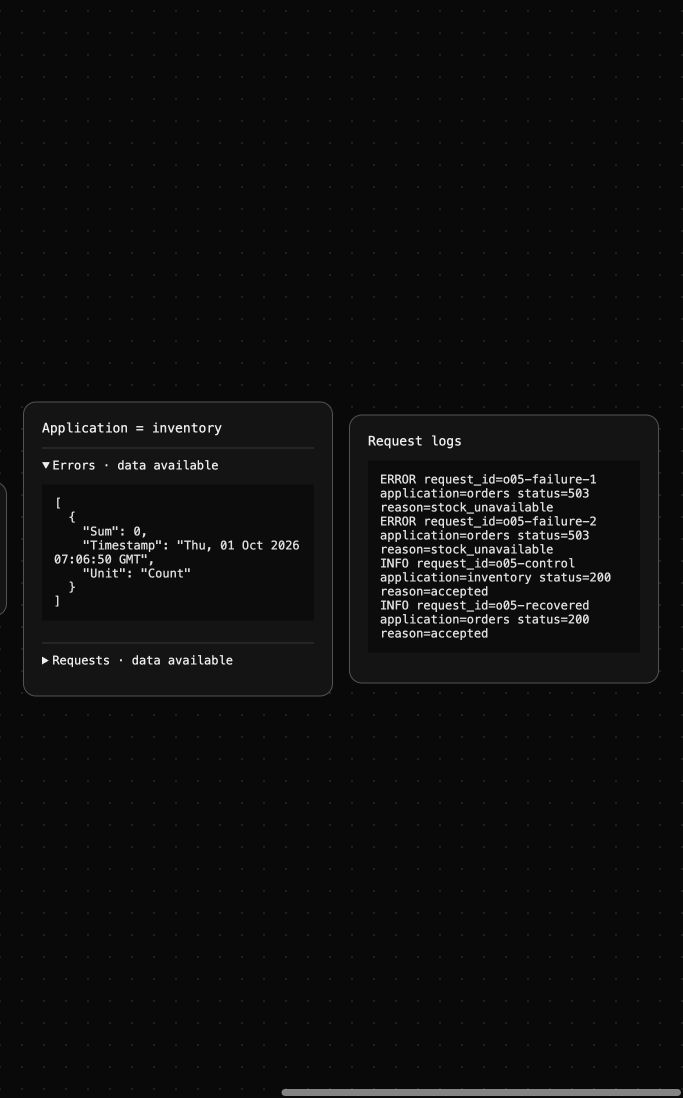
AWS View показывает фактические ряды приложений и журналы запросов. Используйте идентификатор восстановленного запроса, чтобы отличить новый успешный ответ от сохранённой истории сбоев.
Остановите телеметрию и удалите группу журналов работы
На этом шаге вы остановите сбор измерений и удалите только группу журналов инцидента. Существующие метрики сохраняются согласно срокам хранения; API для удаления отдельной метрики нет.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o05-application", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O05"}, "accepted_sku": "apple"}
JSON
aws logs delete-log-group --log-group-name /labex/o05-application
aws logs describe-log-groups --query 'logGroups[].logGroupName'
aws logs get-log-events \
  --log-group-name /labex/o05-reference \
  --log-stream-name platform \
  --query 'events[].message'
Ожидайте только /labex/o05-reference и её исходное сообщение INFO platform reference keep unchanged. Успешно полученный список подтверждает целевое удаление; неудачные запросы не установили бы факт очистки.
Резюме
Вы воспроизвели инцидент с контрольным запросом, связали счётчики метрик с журналами запросов, исправили настройку приложения, проверили новый успешный ответ и сохранили исторические доказательства до целевой очистки.
Подробнее см. в документации AWS: Идентификация метрик, измерения и статистика; Фильтрация событий журналов по терминам и точным фразам.