Введение
Магазину нужна месячная сводка CSV для передачи другим. Вычислите её в Athena, загрузите настоящий результат S3, исправьте продажу и получите новую сводку. Сравните результаты с входными данными на момент выполнения.
Завершите Query Partitioned Sales Data. Независимая среда предоставляет два файла S3, зарегистрированные разделы Glue, AWS-идентичность и исправленный September локально. Личный аккаунт и прошлые VM не нужны. Используйте официальную CLI в Terminal и проверяйте файлы, каталог и результаты в AWS View.
Связь с сертификацией
| Сертификация | Задача экзамена | Практика |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Анализировать S3 с Athena и Glue и получать вычисленные результаты. |
Вычислить месячную сводку
На этом шаге вычислите сводку текущих файлов. Glue описывает схему и пути, Athena читает и группирует по месяцам. Каждое выполнение имеет собственные ID и файл.
Проверьте идентичность в проекте:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN заканчивается на labex-an04-operator. jq -r извлекает строки JSON, $(...) сохраняет вывод в переменные:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
Проверьте зарегистрированные пути:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Оба месяца зарегистрированы. Сумма целых центов total_cents избегает округления валюты. COUNT(*) считает заказы, GROUP BY month группирует, ORDER BY month упрощает сравнение. Heredoc в кавычках сохраняет SQL:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Отправьте с базой и префиксом S3. file:// читает SQL, CLI --query и --output text извлекают ID:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
Повторяйте для QUEUED/RUNNING, продолжайте при SUCCEEDED, для FAILED изучите Reason:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Вложенная проекция [*] сохраняет столбцы каждой строки:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
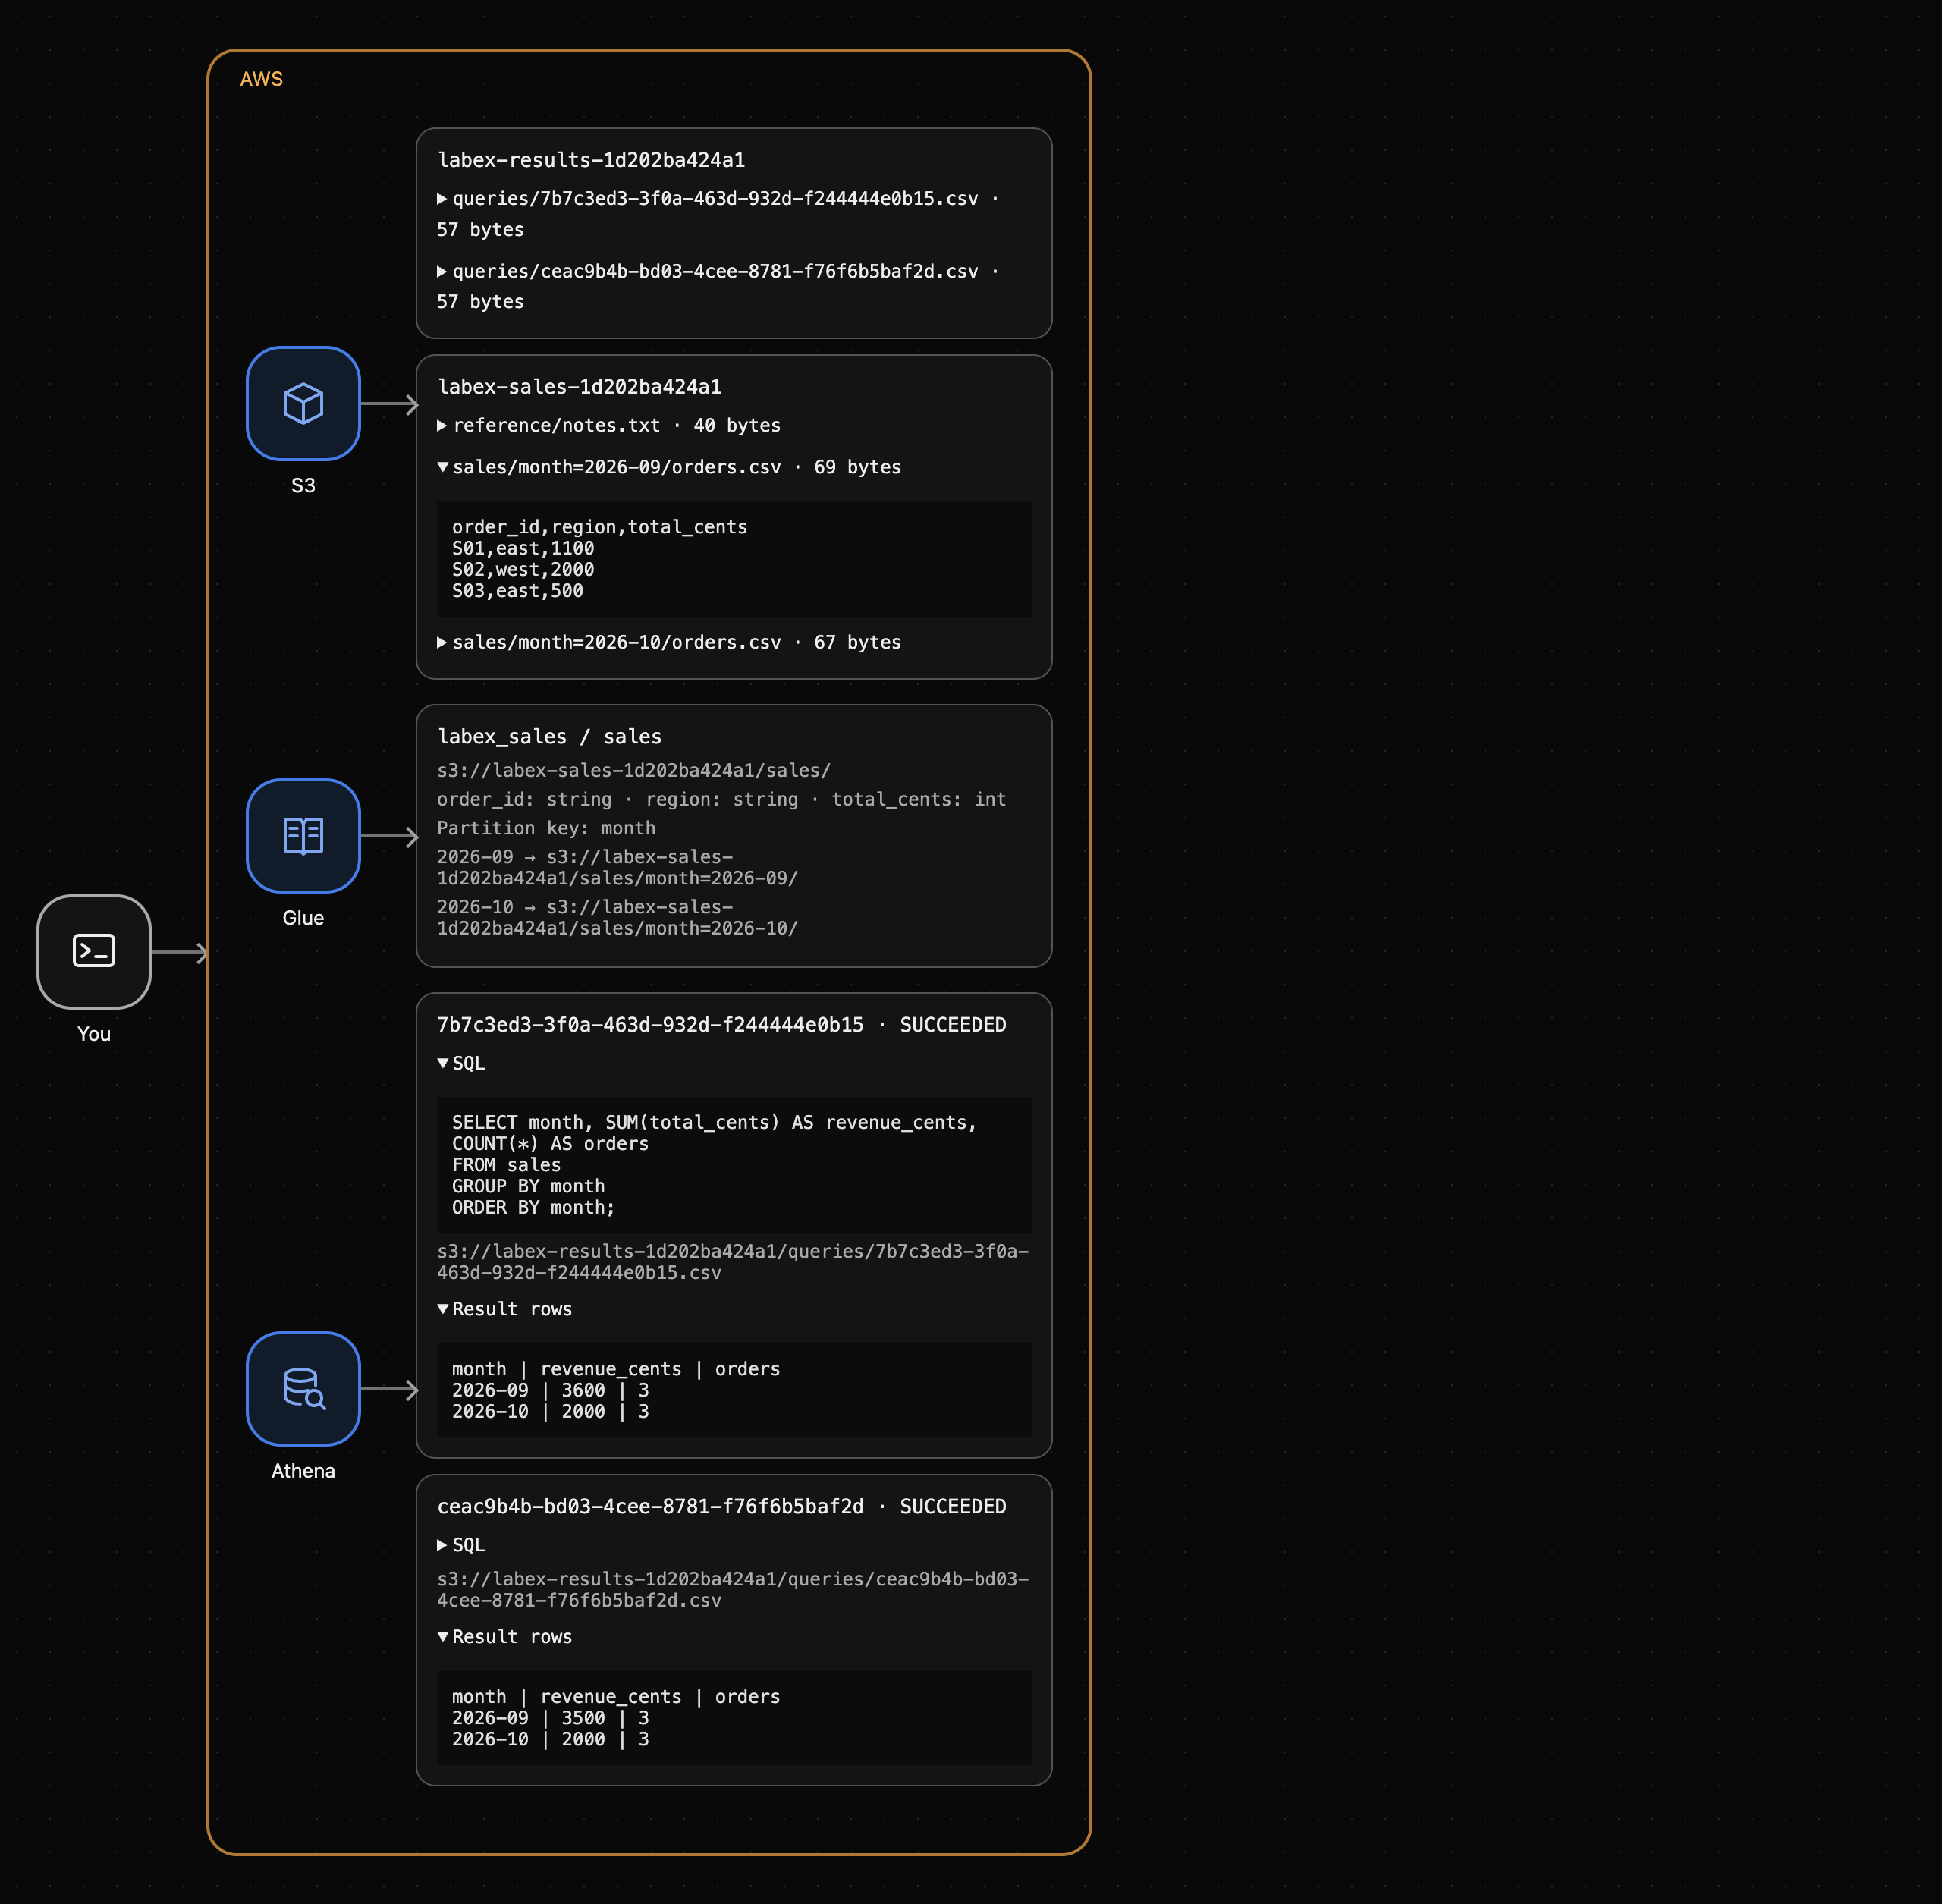
September — 3500 центов/3 заказа, October — 2000/3. Раскройте SQL и строки в AWS View, сравните с месячными путями.
Скачать настоящий файл результата S3
На этом шаге получите CSV данного выполнения. API показывает строки, метаданные — точный путь S3. Не угадывайте бакет или ID.
Извлеките и выведите URI:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
Он заканчивается на /queries/<your-execution-id>.csv; ID связывает файл с запросом. Скачайте в summary.csv:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
Прочитайте содержимое:
cat summary.csv
Заголовок и две записи:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
Значения совпадают с API. Это скачанный файл S3, не написанный вручную отчёт. Сохраните summary.csv и исходный вывод S3 для сравнения.
Пересчитать после исправления входа
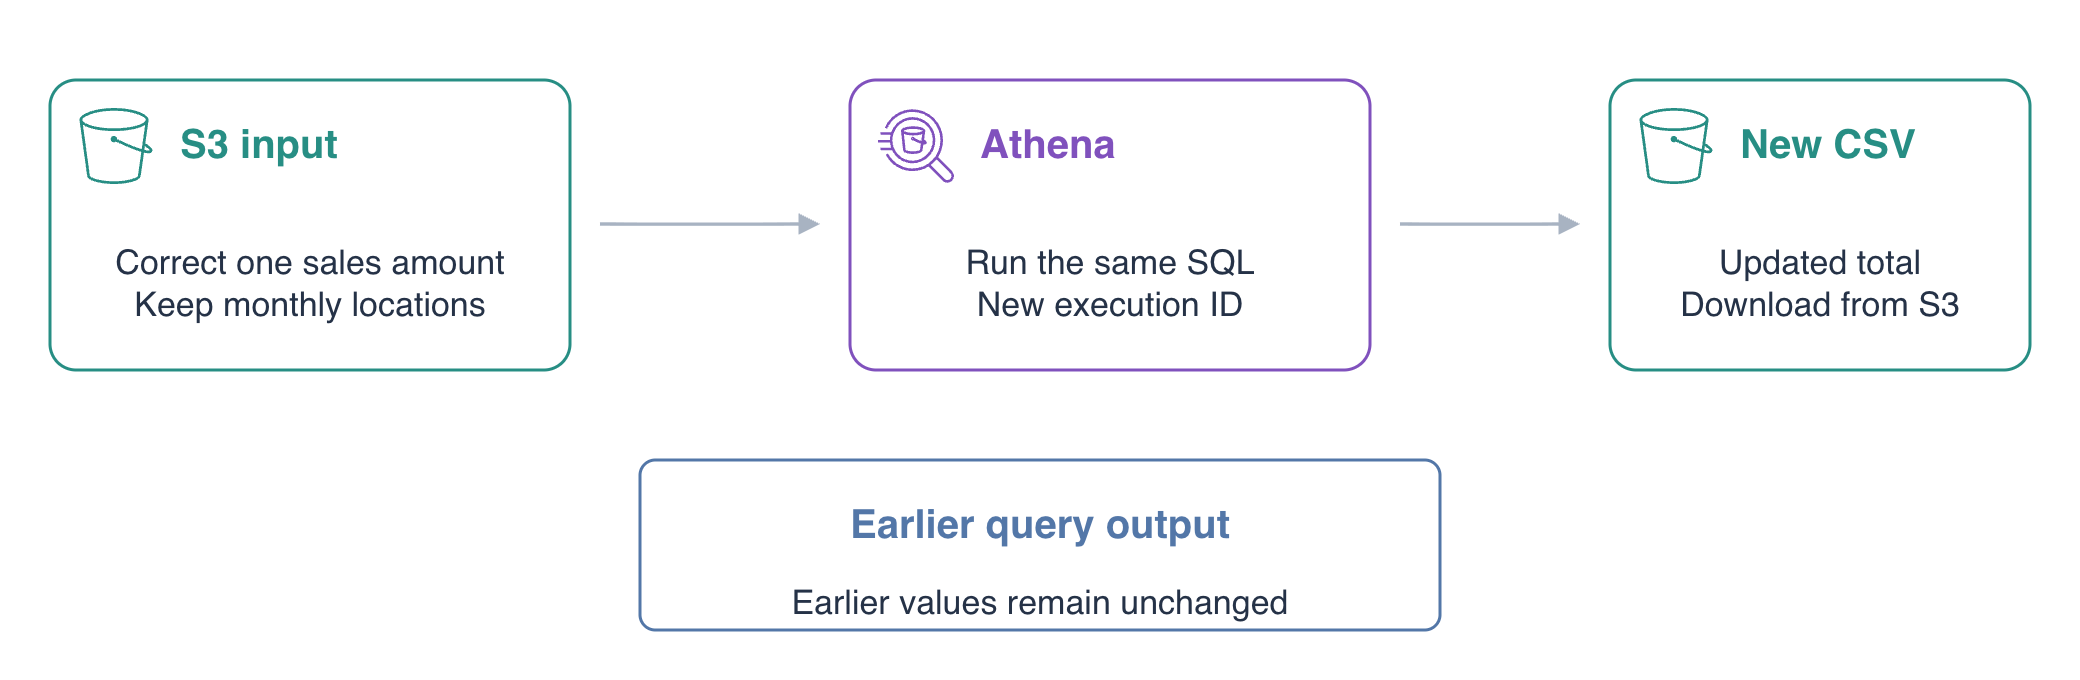
На этом шаге исправьте сумму September и повторите тот же SQL. Старый результат не обновляется автоматически: новое выполнение должно читать текущий вход.
Посмотрите исправленный файл:
cat september-revised.csv
S01 меняется с 1000 на 1100 центов, остальное то же: итог 3600. Замените существующий объект, сохранив October и reference/notes.txt:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
Прочитайте назад для проверки:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
Последний - печатает объект. Схема и путь не изменились, раздел Glue остаётся верным. Выполните тот же SQL заново:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
Подтвердите успех, повторяйте состояние при ожидании и проверяйте ошибки:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Получите строки:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September теперь 3600/3, October остаётся 2000/3. Изменение входа изменило вычисление.
Получите путь нового результата:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
Скачайте без перезаписи старой локальной сводки:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
Прочитайте новый CSV:
cat summary-revised.csv
Сравните исходный вывод S3:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
Там September всё ещё 3500. Разные ID указывают на отдельные файлы старых и исправленных данных. AWS View показывает текущий источник и оба настоящих результата. Проверяется правильность, не стоимость или производительность облака.
Резюме
Вы вычислили итоги, скачали точный CSV, исправили вход и пересчитали. September изменился с 3500 на 3600 центов, October остался 2000. Старые файлы сохраняют значения, поэтому при изменении входа сводку нужно выполнить снова.
Подробнее см. в документации AWS: Поиск выходных файлов выполнения запроса; Фильтрация, группировка и сортировка SELECT.