Введение
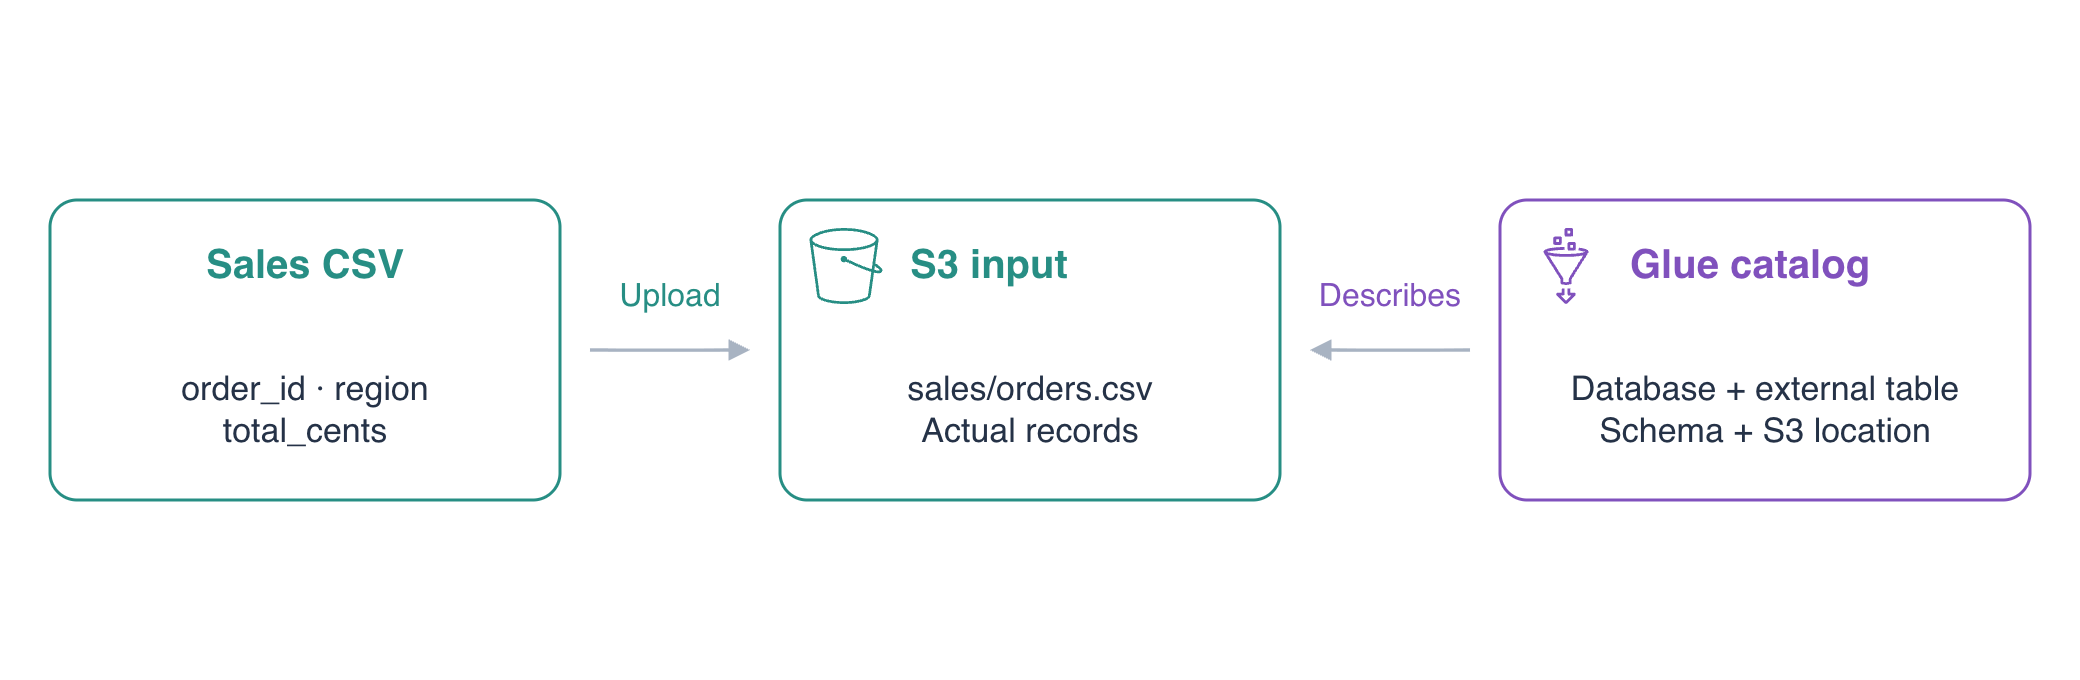
Небольшой магазин выгружает продажи в CSV. Аналитику нужно запрашивать файлы без копирования на сервер базы данных. Поместите файл в Amazon S3 и опишите его в AWS Glue Data Catalog — каталоге метаданных, который сообщает сервисам запросов, где находятся данные и как их читать.
Сначала пройдите AWS Foundations for Beginners, базовые операции S3 и основы идентификации IAM. Эта независимая среда предоставляет пустые бакеты, CSV и настроенную идентификацию AWS CLI. Личный аккаунт и ресурсы другой лабораторной работы не нужны. Работайте через Terminal, наблюдайте реальные объекты и каталог в AWS View. Каталог описывает файлы, но не копирует, не преобразует и не запрашивает их содержимое. Athena появится в следующей работе.
Связь с сертификацией
| Сертификация | Задача экзамена | Практика |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Различать роль каталога Glue в анализе файлов и хранение данных в S3. |
Загрузка файла продаж
На этом шаге изучите предоставленные данные и загрузите их в S3. CSV содержит по записи в строке, поля разделены запятыми. Первая строка задаёт имена полей. Схема описывает имена, порядок и типы для правильного чтения записей запросом.
Перейдите в проект и проверьте настроенную идентификацию:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN заканчивается на labex-an01-operator. Вы используете S3 и Glue этого пользователя. Прочитайте файл September:
cat september.csv
Три продажи содержат order_id, region и total_cents. Первые два поля — строки, сумма — целое число центов. 1000, 2000 и 500 дают 3500. Значения не заключены в кавычки; заголовок занимает одну строку.
В новой среде есть входной бакет с уникальным именем. jq -r извлекает JSON-поле как текст, а $(...) сохраняет вывод в переменную. Сохраните и покажите имя:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
Загрузите в sales/orders.csv. Префикс sales/ объединяет данные для таблицы:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
Прочитайте загруженный объект напрямую:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
Завершающий - печатает объект S3 в терминал. Заголовок и три записи должны совпасть с september.csv. Раскройте объект в AWS View и сравните данные. Посторонний reference/notes.txt вне sales/ оставьте без изменений.
Создание базы каталога
На этом шаге создайте пространство имён для определения таблицы. База Glue объединяет таблицы каталога и хранит метаданные, а не запускает сервер базы данных. Её создание не перемещает файл S3.
Прочитайте имя из списка ресурсов:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input принимает обычное JSON-определение имени и описания:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
Успешное создание не выводит тело ответа. Прочитайте базу для подтверждения:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
Имя — labex_sales, описание соответствует указанному. AWS View показывает базу пока без таблицы. Файл S3 остаётся на прежнем месте.
Описание файла внешней таблицей
На этом шаге сопоставьте поля CSV с именованными типами и укажите настоящий префикс S3. Внешняя таблица описывает данные вне каталога. Удаление её определения само по себе не удаляет объекты S3.
Дескриптор хранения содержит столбцы, расположение и настройки чтения. SerDe — сериализатор/десериализатор, интерпретирующий записи как поля таблицы. LazySimpleSerDe читает здесь значения без кавычек с разделителем-запятой. Заголовок не является продажей; skip.header.line.count пропускает первую строку.
Сохраните и выведите префикс таблицы:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF записывает последующий текст до завершающего EOF. Разделитель без кавычек подставляет в $SALES_LOCATION реальное расположение вашего бакета:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys пуст: первая таблица читает один префикс без разделов. Месячные разделы будут позже. Два класса формата описывают текстовый вход и обычный Hive-совместимый выход; устанавливать или запускать их самостоятельно не нужно.
Создайте таблицу из JSON. file:// загружает вход CLI из локального файла:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
Прочитайте определение из Glue:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
Проверьте порядок столбцов, тип int у total_cents, окончание /sales/ у расположения и значение 1 для заголовка. AWS View показывает объект S3 рядом с определением Glue.
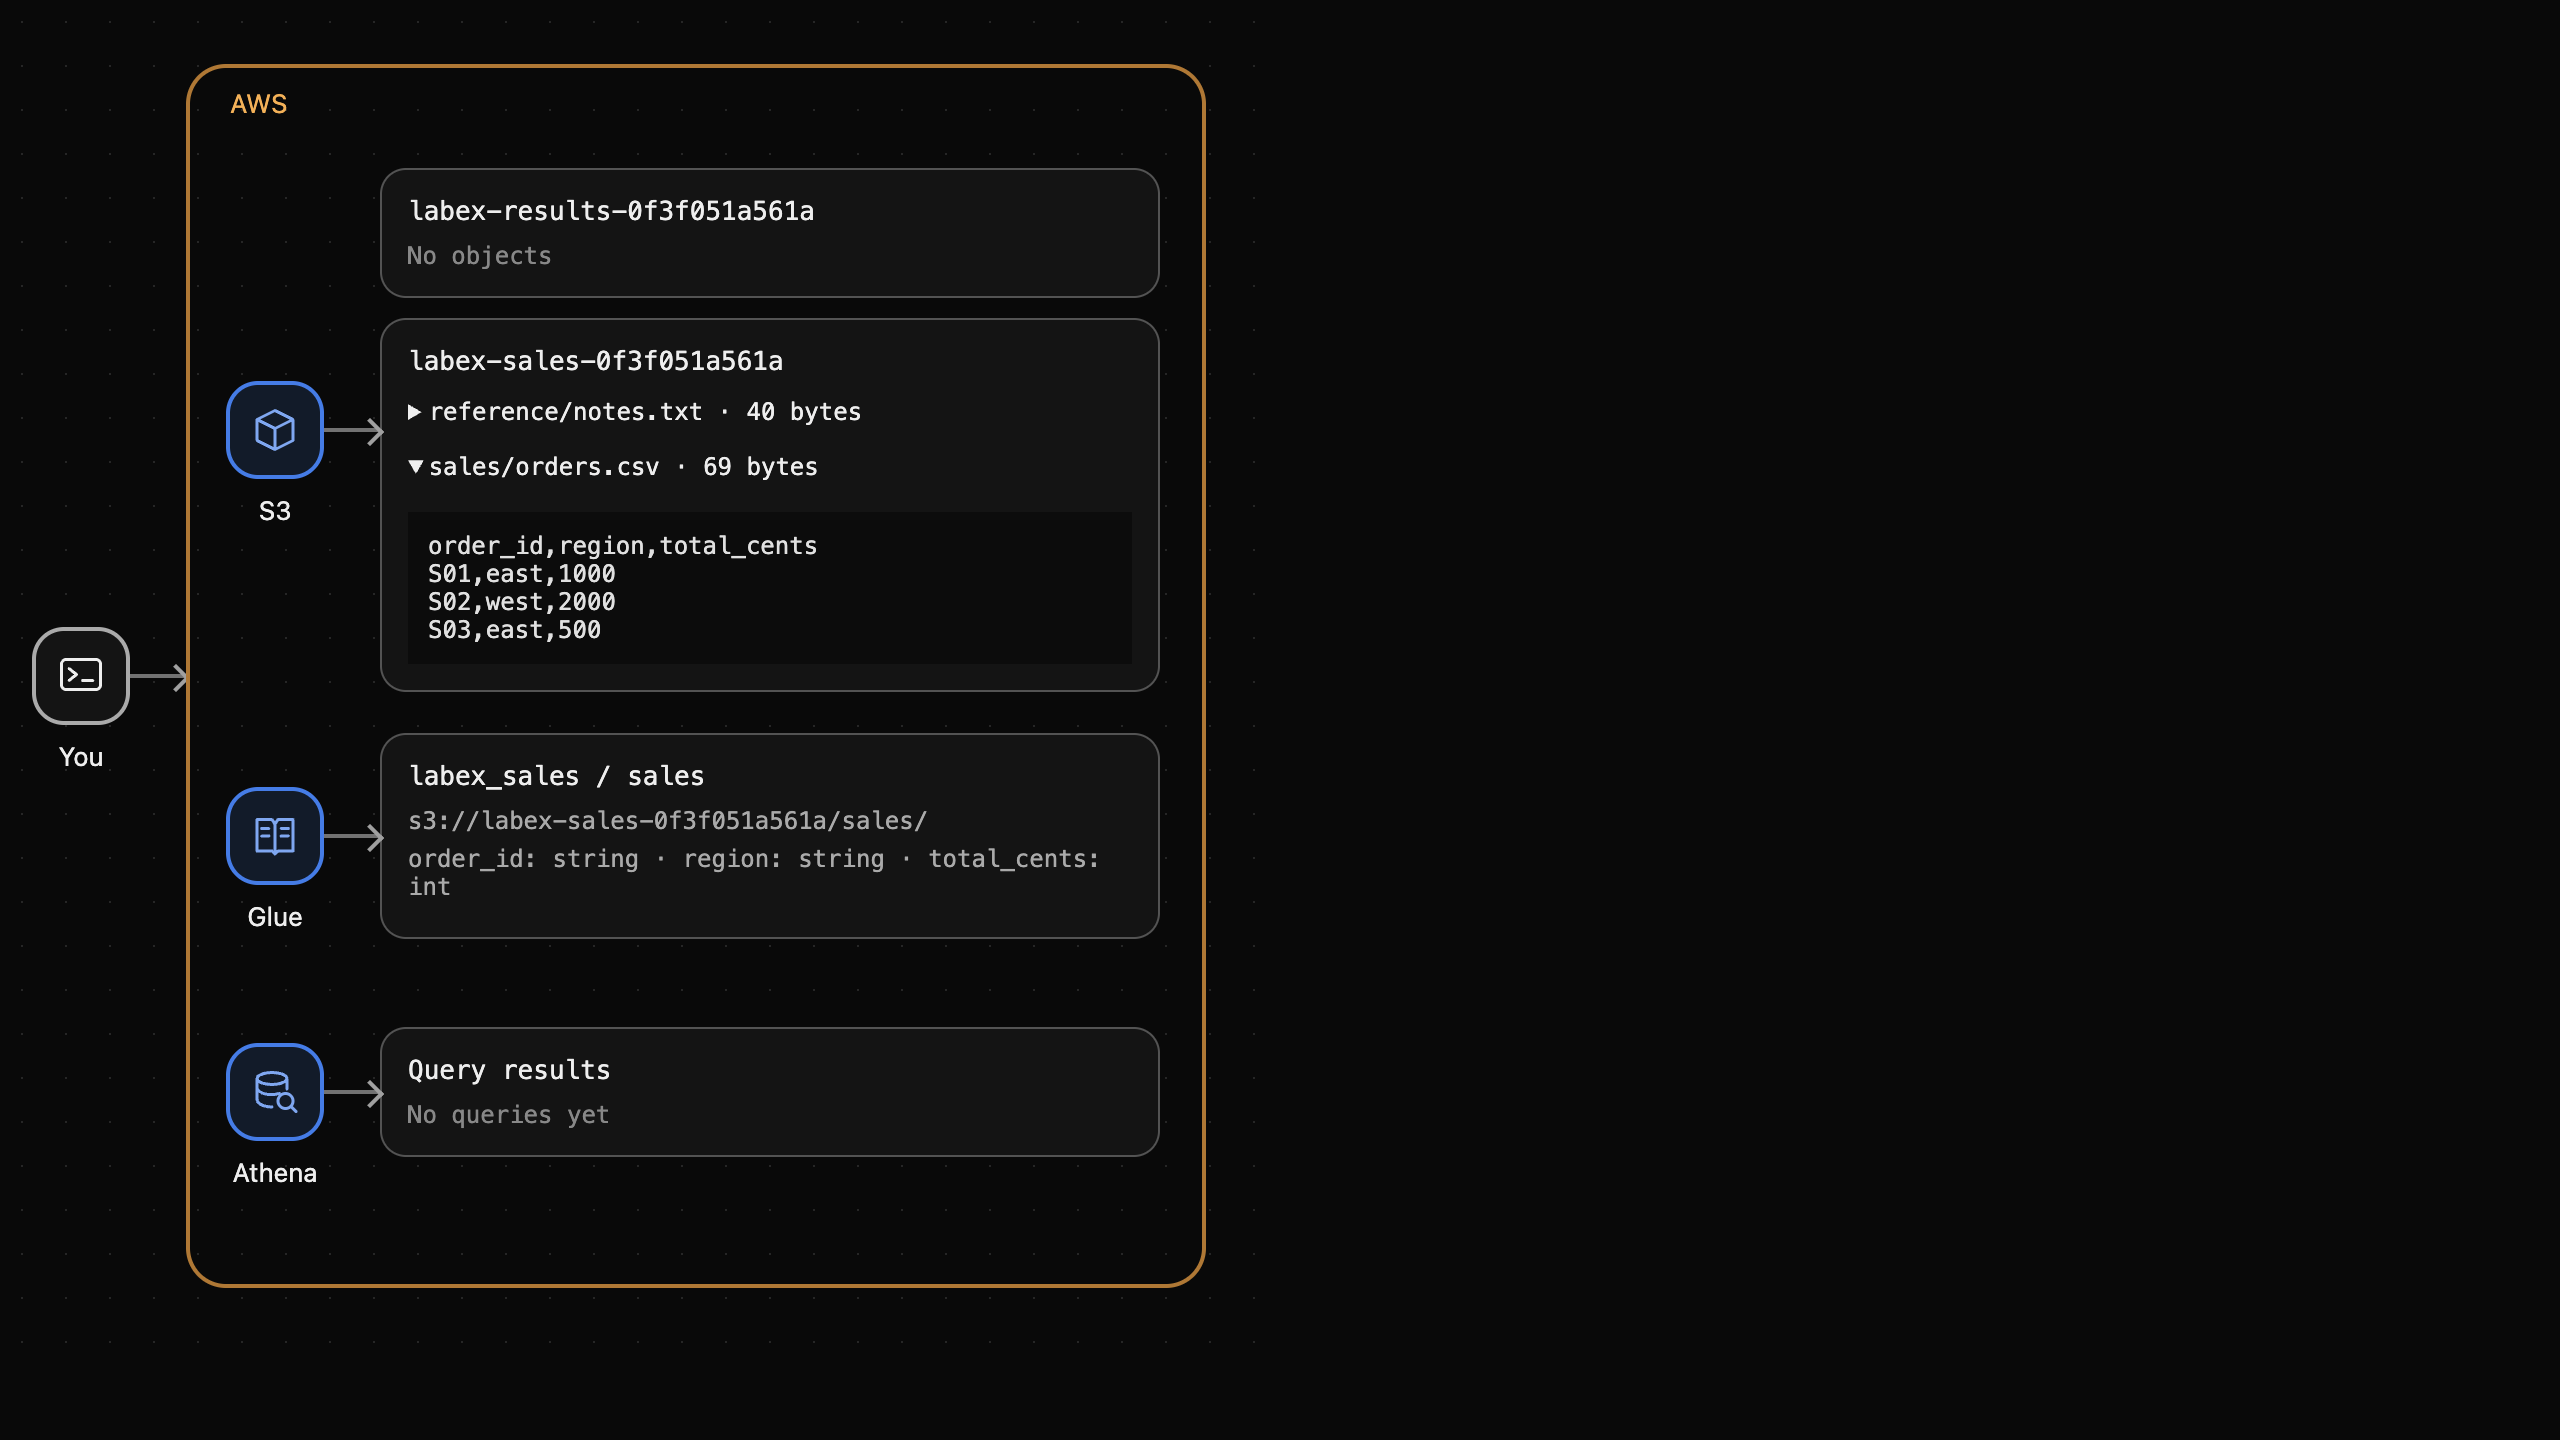
Создание каталога не изменило CSV и не создало результат Athena. Неправильная схема или расположение приведут к ошибке запроса либо чтению других записей. Совпадающие метаданные готовят правильную основу.
Резюме
Вы загрузили настоящие продажи в S3, создали базу Glue и определили внешнюю таблицу с соответствующими столбцами, форматом CSV и расположением. S3 хранит данные, Glue — метаданные. В следующей работе Athena запросит независимо подготовленные данные через эту модель каталога.
Подробнее см. в документации AWS: Ручное определение метаданных каталога; CSV-поля без кавычек и обработка заголовка.