Введение
Команде эксплуатации нужен сигнал ошибок, который срабатывает при сбоях запросов и восстанавливается после успешного трафика. Вы настроите сигнал тревоги по метрике, увидите оба перехода на основе реальных запросов, сравните ноль с отсутствующими данными и удалите свои сигналы тревоги.
Сначала выполните Измерение состояния приложения с помощью метрик CloudWatch, включая измерения метрик и Sum. Эта работа предоставляет новое приложение и ряды метрик.
Связь с сертификацией
| Сертификация | Задача экзамена | Практика |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Задача 1.1 | Оценка тревог CloudWatch, восстановление и отсутствующие данные. |
| DevOps Engineer – Professional (DOP-C02) | Задача 4.2 | Базовая практика: Оценка тревог CloudWatch, восстановление и отсутствующие данные. |
| Solutions Architect – Professional (SAP-C02) | Задача 3.1 | Базовая практика: Оценка тревог CloudWatch, восстановление и отсутствующие данные. |
Обзор лабораторной работы
Настройте сигнал тревоги по метрике
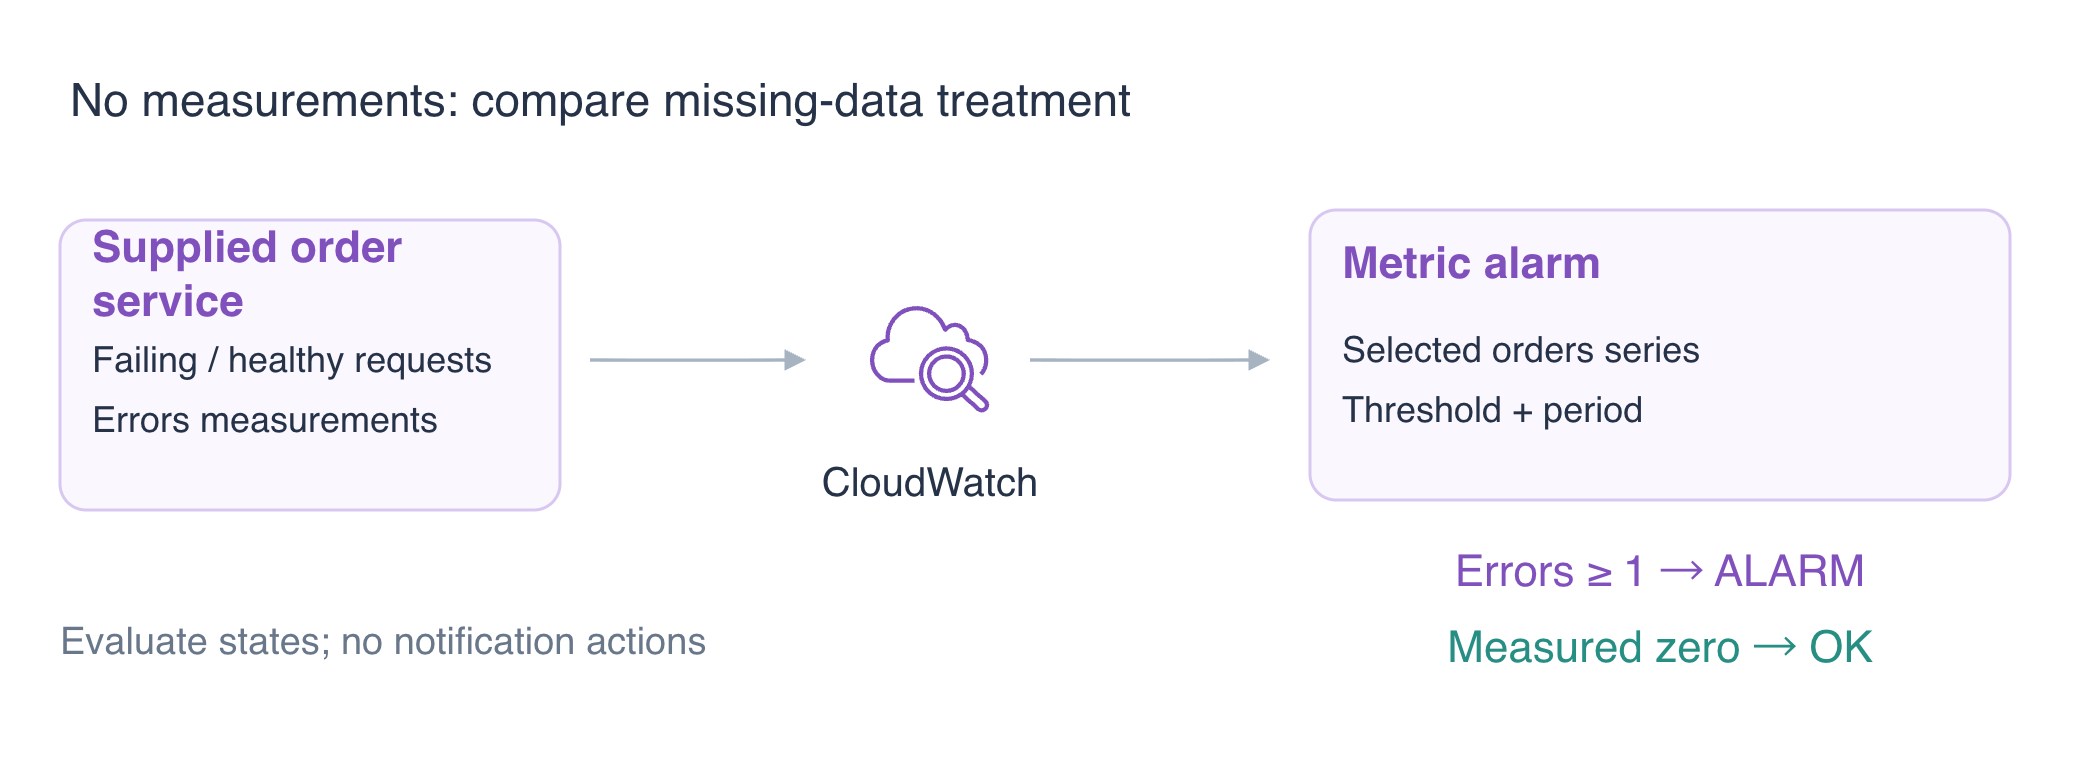
На этом шаге вы будете наблюдать количество серверных ошибок приложения orders. Сигнал тревоги сравнивает метрику с порогом и сообщает OK, ALARM или INSUFFICIENT_DATA. Он не отправляет уведомления без настроенного действия; это упражнение сосредоточено на оценке.
Независимое подготовленное приложение публикует метрики реальных запросов. Его метрика Errors равна единице для HTTP 5xx и нулю для успешного запроса. Публикация с высоким разрешением допускает период в 10 секунд, чтобы вы могли быстро увидеть несколько периодов. Периоды и пороги в рабочей среде зависят от нагрузки и стоимости.
cd /home/labex/project
Создайте сигнал тревоги по одной метрике. Пространство имён, имя и измерения выбирают ряд; Sum считает ошибки в каждом завершённом периоде.
Сигнал тревоги оценивает один завершённый 10-секундный период (--period 10, --evaluation-periods 1). Sum не меньше 1 достигает порога; GreaterThanOrEqualToThreshold означает «больше или равно». notBreaching считает период без измерений не нарушающим порог. Это сохраняет OK в периоды бездействия, но не подтверждает исправность приложения.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
Прочитайте сигнал тревоги командой ниже. Если оценка ещё ожидается, подождите несколько секунд и повторяйте эту команду чтения, пока она не сообщит OK.
Начальное OK вызвано обработкой отсутствующих данных, а не успешной проверкой состояния. Изучите причину оценки:
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
Сохраните /labex/o03-reference неизменной. Каждая работа начинается независимо; предыдущие данные метрик не нужны.
Вызовите сигнал тревоги реальными сбоями
На этом шаге вы выполните реальные неудачные запросы и дождётесь автоматической оценки. Завершённый период исключает точки текущего незавершённого периода; наблюдение HTTP-ответа и состояния сигнала тревоги — отдельные действия.
pear недоступен в предоставленном сервисе. Цикл отправляет девять запросов с интервалом в две секунды, охватывая несколько 10-секундных периодов. for повторяет команды; sleep 2 делает паузу между запросами. curl без -f возвращает тело ответа даже при HTTP 503, что позволяет увидеть сбой.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Прочитайте оценённое состояние. Если оно ещё не достигло ALARM, подождите несколько секунд и повторите эту команду. StateReasonData — JSON, сохранённый как строка, поэтому его кавычки в ответе экранированы; recentDatapoints перечисляет суммы оценённых периодов.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
Ожидайте ALARM и значение recentDatapoints не меньше 1 в StateReasonData. Если оценка ещё показывает предыдущий период, подождите несколько секунд и повторите команду чтения. Состояние следует за точками реальных запросов; не задавайте состояние сигнала тревоги вручную. Сигнал наблюдает только orders, поэтому ряд другого приложения не участвует в этой оценке.
Для команды заказов ALARM показывает, были ли серверные ошибки в выбранном периоде. Он не объясняет, какой запрос завершился сбоем и почему товар был недоступен. HTTP-ответ подтверждает сбой бизнес-запроса, оценённая точка данных — переход состояния сигнала, а журналы дают детали для диагностики. Различайте эти наблюдения, выбирая направление расследования.
Наблюдайте восстановление и отсутствие данных
На этом шаге вы отличите реальный ноль от отсутствующей телеметрии. Отправьте успешные запросы apple, чтобы завершённые периоды содержали измеренное Errors=0. Повторение в нескольких периодах помогает не принять текущий незавершённый интервал за восстановление.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Прочитайте оценённое состояние. Если оно ещё не достигло OK, подождите несколько секунд и повторите эту команду.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
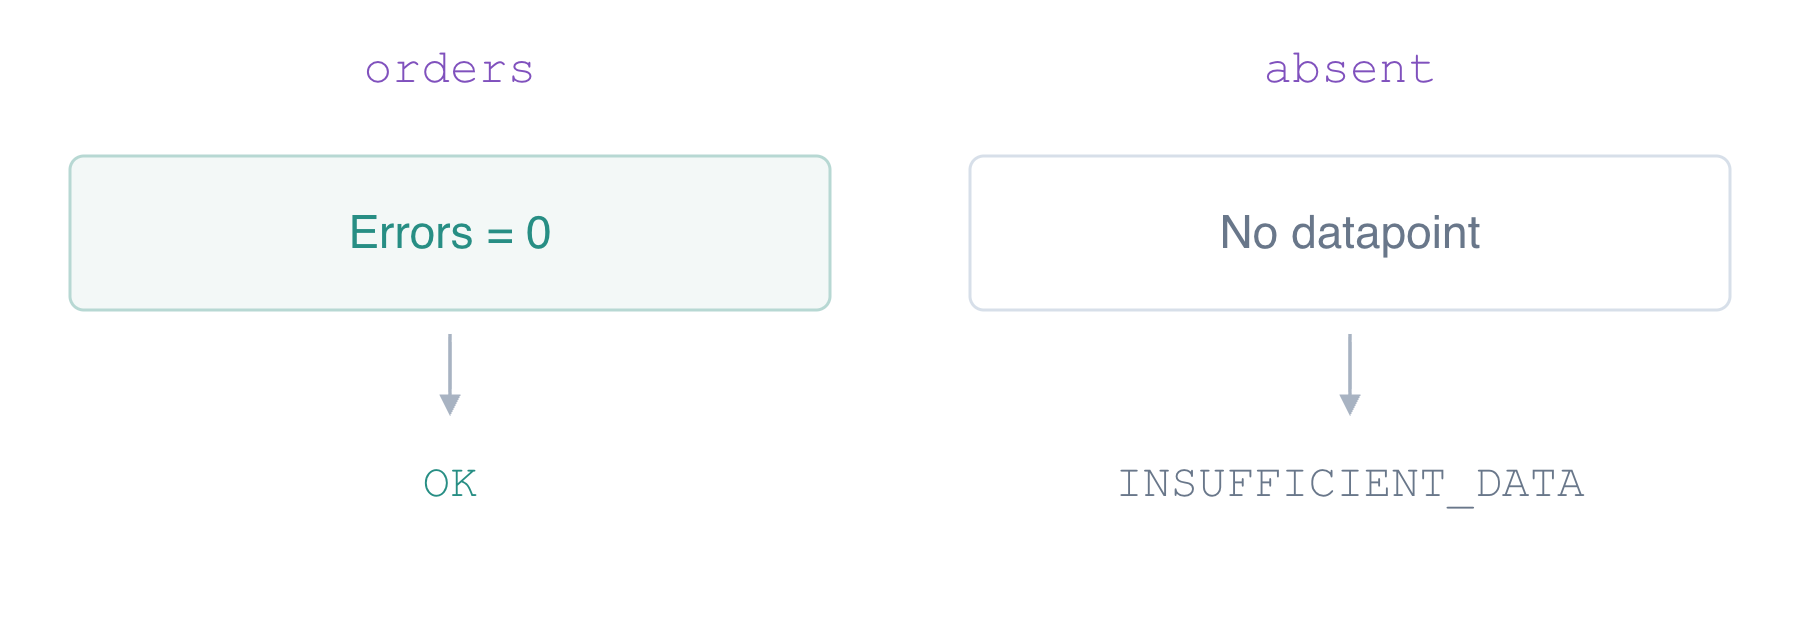
Ожидайте OK с recentDatapoints: [0]. Пустой список означает отсутствие телеметрии, поэтому подтвердите измеренный ноль перед продолжением.
Создайте отдельный сигнал тревоги для Application=absent — ряда, который приложение никогда не публикует. Обрабатывайте отсутствующие данные как отсутствующие, а не как признак исправности.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
Новый сигнал тревоги должен оставаться в INSUFFICIENT_DATA, поскольку выбранный им ряд не содержит измерений.
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
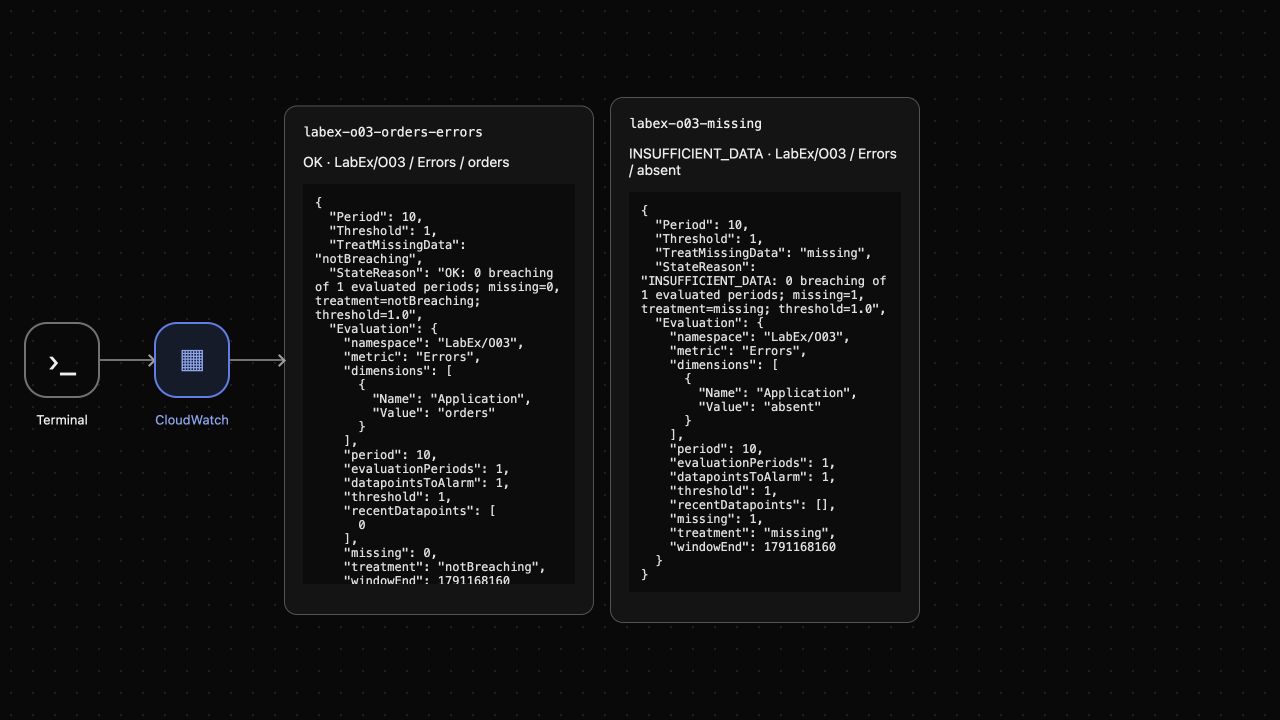
Ожидайте OK для orders вследствие измеренного нуля и INSUFFICIENT_DATA для absent. Используйте причину оценки, чтобы отличить измеренный ноль от отсутствующей телеметрии.
AWS View отображает фактическое состояние сервиса и оценённые точки. Сравнивайте причины вместо того, чтобы считать любое OK доказательством исправности приложения.
Удалите сигналы работы и остановите публикацию
На этом шаге вы удалите только сигналы тревоги этой работы и сохраните независимые данные. Отключите сбор измерений перед очисткой, чтобы приложение перестало публиковать новые точки.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
Ожидайте пустой список сигналов тревоги и INFO platform reference keep unchanged. Существующие точки метрик сохраняются; в CloudWatch нет явного API для удаления отдельной метрики. После этого автор или платформа удаляет эту временную среду.
Резюме
Вы настроили сигнал тревоги по ошибкам, наблюдали автоматическое срабатывание и восстановление на основе реальных запросов, отличили измеренный ноль от отсутствующих данных и удалили сигналы работы, сохранив эталонные журналы.
Подробнее см. в документации AWS: Тревоги по метрикам и действия; Оценка тревог при отсутствии данных.