소개
워크숍에 배정된 사람을 비교하면 B 페이지의 신청률이 더 높습니다. 페이지가 누구의 결과도 바꾸지 않아도 무작위 배정만으로 집단이 달라 보일 수 있을까요? 실제 무작위 차이의 분포를 생성하기 전에 작은 수동 교환으로 이 질문을 구체화합니다.
이 독립된 환경에는 앞서 배운 올바른 개인 결과 함수와 비율 비교 함수, 자체 원본 데이터가 준비되어 있습니다. 이 개념과 Python 함수, 기본 NumPy 배열, Matplotlib 기초를 알고 있어야 합니다. 이전 VM 파일이나 통계적 추론 지식은 필요하지 않습니다. 탐색용 재배정 399회와 실제 그래프를 저장하며, 여기서는 p값을 계산하거나 승자를 고르지 않습니다. 모든 기록은 직접 제작한 합성 교육 예입니다. 55분은 읽기와 일반적인 오류 수정을 포함한 저자의 예상 시간입니다.
집단 크기를 유지하며 사람 교환하기
이 단계에서는 여섯 사람의 차이를 계산하고 두 사람의 집단 소속을 교환하여 비교가 바뀌는 이유를 확인합니다.
WebIDE에서 Terminal → New Terminal을 열고 이 단원의 디렉터리로 이동합니다.
cd /home/labex/project/signup-experiment
cat은 파일을 바꾸지 않고 읽습니다. 연습 카드와 준비된 두 함수를 다시 읽으세요.
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
여섯 카드의 이진 결과는 A가 [1, 0, 0], B가 [1, 1, 0]입니다. 각 1 또는 0은 배정된 한 사람의 것이며 반복 이벤트는 추가 관측이 아닙니다. A는 1/3, B는 2/3이 신청했고 B−A는 약 +33.33퍼센트포인트입니다.
A의 두 번째 사람(결과 0)과 B의 첫 번째 사람(결과 1)의 소속을 교환한다고 생각해 보세요. A는 [1, 1, 0], B는 [0, 1, 0]이 되고 차이는 약 −33.33퍼센트포인트입니다. 각 집단은 여전히 세 명이고 양성 결과도 총 세 개입니다. 바꾼 것은 배정이지 개인 결과나 표본 크기가 아닙니다.
차이 함수를 작성합니다. np.mean은 NumPy 배열의 이진 값 평균을 구합니다. B의 평균에서 A의 평균을 뺀 다음 100을 곱하면 퍼센트포인트가 됩니다. sample_null의 뼈대는 뒤에서 완성합니다. 함수를 정의하는 것만으로 실행되지는 않습니다.
셸의 >는 파일을 교체합니다. 따옴표로 감싼 히어 도큐먼트 <<'PY'는 마지막 PY까지의 전체 블록을 셸 확장 없이 복사합니다. WebIDE의 File → Save로 같은 내용을 저장해도 됩니다.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
실행기의 contrast 단계는 원본 카드와 정확히 설명한 교환을 전달하고 함수를 두 번 호출하여 두 실제 결과를 저장합니다.
python3 run.py contrast
읽기 프로그램은 결과를 다시 만들지 않고 저장된 결과를 보여 줍니다.
python3 show_results.py contrast
original_pp는 +33.33 근처, swapped_pp는 −33.33 근처여야 합니다. 어느 값도 실제 사람이 다른 페이지에서 어떻게 될지 예측하지 않습니다. 같은 여섯 결과를 고정해도 집단 구성이 비교를 바꿀 수 있음을 보여 줍니다.
resample.py와 나중의 plot.py를 편집하거나 같은 위치에 일반 Python 보조 파일을 추가할 수 있습니다. 원본 CSV, 설정, 사전, 실행기, 읽기 프로그램을 보존하세요. 디렉터리가 틀리면 pwd와 ls를 사용하고 위의 cd를 반복하세요. 편집 실수는 전체 블록을 다시 복사하여 고칩니다. 설정은 기존 작업 디렉터리를 덮어쓰지 않습니다.
실제 재배정 생성하기
이 단계에서는 전체 방문자 결과를 원래 크기의 집단으로 반복해서 섞고 생성된 모든 차이를 저장합니다.
같은 WebIDE 터미널의 /home/labex/project/signup-experiment에서 계속합니다. 고정된 전체 표본은 집단당 여섯 명, 총 12명입니다. 준비된 결과 함수는 완전한 7일 시간 창을 사용합니다. 경계 사례와 이벤트 없는 사람을 다시 찾으려면 실제 입력 전체를 읽으세요.
cat assignments.csv
cat events.csv
이 연습의 효과가 없다는 귀무 가정에서는 배정된 페이지가 누구의 이진 결과도 바꾸지 않습니다. 고정된 개인 결과를 두 집단에 재배정하면 배정만으로 예상되는 변동을 알 수 있습니다. 이 가정은 합성 기록이 나타내는 무작위 실험 설계에 근거합니다. 임의의 관찰용 웹사이트 로그를 섞는다고 무작위 실험이 되지는 않습니다.
np.concatenate([a, b])는 두 배열을 합칩니다. np.random.default_rng(seed)는 재현 가능한 시작 상태의 의사 난수 생성기를 만듭니다. permutation 메서드는 합친 원본을 그대로 두고 섞인 사본을 반환합니다. 슬라이스 shuffled[:len(a)]는 앞의 A 크기 부분을, shuffled[len(a):]는 나머지 B 크기 부분을 가져옵니다. 매 추출에서 각 사람을 한 번 사용하고 두 집단 크기를 유지합니다. 반복된 원시 이벤트 행을 섞지 마세요.
파일을 두 완전한 함수로 교체합니다. for 반복문은 요청된 횟수만큼 추출하며 append는 계산한 각 차이를 보관합니다. 배열을 반환하면 평균이나 유리한 한 번 대신 표본 전체를 유지합니다.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
실행기는 전체 사람 단위 표본에서 이 함수들을 호출해 실제 집단 수, 관측 차이, 섞인 차이 399개를 저장합니다. --seed는 재현 가능한 시작 상태를 전달하며 하이픈 두 개는 이름 있는 명령 옵션을 뜻합니다.
python3 run.py sample --seed 17
python3 show_results.py sample
전체 데이터는 여전히 A 6명 중 1명, B 6명 중 5명이 신청하여 관측 차이가 약 +66.67퍼센트포인트입니다. null_count는 399여야 합니다. 읽기 프로그램은 표시를 줄이려고 처음 여덟 추출만 null_preview로 보여 주며, 전체 배열은 output/sample.json에 저장됩니다.
시드가 유일한 정답이 아닌 이유를 알아보기 위해 두 번째 일반 표본을 생성합니다.
python3 run.py sample --seed 42
python3 show_results.py sample
저장된 표본은 실제 시드 42 실행으로 교체됩니다. 보통 수열은 바뀌지만 원래 개인 결과, 집단 크기, 관측 비교는 같습니다. 같은 시드로 다시 실행하면 같은 수열을 재현해야 합니다. 음이 아닌 재현 가능한 모든 시드와 동등한 독립 추출 구현을 허용하며 저자의 수열을 요구하지 않습니다. 페이지에 유리해 보이는 표본을 찾으려고 계속 재실행하지 마세요. 이후의 정확 분석은 가장 보기 좋은 탐색 표본이 아니라 모든 배정을 사용합니다.
섞인 통계량은 모두 −100에서 +100퍼센트포인트 사이지만 구간의 모든 수를 얻을 수 있는 것은 아닙니다. 여섯 사람의 연습에서 서로 다른 3 대 3 배정 20개는 차이 −100, −100/3, +100/3, +100에서 빈도 1, 9, 9, 1을 만듭니다. 전체 12명 표본에는 배정 924개가 있고, −100, −200/3, −100/3, 0, +100/3, +200/3, +100에서 빈도는 1, 36, 225, 400, 225, 36, 1입니다. 다음 실습에서 이 숫자를 외우게 하지 않고 정확하게 계산합니다.
이 탐색 교육 과제에서는 가능한 각 차이의 표본 빈도와 정확 참조 빈도의 차이를 비율의 절대 차이로 최대 0.15까지 허용합니다. 예를 들어 0.40과 0.46은 0.06 차이입니다. 의도적으로 넓은 교육용 통과 허용오차이며 신뢰구간, 유의성 기준, 사업 보장, 시드 선택 기준이 아닙니다. 배열의 완전 일치를 요구하지 않고 일반 표본과 독립된 방법을 허용합니다. 올바른 전부 0인 예에서는 모든 재배정 차이가 0이며 0이 아닌 퍼짐은 필수가 아닙니다.
함수 계약은 주어진 이진 배열과 같은 제한 범위의 코스 변형에 적용됩니다. 집단당 최소 두 명, 전체 최대 14명입니다. 검사는 다른 집단 크기, 음수와 0 차이, 퇴화 결과를 포함한 격리된 입력과 시드를 사용합니다. 기존 표본을 교체하지 않습니다. 표본 p값은 요청하거나 채점하지 않습니다.
저장된 배정 차이 그리기
이 단계에서는 각 차이의 실제 표본 횟수를 표시하고 변하지 않은 관측 비교의 위치를 표시합니다.
같은 WebIDE 터미널의 /home/labex/project/signup-experiment에서 계속합니다. np.unique(..., return_counts=True)는 저장된 서로 다른 차이와 출현 횟수를 반환합니다. 이는 이산적인 횟수 그래프입니다. 세로축은 재배정 399회 중 각 차이가 몇 번 생겼는지 나타냅니다. 효과의 신뢰구간이 아닙니다.
그리기 함수는 저장 결과와 출력 경로를 받습니다. 읽기 쉽게 PNG를 최소 500 × 250픽셀로 만드세요. figsize=(9, 4.5)는 그림 크기를 인치로 설정합니다. DPI(dots per inch, 인치당 점 수)는 저장된 래스터 해상도를 정합니다. 인치당 140픽셀이면 약 9 × 140 대 4.5 × 140, 즉 1260 × 630픽셀입니다. Matplotlib의 subplots는 그림과 축을 만듭니다. bar는 횟수를 그리고 axvline은 관측 차이를 다른 배정 횟수인 것처럼 취급하지 않고 표시합니다. 라벨과 보이는 범례가 이 표시를 식별합니다. 가로축을 −110부터 +110으로 고정하면 이 유한 표본에 극단값이 없어도 가능한 모든 이진 비율 차이에 공간이 있습니다. 세로축은 0부터 시작하고 tight_layout은 savefig가 실제 PNG를 쓰기 전에 라벨 공간을 확보합니다.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
기존에 저장한 표본을 읽어 함수로 그립니다.
python3 run.py plot-sample
WebIDE 파일 탐색기에서 signup-experiment/output을 펼치고 sample.png를 엽니다. 두 축 라벨을 읽으세요. 대부분의 횟수는 차이 0 근처에 모이고 빨간 관측 표시는 약 +66.67퍼센트포인트에 남아야 합니다. 표본에 없는 값의 횟수는 0이지 누락된 사람이 아닙니다. 추출 399개와 원래 12명 모두 여전히 저장 데이터에 포함됩니다.
아래 참조 이미지는 방금 실행한 NumPy 시드 42 예입니다. 다른 허용된 추출기나 시드는 막대 높이를 바꿀 수 있습니다. 저장 파일은 자신의 실제 추출을 보여야 합니다.
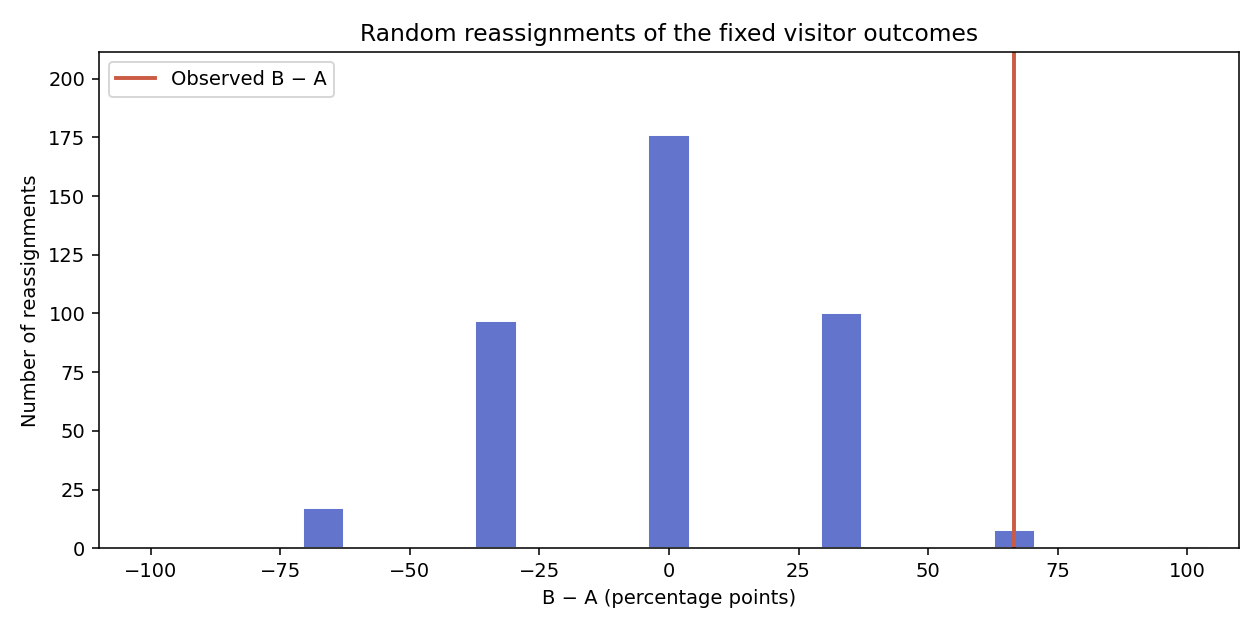
저장된 PNG는 현재 그리기 함수와 저장 표본으로 재현 가능해야 합니다. 실제 차이 값에 읽기 쉬운 막대, 횟수 선 또는 점을 사용할 수 있으며 관측 차이에 Observed 라벨의 보이는 선이나 점이 필요합니다. 가능한 모든 차이와 관측 표시를 표시 축 안에 두고 횟수의 0 기준선을 유지하며 두 축에 라벨을 붙이세요. 표시 숨기기, 데이터 자르기, 무관한 이미지 복사, 밀도를 횟수라고 표시하기로는 과제를 완료할 수 없습니다.
PNG가 없으면 먼저 python3 show_results.py sample이 저장 표본을 읽는지 확인한 다음 그리기 명령을 다시 실행합니다. 읽기 프로그램 자체는 빠진 파일을 생성하지 않습니다. 다음 실습에서는 정확 배정 분포와 관측 결과를 비교하고 이 증거가 무엇을 말하고 말하지 못하는지 배웁니다.
요약
두 사람의 집단 소속을 수동으로 교환하고 고정된 집단 크기로 실제 방문자 재배정 399회를 생성해 저장된 차이와 관측 비교를 그렸습니다. 재현 가능한 시드는 실행을 반복하게 할 뿐 답이나 이길 페이지를 고르지 않습니다. 이제 다음 실습의 정확한 증거를 이해할 직관을 얻었습니다.