소개
탐색용 재배정 그래프는 고정된 개인 결과가 서로 다른 집단 비교를 만드는 모습을 보여 줍니다. 이 실습은 분석을 이어 작은 고정 표본의 서로 다른 모든 배정을 세고, 양측 p값을 정확히 정의하며, 데이터가 뒷받침하는 내용을 기록합니다.
이 독립된 환경에는 올바른 개인 결과와 비교 함수가 준비되어 있습니다. 앞선 실습의 개인 시간 창, 퍼센트포인트 차이, 집단 크기를 유지한 재배정과 Python, NumPy, Matplotlib 기초를 알고 있어야 합니다. 이전 VM 파일이나 p값 사전 지식은 필요하지 않습니다. 직접 제작한 합성 교육 데이터는 실제 사업 실험이 아닙니다. 큰 관측 차이나 작은 p값도 실제 운영 결과를 보장하지 않습니다. 55분은 읽기와 일반적인 오류 수정을 포함한 저자의 예상 시간입니다.
서로 다른 모든 배정 세기
이 단계에서는 유한한 무작위 표본을 전체 배정 분포로 바꾸고 명시적으로 정의된 양측 p값을 계산합니다.
WebIDE에서 Terminal → New Terminal을 열고 작업 디렉터리로 이동합니다.
cd /home/labex/project/signup-experiment
검정 결과를 보기 전에 원본 정의와 설정을 읽습니다.
cat data-dictionary.md
cat config.json
분석은 추적 관찰이 모두 끝난 하나의 고정 표본과 사람당 하나의 이진 신청 결과를 사용합니다. 이후 해석은 이미 선택한 alpha = 0.05를 사용합니다. 알파는 이 연습의 관례적인 비교 기준이며 페이지가 작동할 확률이 95%라는 뜻이 아닙니다. 유리한 결과를 찾은 후 선택한 것도 아닙니다. 비교를 본 뒤 데이터, 분석 시각, 기준, 모집단을 바꾸지 마세요.
연습의 페이지 효과가 없다는 귀무 가정에서는 어느 페이지에 배정되든 각 사람의 결과가 변하지 않습니다. 표현된 무작위 설계에서는 두 집단 크기를 유지하며 고정된 결과를 다시 나눌 수 있습니다. 이런 추론이 임의의 비무작위 관찰 로그에 자동으로 적용되는 것은 아닙니다.
정확 배정 분포는 사람을 두 집단에 넣는 서로 다른 모든 방법을 포함합니다. 평균 기반 통계량에서 집단 안의 순서는 추가 배정을 만들지 않습니다. Python의 math.comb(n, k)는 n명 중 k명을 고르는 방법의 수를 셉니다. 여기서는 12명 중 A의 여섯 명을 고르면 B의 여섯 명도 결정됩니다.
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
이 실험은 924개, 제공된 코스 예는 최대 3432개의 배정이 있습니다. 의도적으로 작은 크기이기에 정확한 열거가 실용적입니다. 임의로 큰 실제 운영 표본을 열거할 수 있다고 약속하는 방법은 아닙니다.
B−A의 퍼센트포인트 차이에 대해 이 코스는 SciPy의 정확한 two-sided 규칙을 따릅니다.
먼저 정확 배정 차이가 관측 차이이하인 비율을 구합니다. 별도로 관측 차이이상인 비율을 구합니다. 두 비율 중 작은 것의 두 배를 계산하고 최대 1로 제한합니다.
같은 값은 양쪽 해당 꼬리에 모두 포함합니다. 이는 정의를 명시한 양측 p값이며 정의가 보편적으로 하나인 것은 아닙니다. 비대칭 이산 분포에서는 abs(null) >= abs(observed)를 세는 방법과 항상 같지 않습니다. 예를 들어 신청자가 0명인 2명의 A 집단과 신청자가 2명인 5명의 B 집단은 관측 차이가 +40포인트입니다. 21개 배정에서 −100은 한 번, −30은 열 번, +40은 열 번 나옵니다. 정의된 p값은 2 * 10 / 21 = 20/21이지만 절대값 꼬리 비율은 11/21입니다. 더 작은 수를 얻기 위해 집단 구성이나 정의를 몰래 바꾸면 안 됩니다.
준비된 SciPy permutation_test 인터페이스를 사용합니다. permutation_type="independent"는 독립 집단 사이에 관측을 재배분하며 크기를 유지합니다. 방문자를 짝지어진 측정값으로 취급하지 않습니다. vectorized=False는 통계량 함수가 일반 1차원 배열을 받는다는 뜻입니다. n_resamples=np.inf는 무작위 추출 399회 대신 유한 분포 전체를 요청합니다. alternative="two-sided"는 위 규칙을 선택합니다. 이 정확 열거에는 무작위 시드가 필요하지 않습니다.
DataFrame 선택 .loc[mask, "signed_up"]는 해당 사람의 열을 선택하고 .to_numpy()는 값을 1차원 NumPy 배열로 바꿉니다. 내부 statistic 함수는 앞선 실습과 같은 차이 공식을 사용하며 여기서 완전히 정의합니다. 따라서 다른 VM의 resample.py에 의존하지 않습니다.
result.statistic, result.pvalue, result.null_distribution은 실제로 계산된 값입니다. 반올림하지 않은 수치를 보존하세요. .tolist()는 서로 다른 배정의 중복 차이를 제거하지 않고 배열을 JSON 호환 목록으로 바꿉니다.
셸의 >는 파일을 교체하며 따옴표로 감싼 히어 도큐먼트 <<'PY'는 마지막 PY까지의 전체 블록을 셸 확장 없이 복사합니다. 대신 WebIDE에서 편집하고 File → Save를 사용해도 됩니다.
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
실행기의 distribution 단계는 분석을 호출하고 아직 해석 함수를 요구하지 않은 채 실제 결과를 저장합니다.
python3 run.py distribution
읽기 프로그램은 기존 데이터를 표시하며 긴 배열을 생략하는 곳은 터미널 표시뿐입니다.
python3 show_results.py exact
12명, A 여섯 명 중 한 명과 B 여섯 명 중 다섯 명의 신청, 약 +66.67포인트의 관측 차이, null_count 924, p 약 0.08009를 예상하세요. 전체 분포는 output/analysis.json에 남습니다. 해석 필드는 다음 단계에서 추가합니다.
inference.py와 plot.py를 편집하거나 같은 위치에 일반 Python 보조 파일을 추가할 수 있습니다. 원본 CSV, 설정, 사전, 실행기, 읽기 프로그램을 보존하세요. 준비된 outcomes.py와 compare.py는 앞서 배운 함수를 구현합니다. 공개 DataFrame/객체 계약과 유효한 결과가 유지되면 동등한 구현도 허용합니다. 격리된 검사는 범위 안의 다른 집단 크기, 반대 방향, 0 차이, 전부 0인 결과를 다룹니다. 고정 p값이나 고정 분포는 재사용 가능한 분석이 아닙니다.
일반적인 경로나 파일 이름 오류에는 pwd와 ls를 사용하고 시작의 cd를 반복한 다음 전체 블록을 다시 복사하세요. 설정은 편집 복구 도구가 아닙니다. 기존 작업 공간을 의도적으로 덮어쓰지 않습니다.
증거와 확실성 구분하기
이 단계에서는 어느 방향이든 또는 증거 부족을 보고할 수 있는 투명한 해석 규칙을 추가합니다.
같은 WebIDE 터미널의 /home/labex/project/signup-experiment에서 계속합니다. p값은 선택한 귀무 가정과 배정 설계 아래의 비교를 나타냅니다. 귀무 가정이 참일 확률이 아니며, 페이지 효과가 없을 확률이나 다음 워크숍의 보장도 아닙니다.
여기서는 관측된 약 +66.67포인트가 커 보이지만 정확 p값은 약 0.08009입니다. 이 작은 고정 표본과 미리 선택한 알파 0.05에서 연습은 증거 불충분을 보고합니다. 페이지가 같음을 입증하는 것은 아닙니다. 이 특정 검정과 표본이 귀무 가정에 반하는 선택된 수준의 증거를 제공하지 못한다는 뜻입니다.
다음의 명시적인 출력 라벨을 사용합니다.
- p <= alpha이고 차이가 양수면
evidence_for_b. - p <= alpha이고 차이가 음수면
evidence_for_a. - 차이가 0일 때를 포함해 그 외에는
inconclusive.
기준과 같은 경우는 증거 분기에 들어갑니다. p == alpha는 <=를 만족합니다. 비교 전에 p를 반올림하지 마세요. 이는 제한된 분석의 라벨이며 자동 사업 도입 결정이 아닙니다. 다른 유효한 실험은 A 또는 어느 페이지도 지지하지 않을 수 있습니다. B에 유리한 라벨은 필수가 아닙니다.
셸의 >>는 기존 파일을 교체하지 않고 덧붙입니다. 다음 전체 블록은 analyze 아래에 conclude를 추가하므로 한 번만 붙여 넣으세요. WebIDE로 편집하면 끝에 함수를 추가하고 저장합니다. Python의 and는 분기가 라벨을 반환하기 전에 두 조건을 모두 요구합니다.
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
해석 단계를 통해 정확 분석을 다시 실행합니다. 결과 파일을 라벨도 포함한 완전한 현재 분석으로 의도적으로 교체합니다.
python3 run.py exact
python3 show_results.py exact
이 전체 표본의 결과는 inconclusive여야 합니다. 관측 차이, 원래 p값, 배정 차이 924개는 그대로입니다. 원하는 라벨을 얻으려고 사람을 제외하거나 날짜를 고르거나 실제 집단을 재배정하거나 탐색용 무작위 표본으로 대체하지 마세요. 필요한 7일 추적은 모두 끝났습니다. 중단 규칙을 바꾸거나 데이터를 추가하는 것은 이 연습 범위 밖입니다.
정확한 증거를 읽기 쉽게 저장하기
이 단계에서는 저장된 전체 배정 분포를 그리고 맥락을 숨기지 않고 관측 비교를 표시합니다.
같은 WebIDE 터미널의 /home/labex/project/signup-experiment에서 계속합니다. 이 그래프는 다른 단원의 탐색 표본이 아니라 result["analysis"]의 정확 분포를 사용합니다. np.unique(..., return_counts=True)는 각 차이를 만드는 서로 다른 배정 수를 셉니다. 현재 데이터에서 높이의 합은 924여야 합니다. 반복된 값은 의미가 있으므로 원래 분포에서 중복을 제거하면 안 됩니다.
정확 분포 꼬리의 일부 횟수는 배정 하나뿐입니다. 보이는 점 마커는 이런 드문 횟수도 0 기준선 위에서 읽을 수 있게 합니다. 연결선은 이산적인 점을 따라가게 도울 뿐, 사이의 모든 차이가 가능하다는 뜻은 아닙니다.
가로 좌표는 B−A의 퍼센트포인트 차이, 세로 좌표는 배정 횟수입니다. 보이는 Observed 표시는 실제 비교의 위치를 나타냅니다. 제목의 반올림된 p값은 표시 편의용이며 저장된 숫자와 해석에는 반올림하지 않은 값을 씁니다. 정당한 0과 경계값을 포함하여 가능한 전체 차이 범위와 횟수 0 기준선이 보여야 합니다.
최소 500 × 250픽셀의 PNG를 저장합니다. 앞선 실습처럼 9 × 4.5인치 그림을 DPI 140으로 저장하면 약 1260 × 630픽셀이며, 읽기 쉬운 축과 드문 횟수 마커를 배치할 공간이 생깁니다.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
실제 저장된 분석에서 PNG를 생성합니다.
python3 run.py plot-exact
WebIDE 파일 탐색기에서 signup-experiment/output을 펼치고 evidence.png를 엽니다. 0 주변의 분포와 +66.67 근처 관측 표시를 찾으세요. 옆에서 읽기 프로그램으로 output/analysis.json을 읽습니다. 12명, 두 배정 분모, 원래 차이, 정확 p, 알파, inconclusive 라벨이 함께 증거를 이룹니다. 그래프 하나만으로 올바른 분석을 증명하지는 못합니다.
아래 참조는 이 guided 데이터와 제공된 그리기 코드로 실제 저장한 그래프입니다. 점은 양쪽 꼬리의 드문 배정 횟수를 포함하며 선은 가능한 차이만 연결합니다. 저장된 수치 결과와 함께 읽으세요.
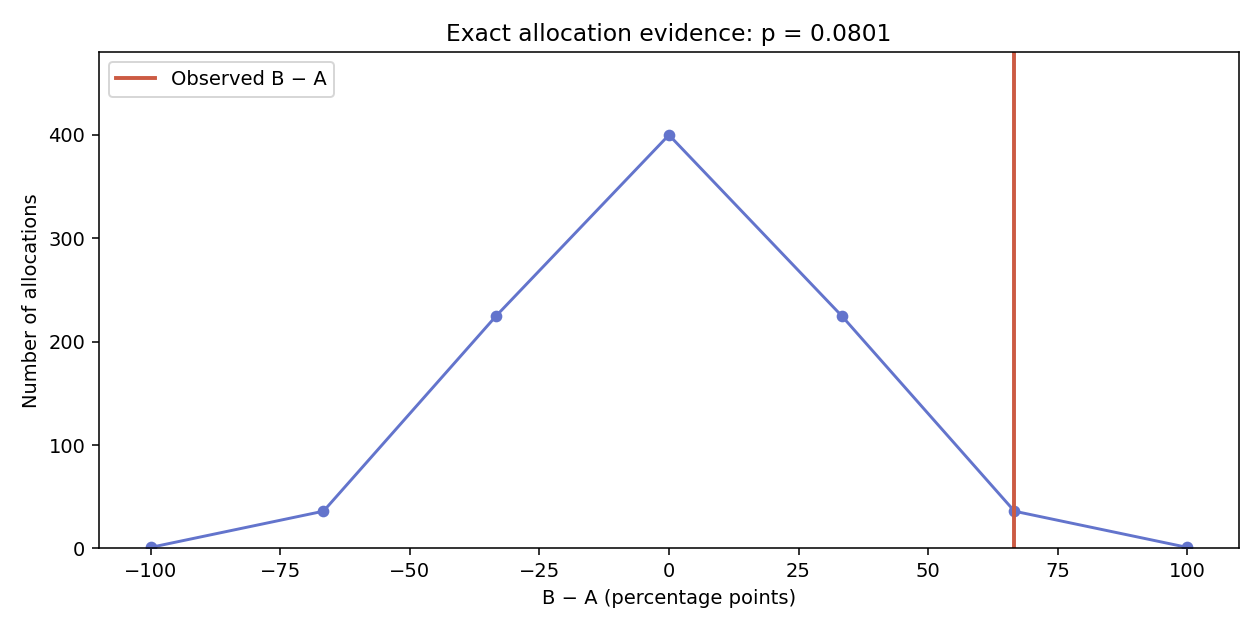
실제 차이 값에 읽기 쉬운 막대, 횟수 선 또는 점을 사용할 수 있습니다. 관측 비교에는 Observed 라벨이 있는 보이는 선이나 점이, 양 축에는 의미 있는 라벨이 필요합니다. 가능한 값 전체, 관측 표시, 0 기준선을 보이게 유지하세요. PNG는 실제 저장 데이터와 현재 그리기 함수에서 디코딩되고 재현 가능해야 합니다. 보이지 않는 선, 축 밖의 표시, 잘린 그림, 무관한 이미지는 통과하지 못합니다. PNG가 없으면 먼저 python3 show_results.py exact로 저장된 정확 결과를 확인하고 그리기 명령을 다시 실행하세요. 읽기 프로그램은 복구하지 않습니다.
명시한 가정과 규칙 아래에서 하나의 합성 무작위 실험 표본을 분석했습니다. 실제 사업 결과를 측정하거나 페이지가 같음을 입증하거나 관측 효과가 실제 운영에서도 지속된다고 확정한 것은 아닙니다.
요약
제한된 정확 분포를 열거하고 등호를 포함하는 두 꼬리로 정의한 양측 p값을 사용했으며, 사전 선택한 기준을 반올림 없이 적용하고 실제 그래프를 저장했습니다. 작은 표본에서는 큰 차이도 증거가 불충분할 수 있습니다. 증거 부족은 페이지가 같다는 증명이 아닙니다. 독립 챌린지에서 같은 절차를 다른 배정과 이벤트 기록에 적용합니다.