소개
스튜디오에 이제 정직한 예측 경계가 있습니다. 작은 회귀 모델이 초기 참석 중앙값보다 재료 계획 추정을 개선할까요? 짧은 Pipeline을 학습하고 동일한 레이블 있는 워크숍에서 두 방법을 비교하여 실제 비교 이미지와 미래 예측을 저장합니다.
Python 함수, pandas 선택과 결합, 기본 Scikit-learn 회귀 및 학습/테스트 개념, 기초 Matplotlib이 필요합니다. 이전 가이드 랩은 7일 전 마감과 학습 데이터에서만 배우는 결측값 대체를 설명합니다. 이 랩은 완성된 ID/날짜 분할을 포함해 모든 파일을 독립적으로 준비하므로 이전 VM 파일이 필요 없습니다. 모든 데이터는 직접 만든 합성 교육 자료이며, 60분은 저자의 추정입니다.
초기 워크숍에서 작은 Pipeline 학습하기
이 단계에서는 그럴듯한 행사 이후 모델을 재사용 가능한 7일 전 예측기로 바꿉니다.
WebIDE → Terminal → New Terminal에서 시작합니다. cd는 현재 터미널의 작업 디렉터리를 바꿉니다. 준비된 실행 파일 ./python은 과정 환경을 시작하며, ./는 시스템 인터프리터 대신 현재 디렉터리의 실행기를 선택합니다.
cd /home/labex/project/workshop-attendance
cat은 파일을 수정하지 않고 보여 줍니다. 여러 파일명을 인수로 주면 차례로 표시합니다.
cat season.json history.csv labels.csv future.csv
각 과거 행은 session_id가 키인 워크숍입니다. labels.csv는 별도 순서에서 이 키로 actual_attendance를 연결합니다. 허용된 수치 모델 특성은 행사 정확히 7일 전 저장된 booked_7d와 그 마감에 이미 공지된 duration_minutes뿐입니다. 수치 빈 셀은 결측 정보이며, 허용된 특성마다 비어 있지 않은 학습 관측이 있습니다. ID와 날짜는 연결과 분할용이지 모델 입력이 아닙니다. final_bookings와 scanned_entries는 행사 때 생기므로 7일 전에는 알 수 없는 정보를 누출합니다.
완성된 분할은 2026년 4월 1일 00:00 UTC에 학습을 고정하고, 4월 12일 이후 과거 행사를 평가용으로 둡니다. 학습 레이블은 각 초기 행사 당일 종료까지 알려지며, 여기서 마지막 학습 행사는 3월 8일입니다. 첫 홀드아웃 예측은 4월 5일에 이미 고정된 모델과 해당 행사의 7일 전 스냅숏을 사용합니다. 4월 5일 입력을 4월 1일에 알았다고 주장하지 않습니다. 이후 스냅숏 파일은 해당 이후 예측 날짜를 재현합니다. future.csv에는 실제 레이블이 없으므로 5월 행사에는 예측만 있고 측정 오차는 없습니다. 설정 간격에 과거 행은 없습니다. 순차 재학습이나 학습 특성 전체 결측은 다루지 않습니다.
cat split.py
키 기반 merge, 해석한 날짜 경계, 날짜 정렬을 살펴보세요. 이전 수업에서 완성한 분할을 독립 실행을 위해 제공합니다. 이 파일과 모든 CSV/JSON 입력, python, run.py, coursekit.py, show_results.py, starter-*.py를 보존하세요. model.py, chart.py, 자신의 output/ 산출물만 편집합니다. 제공된 model.py는 스캔 기반 모델로 시작합니다. 과거 결과가 완벽해 보여도 잘못된 정보 선택을 정당화하지 못합니다.
Pipeline은 전처리와 모델을 연결합니다. fit 중 대체기는 전달된 학습 특성에서 평균을 배우고, 회귀는 채워진 학습 행렬에서 학습합니다. predict 중 같은 대체기는 이후 입력을 변환만 합니다. 홀드아웃이나 미래에서 다시 학습하지 않습니다. LinearRegression은 보통 최소제곱법으로 절편과 특성 계수를 맞춥니다. 여러 대안을 조정하는 대신 이 작은 모델을 유지합니다.
재사용 가능한 두 모델 함수를 작성합니다. FEATURES는 정확히 ['booked_7d', 'duration_minutes']입니다. fit_model은 학습된 추정기와 학습 목표 중앙값을 반환합니다. predict_events는 모든 입력 표에서 같은 허용 특성을 선택합니다. 임시 evaluate는 다음 단계에서 완성하며, fit 단계는 호출하지 않습니다.
셸의 >는 파일을 덮어씁니다. <<'PY'는 따옴표로 감싼 here-document를 시작합니다. PY만 있는 마지막 줄까지 붙여 넣으면 셸은 Python을 그대로 저장합니다. WebIDE Explorer에서 model.py를 편집하고 File → Save를 선택해도 됩니다.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
저장된 미리보기에서 W-88은 원시 예측 약 32.718, 실제 인원 46, 기준선 24.5에 연결되어야 합니다. W-09는 예측 약 62.236, 실제 74, 같은 기준선이어야 합니다. 실제 인원이 정수여도 회귀 출력은 소수일 수 있습니다.
./python show_results.py fit
이것은 오차 요약 전 예측이며 이후 레이블 없이 학습했습니다. 레이블 변경은 최종 오차를 바꾸어야 하지만 학습된 예측을 바꾸면 안 됩니다. 학습 계수가 0인 특성은 영향을 주지 않아도 정당합니다. 임의 입력 변화가 반드시 예측을 바꾸지는 않습니다.
같은 홀드아웃에서 연속값 오차 비교하기
이 단계에서는 실제 홀드아웃 레이블로 절대 오차를 계산하고 인원 단위 평균을 비교합니다.
WebIDE의 /home/labex/project/workshop-attendance에서 계속합니다. 절대 오차는 actual - predicted의 크기입니다. np.abs는 원소별로 계산하고 np.mean은 결과 배열을 평균냅니다. 공정한 기준선을 위해 같은 각 실제 홀드아웃 레이블에서 동일한 초기 목표 중앙값을 뺍니다. 다른 행사 집합을 비교하거나 실제 결과를 예측으로 대체하지 마세요.
모든 오차와 MAE에 반올림하지 않은 연속 예측을 사용합니다. 먼저 표시 인원으로 반올림하면 평가가 바뀝니다. 보조 프로그램은 읽기 쉽게 콘솔 MAE를 소수점 아래 세 자리로 표시하지만, JSON에는 반올림하지 않은 수치를 저장합니다.
model.py를 다음 완성본으로 바꿉니다. 학습과 예측 로직을 유지하고 비어 있던 evaluate 함수를 완성합니다. 함수는 행사별 오차 배열과 평균을 반환하며, 보조 프로그램은 output/holdout.csv를 쓸 때 같은 홀드아웃 행의 ID를 유지합니다. 오차 벡터는 전달된 실제/예측 배열의 위치 순서를 따릅니다. pandas Series를 포함한 동등한 배열 유사 값도 그 순서로 허용합니다. Series의 수치 인덱스 레이블은 워크숍 ID가 아닙니다.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
예상 콘솔 요약:
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
W-88의 모델 오차는 약 13.282명, 기준선 오차는 21.5입니다. W-09는 약 11.764와 49.5입니다. 반올림하지 않은 평균은 약 12.5230751656명과 정확히 35.5명입니다. 앞선 연습의 기준선은 18이었지만 전체 시즌의 학습 중앙값은 24.5입니다. 다른 초기 표본을 사용하기 때문입니다.
여기서는 작은 모델이 두 홀드아웃 행사에서 오차가 더 낮습니다. 이는 작은 합성 홀드아웃에 관한 증거이지 미래 신뢰성이나 예약의 인과 효과 증명은 아닙니다. 올바른 모델의 MAE가 더 높다면 이 비교를 개선하지 못했다는 것이 정직한 결론입니다. 평가는 모델이 기준선을 이기도록 요구하지 않으며, 상수 또는 정보 없는 특성도 유효합니다.
그래프와 레이블 없는 미래 예측 전달하기
이 단계에서는 홀드아웃 비교를 읽기 쉽게 만들고 실제 결과를 지어내지 않고 미래 추정값을 내보냅니다.
WebIDE의 /home/labex/project/workshop-attendance에서 계속합니다. 그래프는 비교 표의 인원 단위 원시 값을 사용하여 각 홀드아웃 ID마다 Actual, Model, Baseline 계열 값을 하나씩 그려야 합니다. 선 또는 산점도 모두 적합하며 레이블과 ID가 의미를 분명히 합니다. PNG는 읽을 수 있고 600×300픽셀 이상이어야 하며 같은 데이터로 재실행하면 같은 보이는 그래프를 재현해야 합니다. 스타일은 달라도 됩니다. 평가는 자기 보고 그래프 명세가 아니라 실제 그린 값과 저장 이미지를 확인합니다. 모든 업무상 점은 보이는 축 범위 안에 있어야 하고, 필수 계열을 숨기거나 완전히 투명하게 만들면 안 됩니다. 경계와 정확히 같은 점도 허용하며 색과 축 범위는 달라도 됩니다.
Matplotlib의 Agg 백엔드는 데스크톱 창 없이 이미지를 씁니다. subplots는 그림과 축을 만들고, plot은 ID에 연결된 계열을 그립니다. 아래 마커 문자열은 빈 실제 원, 모델 마름모, 점선 기준선 십자를 구분하므로 실제와 기준선이 겹쳐도 식별됩니다. tight_layout은 레이블 공간을 확보하고, savefig는 실제 PNG를 쓰고, close는 그림을 해제합니다.
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
먼저 무해한 오타를 연습합니다. 다음 명령은 일부러 잘못된 단계 이름을 써서 인수 오류로 종료하며 저장 결과를 바꾸지 않습니다.
./python run.py delvier
메시지에 허용된 선택지가 나옵니다. 철자를 고쳐 전달 단계를 실행합니다. 대신 파일 없음 오류가 나면 pwd와 ls를 사용하고 처음의 cd로 돌아가 올바른 파일명을 시도하세요.
./python run.py deliver
./python show_results.py deliver
읽기 프로그램은 저장된 CSV/JSON을 읽고 실제 PNG를 디코딩합니다. 입력에서 결과를 보충하지 않습니다. WebIDE Explorer에서 output을 펼치고 comparison.png를 엽니다. 모델은 두 실제 인원 점보다 아래, 기준선은 24.5에 있어야 합니다. 다른 마커를 사용하면 같은 값의 계열도 구분됩니다. 이미지 옆에서 holdout.csv를 검사하여 각 점을 ID와 실제 오차에 연결하세요.
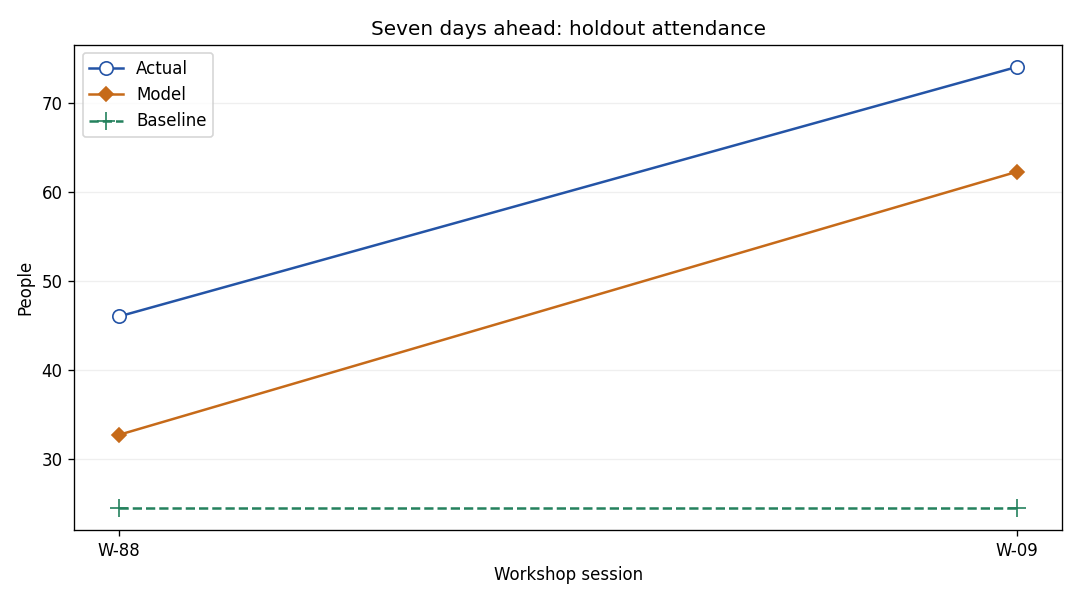
제공 데이터 예시는 W-88과 W-09의 실제 인원 46과 74, 모델 예측 약 32.718과 62.236, 점선 기준선 24.5를 보여 줍니다. 실제 점과 예측 사이의 세로 거리는 해당 행사의 절대 오차입니다. 스타일은 달라도 ID와 기초 값은 일치해야 합니다.
forecast.csv에는 session_id, 원시 model_prediction, display_people만 있습니다. F-6의 예측은 약 19.119, 표시 인원은 19이고, F-101은 약 25.245, 표시는 25입니다. 표시만을 위해 보조 프로그램은 음수 추정을 0으로 제한하고 floor(max(raw, 0) + 0.5)로 절반을 위로 반올림합니다. 이것은 실용적인 표현 규칙이지 평가 모델의 변경이 아닙니다. 원시 예측은 음수나 소수여도 보존됩니다.
미래 실제 인원이나 미래 MAE를 만들어 내지 않습니다. 이후 예측 스냅숏이 도착하기 전에 모델을 고정할 수 있습니다. 각 5월 행사 7일 전 마감에 기존 모델과 해당 행사에 저장된 알려진 특성을 재사용합니다. 작은 합성 표본, 누락된 스냅숏, 달라지는 참석 행동은 분석의 한계입니다. 독립 챌린지는 같은 작업 흐름을 유지하며 시즌과 날짜를 바꿉니다. ID 관계가 정확하면 동등한 수치 구현, 출력 행 순서, 선/산점도 스타일을 1e-8 수치 허용 오차로 허용합니다.
요약
초기 워크숍에서 작은 대체/회귀 Pipeline을 학습하고, 원래의 홀드아웃 오차를 학습 중앙값 기준선과 비교해 ID로 연결된 비교 그림을 저장했습니다. 알려지지 않은 미래 결과를 평가에서 제외하면서 미래 추정도 내보냈습니다. 더 낮은 홀드아웃 MAE는 이 제한적인 비교를 뒷받침할 수 있습니다. 정직하게 계산했다면 더 나쁜 결과도 똑같이 유효합니다.