소개
Meridian Museum은 방문자가 재료와 이야기를 바탕으로 소장품을 찾도록 돕습니다. 홈페이지가 응답하더라도 소장품 검색은 아직 사용할 수 없을 수 있습니다. 새 검색 컨테이너는 제공된 레코드 12개를 메모리의 단어 색인으로 가져옵니다. 로딩을 관찰할 수 있도록 가져오기 간격을 의도적으로 두었으며, 교체 컨테이너는 각자 처음부터 색인을 만듭니다.
이 실습에서는 로딩 중인 Pod를 방문자 Service에서 제외하고, 시작에 충분한 시간을 부여하며, 기존 복제본이 올바른 검색 결과를 제공하는 동안 가져오기 프로그램을 업데이트합니다. 기본 터미널 사용법과 컨테이너 이미지 및 실행 중인 컨테이너에 익숙해야 합니다. Kubernetes 객체, YAML 패치, 프로브 설정은 여기서 소개합니다. 클러스터, 캐시된 박물관 이미지, 완전한 웹사이트가 준비되어 있으므로 설치, 외부 계정, 애플리케이션 프로그래밍은 필요하지 않습니다.
방문자 작업에는 Museum, 명령에는 Workstation을 사용하세요. meridian 네임스페이스와 제공된 박물관 작업 공간에서만 작업합니다. 단일 노드 학습 클러스터이며, 고가용성이나 요청 실패가 없음을 보장하지 않습니다. 각 실습은 독립적으로 시작합니다.
검색 가능한 Pod에만 방문자 요청 보내기
실행 중인 프로세스와 사용 가능한 검색 색인을 구분하고 실제 방문자 작업에 맞는 준비 상태 검사를 추가합니다. Museum에서 시작하세요.
정상적인 방문자 경로 사용하기
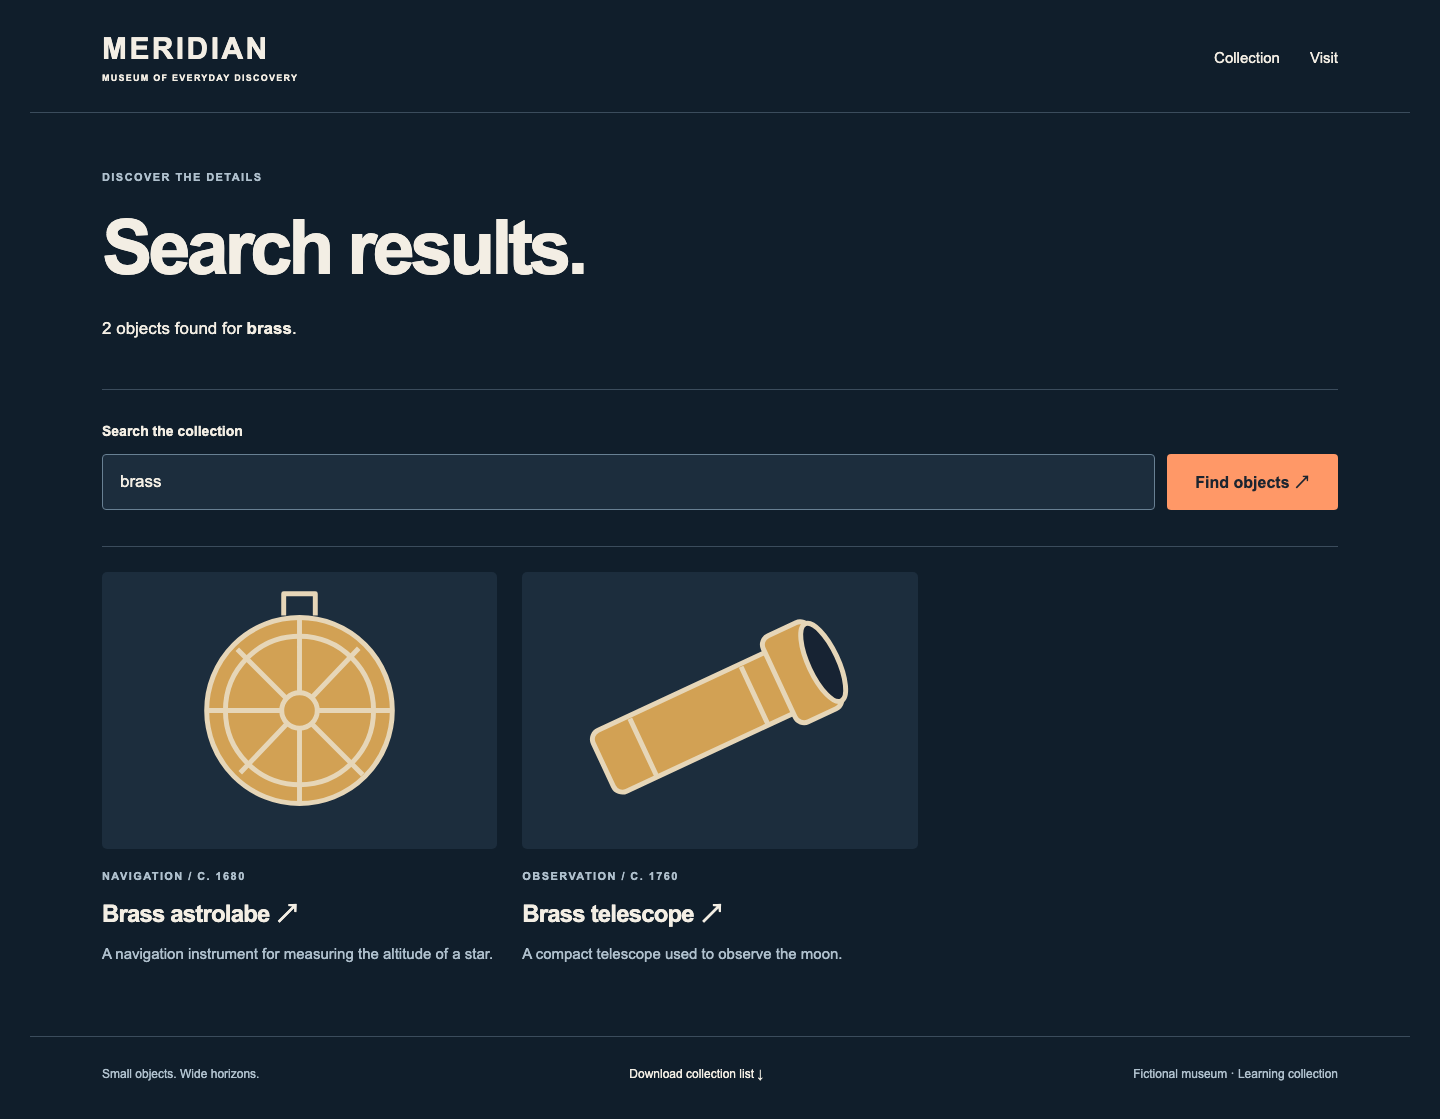
Search the collection에 brass를 입력하고 Find objects ↗를 선택합니다. 결과에 Brass astrolabe, Brass telescope, 2 objects found가 표시되어야 합니다. Brass astrolabe를 열면 이야기, 삽화, Gallery 1 위치가 나옵니다. See it at the museum ↗를 선택하여 개관 시간과 단차 없는 입구 안내를 읽고 Download collection list ↓를 선택합니다. 다운로드한 CSV를 열어 두 황동 기구를 포함한 소장품 12개를 확인합니다. MERIDIAN으로 홈에 돌아갑니다. 변경 후에도 이 기능들을 유지해야 합니다.
Kubernetes 객체 세 가지 알아보기
Workstation으로 전환합니다. pwd는 현재 디렉터리를, ls는 파일 목록을 출력합니다.
pwd
ls
디렉터리는 /home/labex/project/museum입니다. Pod는 박물관 컨테이너를 실행합니다. Deployment는 복제본 Pod 두 개를 유지하고 컨테이너 템플릿이 바뀌면 교체합니다. Service는 방문자에게 고정 주소를 제공하며 선택된 준비 완료 Pod로 요청을 보냅니다. 레이블이 객체를 연결합니다. Service는 app: search인 Pod를 선택합니다. 네임스페이스는 이 과정의 객체를 묶으며, 아래 모든 명령은 meridian을 명시합니다.
kubectl은 클러스터에 객체 조회나 변경을 요청합니다. get은 목록을 보여 주고 -n은 네임스페이스를 선택합니다. cat으로 텍스트 파일을 출력하여 준비된 후보를 읽습니다.
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML은 key: value, 공백 들여쓰기, 목록 항목의 -를 사용합니다. spec.template 아래 컨테이너는 캐시된 meridian-museum:1 이미지를 사용합니다. imagePullPolicy: Never는 레지스트리에서 다운로드하지 않고 준비된 이미지를 사용하라는 뜻입니다. IMPORT_INTERVAL: "2"는 레코드를 2초 간격으로 가져오므로 12개에 약 24초가 걸립니다. 초기 방문자 복제본은 짧은 간격을 사용하여 먼저 정상 검색을 경험할 수 있었습니다.
준비된 롤링 업데이트는 replicas: 2를 유지하며 추가 후보 하나를 허용하고(maxSurge: 1), 기존 복제본의 사용 불가를 허용하지 않습니다(maxUnavailable: 0). 이는 정직한 준비 상태에 의존합니다. 프로브가 없으면 검색이 작동하기 전에도 실행 중인 프로세스가 대상이 될 수 있습니다. 이 설정, 이미지, 레이블, Service를 그대로 유지하세요.
학습용 Service에서 너무 이른 트래픽 관찰하기
브라우저는 요청과 응답 프로토콜인 HTTP를 사용합니다. 상태 200은 성공, 503은 서버가 일시적으로 해당 요청을 처리할 수 없다는 뜻입니다. 홈페이지가 작동한다고 검색처럼 다른 요청도 성공하는 것은 아닙니다.
이 박물관에는 실제 고객이 없습니다. 개선 전에 안전하지 않은 업데이트를 의도적으로 시연합니다. cp는 후보를 편집 가능한 search.yaml로 복사합니다. apply -f는 파일의 YAML을 제출하고 변경된 Pod 템플릿이 업데이트를 시작합니다. python3는 제공된 읽기 전용 관찰기를 실행하고, --seconds 30은 실제 방문자 Service를 30초 동안 표본 조사합니다. 검색 응답에 두 황동 소장품이 있는지 확인합니다. 업데이트와 관찰기를 함께 실행합니다.
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
보호되지 않은 새 컨테이너가 로딩되는 동안 HTTP=503 correct_search=false 줄이 일부 나타날 것입니다. 횟수는 달라집니다. 홈페이지는 계속 작동하고, 검색의 503 응답은 컬렉션을 준비 중이라고 명시합니다. 이는 로딩 중인 Pod의 실제 응답이며, 성공과 실패를 연출한 애니메이션이 아닙니다.
rollout status는 이 Deployment의 업데이트를 기다리고 --timeout은 대기 시간을 제한합니다.
kubectl rollout status deployment/search -n meridian --timeout=90s
이전 로딩 기간을 readiness 프로브가 보호하지 않았더라도 성공을 보고할 수 있습니다. 정상적인 brass 결과가 돌아온 뒤 계속하세요. HTTP 상태 대신 연결 오류가 나오면 Pod 표를 읽고 재시도합니다. 서버가 없는 상태와 서버가 503을 반환하는 상태는 다릅니다.
실제 업무 준비 상태 검사 추가하기
readiness 프로브는 이 Pod가 Service 트래픽을 받아야 하는지 확인합니다. 실패하면 대상에서 제외하지만 컨테이너를 재시작하지 않습니다. 이 이미지의 /health/process는 항상 HTTP 프로세스를 보고하고, /ready/search는 레코드 12개의 색인이 완성되고 알려진 brass 검색이 작동할 때만 200을 반환합니다. 홈페이지도 가져오기 중 200을 반환하므로 홈페이지와 프로세스 엔드포인트 모두 적합하지 않습니다.
patch는 선택한 필드를 바꿉니다. --patch-file은 파일을 읽고, --type=strategic은 이름이 search인 컨테이너를 다른 설정을 보존하며 병합합니다. 프로브는 이 Pod의 이름 있는 http 포트로 HTTP를 보내고 2초마다 검사하며 한 번 실패하면 준비되지 않음으로 표시합니다. 아래 작은 패치를 작성하세요. cat > readiness.yaml은 파일을 대체합니다. <<'YAML'은 내용 그대로 처리하는 히어 도큐먼트를 시작합니다. 마지막 줄에 단독으로 놓인 YAML까지 전체 블록을 붙여 넣고 공백을 유지하세요.
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
새 복제본이 가져오는 동안 기존 복제본을 통해 올바른 검색이 계속되어야 합니다.
EndpointSlice는 Service의 실제 Pod 주소와 준비 상태를 기록합니다. -l은 서비스 이름 레이블로 필터링하고, -o jsonpath는 구조화된 응답에서 주소와 ready 필드만 선택합니다. 제공된 표시식은 엔드포인트를 순회하며 필드를 출력할 뿐 상태를 변경하지 않습니다. Pod와 Service 주소를 확인합니다.
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
가져오기 중 새 0/1 Running Pod와 ready=false 주소가 보일 수 있습니다. 기존 준비 완료 엔드포인트는 계속 검색을 처리합니다. 로딩이 끝나면 후보가 준비되고 교체가 진행됩니다. 짧은 중간 상태를 놓쳤다면 다음 단계에서 더 긴 관찰 시간이 제공됩니다.
마지막에는 정확히 두 개의 1/1 Running Pod가 있어야 합니다. 업데이트 성공 후에도 오래된 Terminating Pod가 잠시 남을 수 있으므로 사라질 때까지 기다리며 get pods를 반복합니다. Museum에서 brass 검색과 아스트롤라베 상세를 다시 확인합니다. YAML 오류라면 패치를 수정하여 다시 적용합니다. 프로브 경로 오타라면 같은 패치에서 경로만 고친 뒤 적용합니다. 다른 네임스페이스를 삭제하거나 오류를 숨기기 위해 가져오기를 단축하지 마세요.
가져오기 프로그램에 충분한 시작 시간 주기
준비 상태 대기와 시작 실패를 구분하고 실제 가져오기 시간으로 시작 예산을 정합니다. Workstation에서 시작합니다.
startup 프로브는 새 컨테이너 초기화에 허용되는 시간을 제한합니다. 성공하기 전까지 Kubernetes는 readiness 검사를 보류합니다. 시작 실패가 임계값에 도달하면 kubelet이 컨테이너를 재시작합니다. startup 프로브는 선택 사항이며, 너무 짧게 추가하면 정상 작동할 앱도 준비 완료가 되지 못할 수 있습니다. 시작 후 readiness를 대체하지 않습니다.
너무 짧은 예산 관찰하기
startup-short.yaml은 제공된 학습 예제입니다. startup 프로브 실패는 재시작을 요청하지만 종료 처리 때문에 화면의 재시작 횟수 증가가 늦어질 수 있습니다. 다음 클라이언트 대기는 60초 동안 이 차이를 관찰합니다. 적용 전에 예제를 읽으세요.
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
업데이트 명령은 error: timed out waiting for the condition으로 실패할 예정이며 실제 종료 상태는 0이 아닙니다. 이 대화형 터미널에서 계속하세요. 예제는 2초마다 검사하고 두 번의 실패만 허용하므로 약 4초의 시작 창입니다. 24초 가져오기를 수용할 수 없습니다.
실제 증거를 읽습니다. logs는 애플리케이션 출력을 보여 주고, --prefix는 각 Pod를 식별하며, --tail=4는 각 로그를 마지막 네 줄로 제한합니다. 선택자로 모든 검색 Pod를 요청합니다. get events는 클러스터 관측 내용을 읽고, --field-selector reason=Unhealthy는 실패한 상태 검사로 범위를 좁힙니다.
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
새 Pod는 준비되지 않은 채로 남고 RESTARTS가 증가해야 합니다. CrashLoopBackOff가 보이면 Kubernetes가 다음 재시작 시도를 지연하는 것입니다. 시작 실패가 기록되는데 표가 아직 0이면 예산을 바꾸기 전에 기다렸다가 get pods를 반복하세요. 표는 한순간의 관찰이고 종료에는 시간이 걸립니다. 재시작할 때마다 메모리 색인이 사라지므로 교체 컨테이너는 레코드를 다시 가져옵니다.
이미 startup 검사에 실패한 컨테이너의 늦은 index_complete 줄은 예정된 재시작을 취소하거나 준비 완료 Service 백엔드로 만들지 않습니다. 재시작 횟수와 시작 실패 이벤트를 함께 읽으세요. 이전 Pod는 1/1을 유지하고 완성된 색인으로 응답합니다.
Museum에서 brass를 검색합니다. 기존 준비 완료 복제본을 통해 Service가 올바른 결과를 계속 반환합니다. 멈춘 업데이트는 자동 롤백되지 않았으며 Deployment는 여전히 잘못된 후보를 요구합니다. 기존 서비스가 유지되는 것과 업데이트 완료를 혼동하지 마세요.
유용한 예산 계산 및 적용하기
Workstation으로 돌아갑니다. 12개를 2초 간격으로 가져오면 약 24초입니다. 여기서는 60초를 사용해 다음 36초 가져오기와 학습용 여유 12초도 수용합니다. periodSeconds × failureThreshold는 계획용 근사치이며 기한 보장이 아닙니다. 스케줄링, 프로브 시간 초과, 실제 부하에 따라 달라집니다. 운영 환경에서는 시작을 측정하고 여유를 신중하게 정하세요.
같은 패치 파일 방법을 사용하며 실제 업무 경로와 이름 있는 포트를 유지합니다.
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
수정된 startup 설정으로 교체 Pod가 만들어집니다. 각 Pod는 재시작 없이 로딩을 마쳐야 하며 최종 표에는 RESTARTS 0인 1/1 Running Pod 두 개가 있어야 합니다. 종료 중인 이전 Pod가 사라지기를 기다리고 필요하면 표를 반복합니다. 시작 성공 후에도 readiness가 트래픽을 제어합니다.
계속 멈춘다면 같은 로그와 이벤트를 읽고 파일의 경로와 예산을 비교한 뒤 수정하여 다시 적용합니다. Pod 삭제는 Deployment 템플릿을 고치지 않으므로 같은 오류 설정으로 다시 생성됩니다. 60초 프로브 예산과 --timeout=120s를 구분하세요. 후자는 클라이언트가 업데이트를 기다리는 시간만 제한합니다.
더 느린 업데이트에서도 검색 유지하기
더 느린 가져오기를 적용하고 Service 응답과 준비 완료 엔드포인트로 업데이트를 평가합니다. Workstation에서 시작합니다.
kubectl set env는 Deployment 컨테이너 템플릿의 환경 변수를 바꿉니다. 교체 Pod를 시작하며 이미 실행 중인 컨테이너의 환경은 바꾸지 않습니다. 간격을 3초로 정하면 12개에 약 36초가 걸려 60초 시작 예산 안에 들어갑니다.
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
가져오기 중 새 Pod는 0/1 Running이어야 합니다. 기존 준비 완료 주소는 올바른 brass 결과를 계속 반환합니다. 관찰기는 Museum과 같은 NodePort Service를 사용하고 특정한 정상 Pod를 고르지 않습니다. 관측한 실행에서는 보호된 요청이 올바르게 유지되었습니다. 유한한 표본은 모든 실제 네트워크, 앱, 클러스터 조건에서 실패가 없음을 보장할 수 없습니다.
전체 업데이트를 기다리고 최종 상태를 확인합니다.
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
이전 Terminating Pod가 모두 사라지면 현재 Pod가 정확히 두 개이고 재시작 없이 준비 완료여야 하며, 두 엔드포인트 주소가 ready=true여야 합니다. 가져오기 중 정상적인 이전 복제본은 유용하지만, 최종 업데이트는 실제 새 리비전으로 수렴해야 합니다.
방문자 서비스 전체 확인하기
Museum에서 MERIDIAN으로 홈에 돌아가 brass를 다시 검색합니다. 두 기구가 모두 보여야 하며 망원경을 열고 방문 링크를 따라갑니다. volcano를 검색하면 오류 대신 소장품이 없다고 표시되어야 합니다. Collection에서 황동이 아닌 소장품을 보고 Visit에서 목록을 다운로드합니다. 12개 소장품, 유지된 삽화와 탐색 기능을 확인합니다.
Workstation으로 전환합니다. curl은 URL을 요청하고, -sS는 진행 표시를 숨기면서 연결 오류를 보여 줍니다. 127.0.0.1은 이 학습 인스턴스이며 포트 30081은 실제 박물관 Service입니다. 따옴표는 검색 URL을 하나의 셸 인자로 유지합니다.
curl -sS 'http://127.0.0.1:30081/search?q=brass'
HTTP 성공 코드뿐 아니라 HTML에서 올바른 두 제목을 읽으세요. 이전 Pod 종료 중 검사가 실행됐다면 기다리고 다시 시도하며, 프로브를 제거하거나 가져오기 시간을 줄이지 마세요. 클러스터, 제공 이미지, Service, 원본 레코드 12개를 유지합니다. 정직한 업무 준비 상태 검사, 충분한 시작 시간, 박물관 경험을 유지하며 완료된 업데이트가 최종 결과입니다.
요약
준비 상태를 실제 소장품 색인과 연결하고, 너무 짧은 startup 프로브로 후보가 실패하고 재시작하는 것을 관찰한 뒤 적절한 시작 시간을 계산했습니다. 기존 준비 완료 복제본이 검색하는 동안 간격을 둔 가져오기 프로그램을 업데이트하고 현재 Pod, Service 엔드포인트, 전체 방문자 경로를 확인했습니다. 실행 중인 프로세스, 준비 완료 백엔드, 완료된 업데이트는 서로 다른 사실입니다. 단일 노드 실습은 운영 고가용성이나 실패가 없음을 입증하지 않습니다.