소개
지원 담당자는 각 티켓의 타임라인과 이벤트가 없는 티켓까지 포함한 요약이 필요합니다. 이 실습에서는 활동 행을 티켓과 연결하고, 재사용 가능한 SQL 보고서를 작성하며, 쿼리 계획으로 근거를 확인한 인덱스를 추가합니다. 데이터셋이 매우 작아서 응답이 빨라 보인다는 사실만으로는 효율적인 접근 경로의 충분한 증거가 되지 않습니다.
이 독립 실습에서는 이전 학습에서 사용한 기본 티켓 스키마를 제공합니다. 학습자는 일회용 D1 데이터베이스 하나를 사용해 관계, 보고서, 인덱스를 직접 만듭니다.
학습자 계정과 새 VM 을 사용합니다. 설정 과정에서 먼저 Node.js 22.22.0 을 준비한 다음, /home/labex/project/ticket-database에서 프로젝트 로컬 Wrangler 4.131.1 과 평가에 필요한 의존성을 설치하기 위해 npm install을 실행합니다. 직접 의존성 버전은 고정되어 있으며, 설치 과정에서 자체 lockfile 이 생성됩니다. 설정 과정에서는 클라우드 로그인이나 평가 대상 데이터베이스 작업을 수행하지 않습니다. 개인 컴퓨터에서는 프로젝트에서 npm install --save-dev wrangler@4.131.1을 실행해 동일한 Wrangler 버전을 설치합니다.
이 실습에서는 D1 Free allowances 범위 내의 작은 합성 레코드를 사용합니다. 기존 계정 사용량도 해당 허용량에 포함됩니다. 구매한 도메인은 필요하지 않습니다. 리소스 삭제와 로그아웃을 모두 확인할 때까지 이 VM 을 유지합니다.
이 VM 을 인증하고 계정 선택하기
이 단계에서는 새 터미널을 본인의 학습 계정에 연결합니다. Dashboard 에 로그인하는 것만으로는 VM 이 인증되지 않습니다. D1 권한이 있어야 데이터베이스를 생성하고, SQL 을 변경하고, 삭제할 수 있습니다. 인증하기 전에 Background Access 를 포함한 실제 동의 화면을 확인합니다.
준비된 프로젝트를 열고 고정된 CLI 버전을 확인합니다.
cd /home/labex/project/ticket-database
npx wrangler --version
4.131.1이 출력되어야 합니다. 디바이스 인증을 시작합니다. --device는 브라우저에 입력할 코드를 표시하고, --browser=false는 브라우저 선택을 직접 하도록 합니다.
npx wrangler login --device --browser=false --scopes account:read user:read d1:write
표시된 URL 을 브라우저에서 열고 현재 코드를 입력합니다. 학습자 계정과 권한을 확인한 후 인증을 승인합니다. 터미널에서 성공을 확인할 때까지 기다립니다. 비밀번호나 토큰을 프로젝트 파일에 붙여 넣지 마세요.
npx wrangler whoami --json
loggedIn: true인지 확인한 다음, 계정이 하나만 표시되더라도 계정의 name과 id를 읽습니다. 사용할 계정의 ID 를 아래 설정에 복사합니다. 다음 셸 변수는 6 개의 무작위 바이트 (16 진수 12 자) 를 사용해 다른 학습자의 실행과 이름이 충돌하지 않도록 합니다. here-document 는 JSON 줄 사이의 JSON 을 파일에 기록하며, $RUN은 그 안에서 확장됩니다.
$schema 앞의 백슬래시는 이 JSON 키를 그대로 유지하며, $RUN 은 이번 실행의 고유 이름으로 확장됩니다.
RUN=labex-c04-d04-$(openssl rand -hex 6)
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-15",
  "workers_dev": true,
  "preview_urls": false
}
JSON
블록을 실행하기 전에 YOUR_ACCOUNT_ID를 실제 계정 ID 로 바꿉니다. $RUN을 계속 사용할 수 있도록 이 터미널을 열어 둡니다. name은 이번 실행을 식별하고, account_id는 클라우드 작업에 사용할 계정을 선택합니다. 이 파일은 일반 JSON 이며 JSONC 로도 유효합니다. 이 파일을 작성한다고 해서 Worker 가 배포되지는 않습니다.
활동을 티켓과 연결하기
이 단계에서는 한 티켓에 여러 이벤트가 발생할 수 있도록 활동 테이블을 추가합니다. **외래 키 (foreign key)**는 활동의 ticket_id를 실제 티켓에 연결해, 존재하지 않는 상위 티켓을 가리키는 이벤트가 생기지 않도록 합니다. 설정 과정에서 익숙한 티켓 스키마를 제공하므로, 관계와 쿼리에 집중합니다.
일회용 클라우드 데이터베이스를 생성합니다. --binding DB는 애플리케이션 코드에서 사용할 짧은 이름을 지정하고, --update-config는 실제 이름과 UUID 를 wrangler.jsonc에 기록하며, --use-remote=false는 개발 환경에서 로컬 데이터베이스를 사용하도록 합니다.
npx wrangler d1 create "$RUN-db" --binding DB --update-config --use-remote=false
생성된 이름과 ID 를 읽은 다음, 저장된 바인딩을 확인합니다.
cat wrangler.jsonc
DB 항목에는 이번 실행에서 만든 데이터베이스의 이름이 있어야 합니다. 바인딩은 코드와 리소스를 연결하도록 설정된 연결 정보입니다. UUID 는 클라우드 데이터베이스를 식별하고, --local은 이 VM 의 별도 SQLite 데이터베이스를 사용합니다. SQL 명령에는 항상 --local 또는 --remote 중 하나를 포함합니다.
제공된 티켓 스키마를 읽고 로컬 데이터베이스에 적용합니다.
cat schema.sql
npx wrangler d1 execute DB --local --file schema.sql
활동 스키마와 고정된 데이터셋을 작성합니다. 여기의 정수 타임스탬프는 현재 시간이 아니라 합성된 순서 값입니다.
cat > activity.sql <<'SQL'
CREATE TABLE activity (
  id INTEGER PRIMARY KEY,
  ticket_id INTEGER NOT NULL REFERENCES tickets(id),
  action TEXT NOT NULL,
  created_at INTEGER NOT NULL
);
INSERT INTO activity (id, ticket_id, action, created_at) VALUES
  (1, 1, 'opened', 100),
  (2, 1, 'assigned', 200),
  (3, 2, 'opened', 110),
  (4, 2, 'closed', 300);
INSERT INTO tickets (id, subject, source) VALUES (3, 'No activity yet', 'seed');
SQL
로컬 데이터베이스에 적용합니다.
npx wrangler d1 execute DB --local --file activity.sql
티켓 1 과 2 에는 각각 이벤트가 두 개 있고, 티켓 3 에는 이벤트가 없습니다. 다음 단계에서는 이벤트가 0 개인 티켓도 요약에 포함하는 방법을 확인합니다.
티켓 활동 보고서 작성하기
이 단계에서는 두 테이블의 행을 결합합니다. **조인 (join)**은 관계를 사용해 행을 서로 일치시킵니다. t와 a는 각각 테이블 이름을 대신하는 짧은 별칭입니다. LEFT JOIN은 활동이 없는 경우에도 모든 티켓을 유지하고, COUNT(a.id)는 일치하는 활동 ID 만 셉니다. GROUP BY는 티켓별로 이벤트를 모으며, AS event_count는 계산된 열의 이름을 지정합니다.
재사용할 수 있는 읽기 전용 보고서 쿼리를 작성합니다. 쿼리를 SQL 파일에 저장하면 로컬 환경과 원격 환경에서 같은 보고서를 실행할 수 있습니다.
cat > report.sql <<'SQL'
SELECT t.id, t.subject, COUNT(a.id) AS event_count
FROM tickets AS t
LEFT JOIN activity AS a ON a.ticket_id = t.id
GROUP BY t.id, t.subject
ORDER BY t.id;
SQL
보고서를 실행합니다.
npx wrangler d1 execute DB --local --file report.sql
티켓 1, 2, 3 의 개수가 각각 2, 2, 0으로 출력되어야 합니다. 내부 조인 (inner join) 을 사용하면 티켓 3 이 결과에서 제외됩니다. *를 세면 일치하지 않는 티켓에도 조인으로 생성된 자리표시자 행이 있어 그 행까지 계산됩니다. 한 티켓의 이벤트를 시간순으로 읽습니다.
npx wrangler d1 execute DB --local --command "SELECT action, created_at FROM activity WHERE ticket_id = 1 ORDER BY created_at;"
100 에서 opened가 먼저 나오고, 200 에서 assigned가 나와야 합니다. 보고서는 각 티켓에 이벤트가 몇 개인지 알려 주고, 필터링한 쿼리는 특정 티켓에 어떤 이벤트가 속하는지 알려 줍니다.
쿼리 계획으로 인덱스 근거 확인하기
이 단계에서는 활동 타임라인을 조회하기 위한 조회 구조를 추가합니다. **인덱스 (index)**는 검색 가능한 값을 정렬된 형태로 저장해 관련 없는 행을 모두 스캔하지 않아도 되도록 합니다. 인덱스는 저장 공간을 사용하고, 인덱싱된 값이 변경될 때 추가 작업을 발생시키므로 구체적인 쿼리에 근거해 추가해야 합니다.
인덱스를 추가하기 전에 쿼리 계획을 확인합니다. EXPLAIN QUERY PLAN은 SQLite 의 접근 전략을 설명하며, 경과 시간을 벤치마크하지는 않습니다.
npx wrangler d1 execute DB --local --command "EXPLAIN QUERY PLAN SELECT action, created_at FROM activity WHERE ticket_id = 1 ORDER BY created_at;"
activity를 스캔한다는 내용과, 정렬을 위해 임시 구조를 사용할 수 있다는 내용을 확인합니다. ticket_id를 첫 번째 열로, created_at을 두 번째 열로 사용하는 결합 인덱스를 생성합니다.
cat > index.sql <<'SQL'
CREATE INDEX idx_activity_ticket_created ON activity(ticket_id, created_at);
SQL
npx wrangler d1 execute DB --local --file index.sql
npx wrangler d1 execute DB --local --command "EXPLAIN QUERY PLAN SELECT action, created_at FROM activity WHERE ticket_id = 1 ORDER BY created_at;"
이제 계획에 검색에 사용되는 idx_activity_ticket_created가 표시되어야 합니다. 정확한 출력 형식은 다를 수 있습니다. 고정된 데이터셋이 너무 작아 유용한 시간 비교를 할 수 없으므로, 여기서는 선택된 접근 경로가 근거입니다.
인덱스를 만든 후 새 이벤트를 추가하고 보고서를 다시 실행합니다.
npx wrangler d1 execute DB --local --command "INSERT INTO activity (id, ticket_id, action, created_at) VALUES (5, 1, 'replied', 400);"
npx wrangler d1 execute DB --local --file report.sql
이제 티켓 1 에는 이벤트가 세 개 있습니다. 인덱스는 읽기를 지원하는 것뿐 아니라 올바른 쓰기도 유지해야 합니다.
D1 에서 보고서와 인덱스 쿼리 실행하기
이 단계에서는 검토한 스키마와 인덱스를 원격 실습 데이터베이스에 설치합니다. 로컬 파일만으로는 원격 스키마가 생성되지 않습니다.
npx wrangler d1 execute DB --remote --file schema.sql
npx wrangler d1 execute DB --remote --file activity.sql
npx wrangler d1 execute DB --remote --file index.sql
확인 메시지가 표시되면 이번 실습의 데이터베이스만 선택되어 있는지 확인합니다. 동일한 최종 활동을 추가한 뒤 보고서와 원격 쿼리 계획을 확인합니다.
npx wrangler d1 execute DB --remote --command "INSERT INTO activity (id, ticket_id, action, created_at) VALUES (5, 1, 'replied', 400);"
npx wrangler d1 execute DB --remote --command "$(cat report.sql)"
npx wrangler d1 execute DB --remote --command "EXPLAIN QUERY PLAN SELECT action, created_at FROM activity WHERE ticket_id = 1 ORDER BY created_at;"
$(cat report.sql)은 보고서 내용을 쿼리로 전달합니다. 원격 환경에서 --file을 사용하면 가져오기 작업이 수행되므로 SELECT 결과 테이블이 아니라 가져오기 메타데이터가 출력됩니다. 원격 결과의 개수는 3, 2, 0 이어야 하며, 쿼리 계획에는 생성한 인덱스 이름이 표시되어야 합니다. 이를 통해 특정 시간 향상을 가정하지 않고도 D1 에서 결과와 접근 경로를 확인할 수 있습니다. 필요하면 이 실행의 D1 데이터베이스를 Dashboard 에서 열어 읽기 전용 테이블/스키마 확인을 수행할 수 있습니다. 단, 인덱스의 근거로는 CLI 쿼리 계획을 유지합니다.
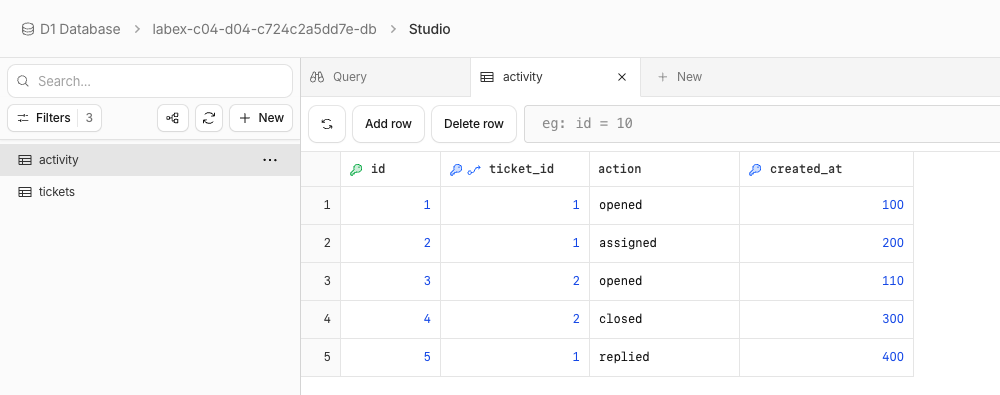
이 예시는 원격 활동 행 다섯 개와 ticket_id를 통한 연결을 보여 줍니다. 생성된 데이터베이스 이름은 이 예시 실행을 식별하므로 실제 이름은 다릅니다. created_at 숫자는 정렬을 위한 가상 값이며 현재 타임스탬프가 아닙니다. 이 표는 행을 확인하는 시각적 참고 자료입니다. 위의 CLI EXPLAIN QUERY PLAN 출력은 인덱스 사용을 확인하며 실행 시간 개선을 증명하지는 않습니다.
일회용 리소스 삭제하기
이 단계에서는 VM 이 아직 인증된 상태에서 이번 실습의 리소스만 삭제합니다. 모든 기능 확인을 먼저 끝내세요. 삭제 검증이 완료될 때까지 설정 파일을 유지합니다.
npx wrangler d1 delete DB
확인 메시지를 읽고 이번 실행에서 만든 데이터베이스만 선택되어 있는지 확인합니다. 그런 다음 데이터베이스 목록을 조회합니다.
npx wrangler d1 list --json
성공적인 응답에 기록해 둔 데이터베이스 이름과 UUID 가 없어야 합니다. 다른 리소스는 남아 있을 수 있습니다. 인증 또는 네트워크 오류가 발생하면 삭제 여부를 판단할 수 없습니다. 접근 문제를 해결한 후 계속 진행하기 전에 조회 명령을 다시 실행합니다. 아직 로그인된 상태에서 이 단계의 검증을 수행합니다.
이 VM 의 인증 종료하기
이 단계에서는 독립적인 삭제 확인이 통과한 후에만 인증을 종료합니다. 로그아웃하면 이 VM 에 저장된 Wrangler 인증 정보가 제거됩니다. VM 을 닫는 것만으로는 클라우드 리소스가 정리되지 않습니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn: false가 출력되어야 합니다. 인증되지 않은 이 조회 명령은 0 이 아닌 종료 상태를 반환할 수 있습니다. 구조화된 응답에 로그아웃 상태가 명시되어 있을 때만 이를 정상적인 결과로 봅니다. 검증을 완료한 다음 실습 환경을 종료합니다.
요약
티켓 활동을 조회하고 인덱스를 생성하는 방법을 실습했습니다. 데이터베이스에서 확인할 수 있는 결과를 점검하고, 선택한 계정과 로컬 상태를 명시적으로 관리했으며, 로그아웃하기 전에 일회용 리소스를 삭제했습니다.