소개
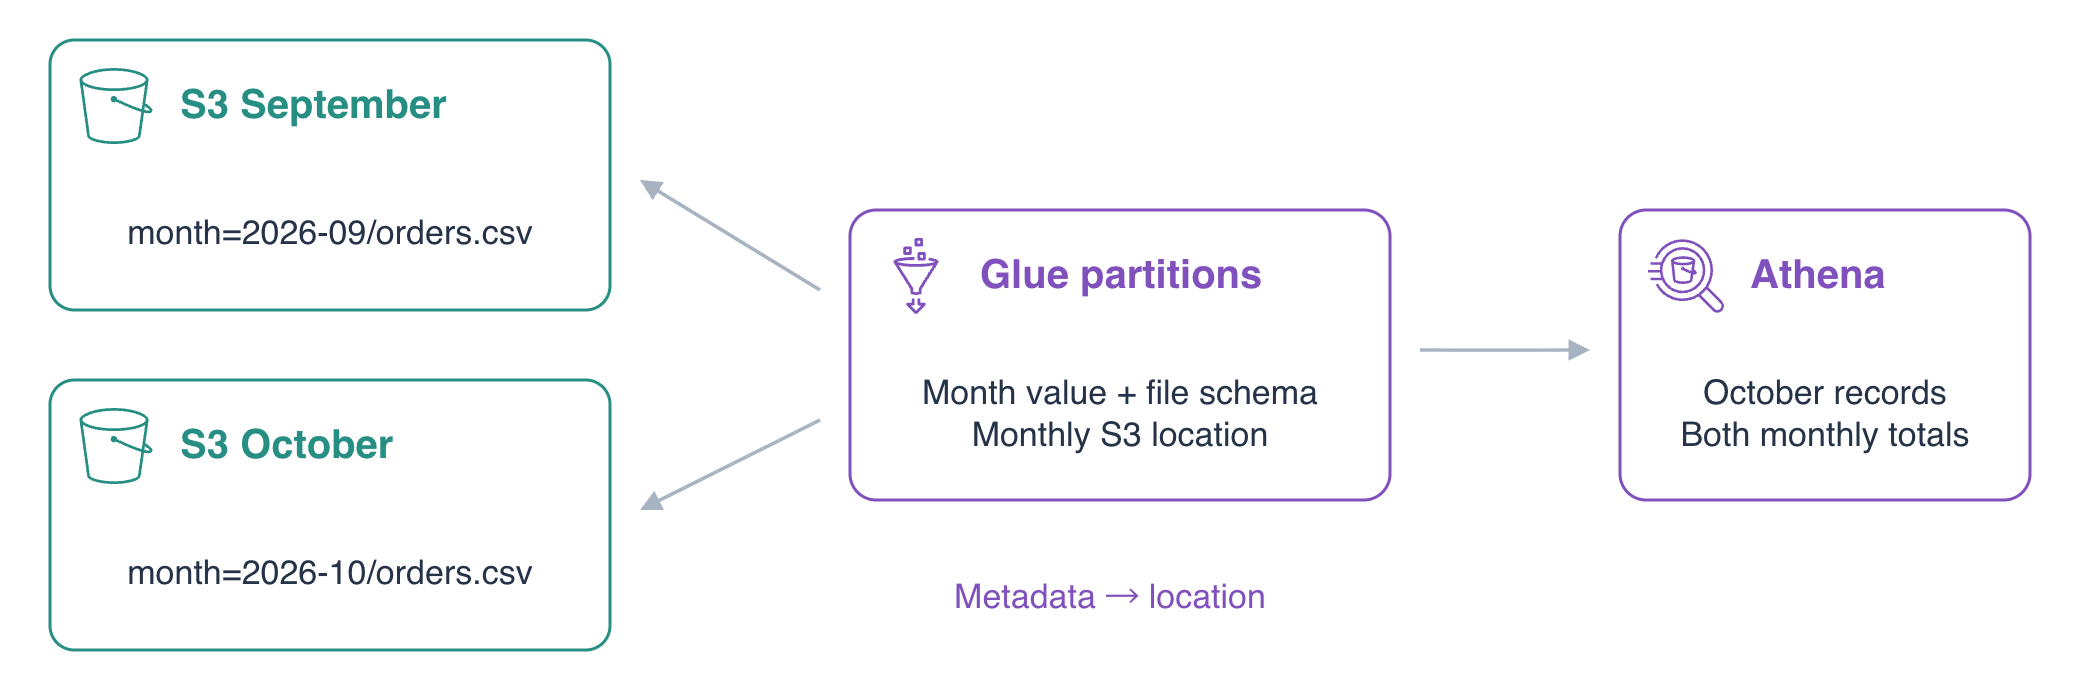
매장은 월별로 판매를 저장합니다. September는 등록되었고 October 새 파일은 로컬에 있습니다. 월별 S3 접두사에 업로드하고 Glue 파티션을 등록하여 Athena로 새 달과 두 달을 조회합니다.
먼저 Query S3 Data with Athena를 완료하세요. 독립 환경에 파티션 테이블 sales, September 데이터와 등록, 새 로컬 CSV, 설정된 AWS 자격이 준비됩니다. 개인 계정이나 이전 VM 리소스는 필요 없습니다. Terminal에서 일반 S3/Glue/Athena 명령을 사용하고 AWS View에서 파일, 파티션 위치, 실제 결과를 비교합니다.
자격증 관련 내용
| 자격증 | 시험 과제 | 실습 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Glue 메타데이터가 파티션 S3 데이터를 Athena 분석에 제공하는 방법을 설명합니다. |
새 월별 파일 추가
이 단계에서는 September를 유지하고 October를 업로드합니다. 파티션은 월 같은 키로 데이터를 나눕니다. sales/month=2026-09/는 September, sales/month=2026-10/는 October 위치입니다. key=value 이름은 그룹을 보여 주지만 업로드가 자동으로 카탈로그를 등록하지는 않습니다.
프로젝트에서 자격을 확인합니다:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN은 labex-an03-operator로 끝납니다. jq -r는 JSON 텍스트를 추출하고 $(...)는 출력을 변수에 저장합니다:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive는 하위 접두사도 포함합니다:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
sales/month=2026-09/orders.csv가 보입니다. September는 1000, 2000, 500센트로 총 3500입니다. 이 파일과 reference/notes.txt를 유지합니다. 새 CSV를 확인합니다:
cat october.csv
O01/east/700, O02/west/900, O03/east/400은 같은 세 열의 새 주문 세 건이며 합계 2000센트입니다. 별도 접두사에 업로드합니다:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
실제 객체를 다시 읽습니다:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
마지막 -는 내용을 출력합니다. AWS View의 S3에는 두 파일, Glue에는 September만 보입니다. 파일 도착과 등록은 별개입니다.
카탈로그에 October 등록
이 단계에서는 업로드만으로 부족함을 확인하고 메타데이터를 추가합니다. 파티션 정의는 키 값, S3 위치, 스키마를 연결합니다. 문자열 month가 파티션 키입니다. CSV에는 order_id, region, total_cents만 있으며 쿼리의 month는 정의에서 옵니다.
키를 확인합니다:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
month, 유형 string입니다. 등록 전에 조회합니다. COUNT(*)는 일치 레코드를 세며 따옴표 heredoc 구분자는 SQL을 그대로 보존합니다:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
준비된 데이터베이스와 결과 접두사로 제출하고 ID를 표시합니다:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
QUEUED, RUNNING이면 반복하고 SUCCEEDED일 때 계속하며 실패하면 Reason을 읽습니다:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
결과를 읽습니다:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
파일이 있어도 수는 0입니다. 이 테이블은 등록된 위치를 읽습니다. 디렉터리 이름만으로 메타데이터가 생성되지 않습니다.
같은 열과 CSV 형식을 위해 저장 설명자를 재사용합니다. >는 JSON을 파일에 씁니다:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg는 실제 위치를 문자열로 전달합니다. .Location = $location는 October 위치로 바꾸며 Values는 단일 키 값을 제공합니다:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
일반 JSON을 확인합니다:
cat october-partition.json
Values의 2026-10, CSV와 같은 열, 위치 끝 /sales/month=2026-10/를 확인합니다. ${SALES_LOCATION} 중괄호는 변수명과 추가 접두사를 분리합니다. file://로 로컬 JSON을 읽어 등록합니다:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
두 파티션을 조회합니다:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
각 월이 자기 S3 위치를 가리키며 AWS View에 두 매핑이 보입니다. 등록은 메타데이터만 변경하며 CSV를 복사하거나 다시 쓰지 않습니다.
새 달 및 두 달 합계 조회
이 단계에서는 October 조회와 September 보존을 증명합니다. 키에 대한 WHERE가 월을 선택합니다. 레코드를 검증하며 스캔 비용이나 운영 환경 속도를 측정하지 않습니다.
October 쿼리를 작성합니다:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
새 실행으로 제출합니다. 파티션 등록은 이전의 0건 결과를 다시 쓰지 않습니다:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
상태를 확인하고 대기 시 반복하며 성공 후 계속하고 오류 이유를 확인합니다:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
행을 읽습니다:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
헤더 다음은 O01/700, O02/900, O03/400입니다. 이전에 보이지 않던 같은 파일이 세 레코드를 제공합니다.
SUM은 금액을 더하고 COUNT(*)는 각 GROUP BY month 그룹의 주문을 셉니다:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
제출하고 별도 ID를 표시합니다:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
성공을 확인하고 필요하면 상태를 반복 확인하며 실패 이유를 읽습니다:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
그룹 결과를 가져옵니다:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September는 3500센트/3건, October는 2000/3건입니다. 첫 달은 바뀌지 않았습니다. AWS View에서 Glue 위치, SQL, 행을 비교합니다.
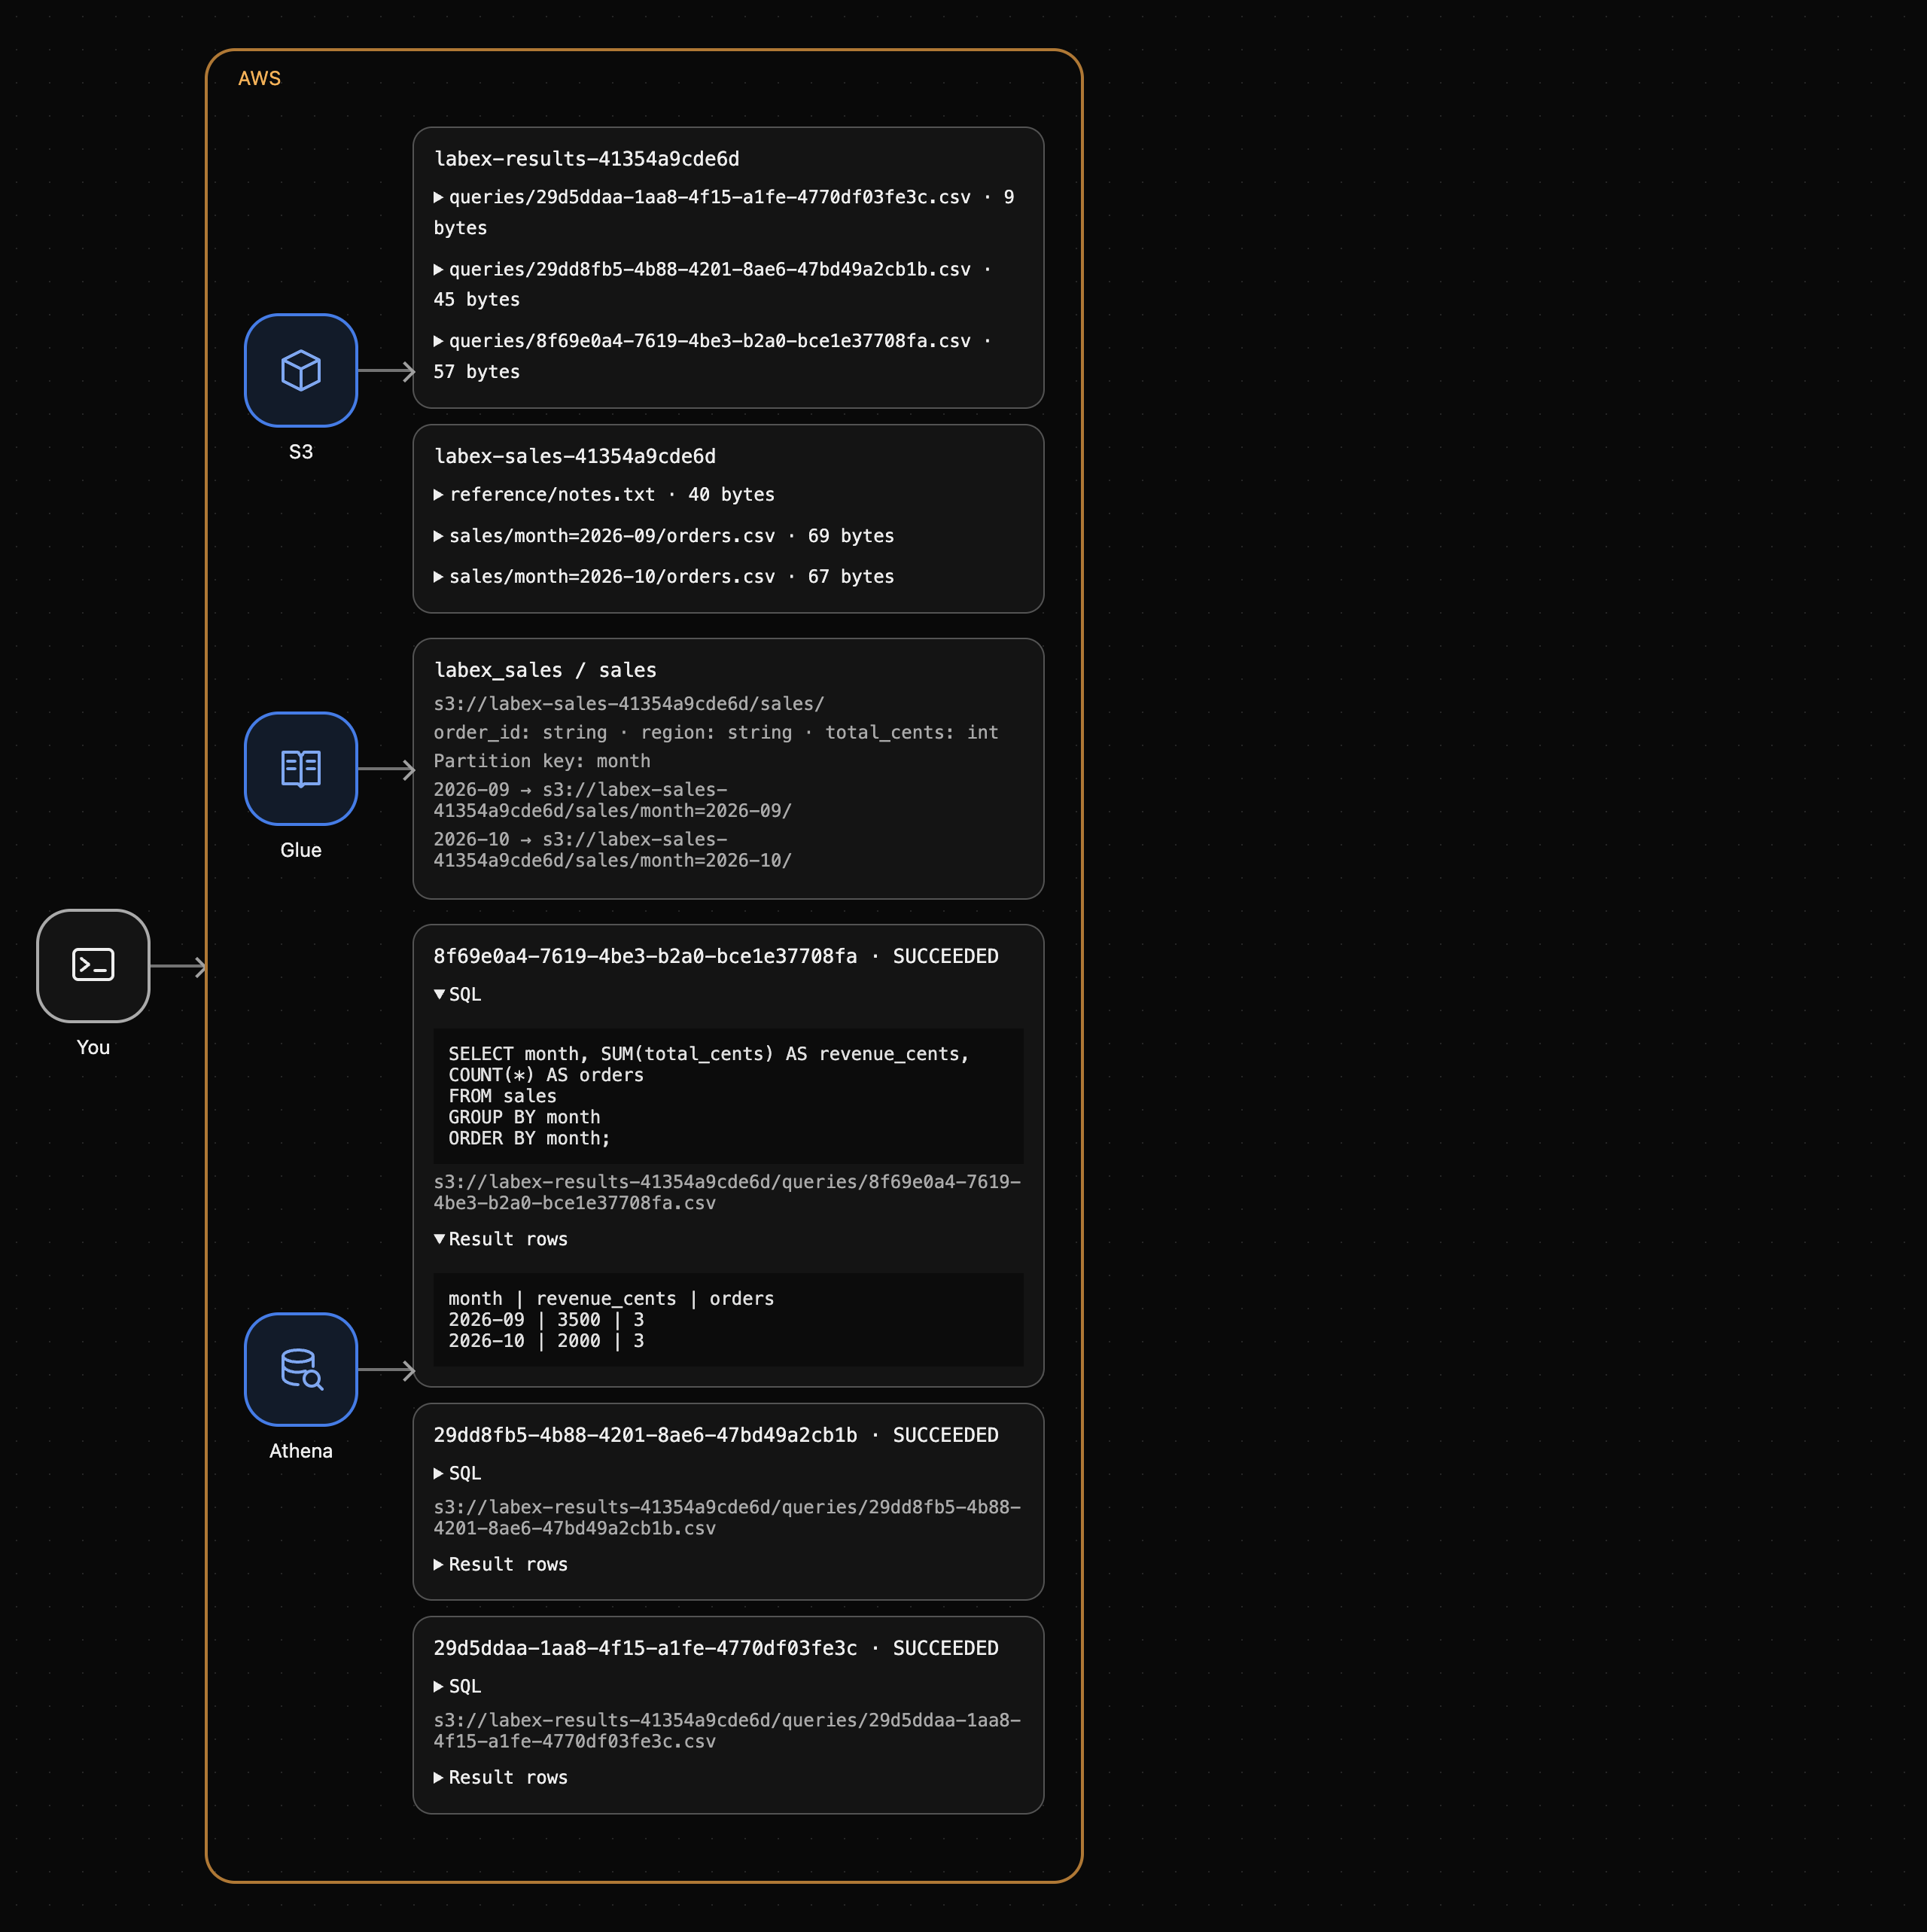
이전 0건 출력은 이전 카탈로그 상태의 별도 결과로 남습니다.
요약
월별 CSV를 업로드하고 미등록 상태에서 행이 없음을 확인한 다음 Glue 위치와 스키마를 등록하여 October와 두 달 합계를 검증했습니다. 파일과 메타데이터는 별개입니다. 이 테이블은 새 접두사의 올바른 등록이 필요합니다. 다음 실습에서는 실제 결과로 재사용 가능한 요약 파일을 만듭니다.
자세한 내용은 AWS 공식 문서를 참고하세요: 파티션 키, 위치 및 등록.