소개
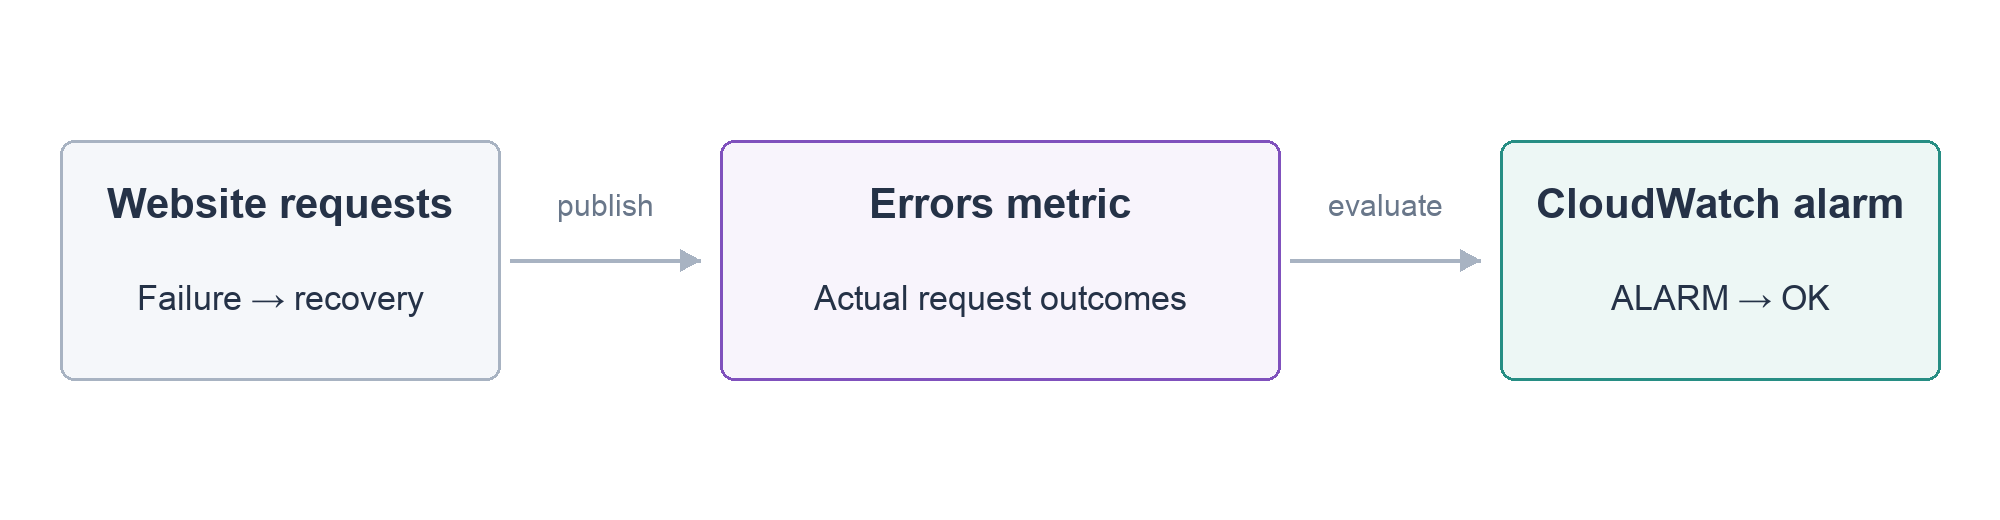
CloudWatch 경보를 구성하고 실패한 게시를 관찰한 뒤 정상 요청을 복구하여 OK로 돌아옵니다.
로그 실습을 먼저 완료하세요. 새 환경은 사이트, 세 비공개 S3 표지, 목록, 역할, 로그와 지표를 제공합니다. 이전 리소스나 자격 증명 없이 경보 생성, 장애와 복구를 직접 수행합니다.
자격 시험과 연결
| 자격 | 시험 과제 | 실습 내용 |
|---|---|---|
| AWS Certified Cloud Practitioner (CLF-C02) | Task 3.8 | 메트릭과 경보로 오류와 복구를 관찰합니다. |
실습 개요
오류 경보 만들기
이 단계에서는 작품 페이지의 실제 오류에 경보를 생성합니다.
AWS View에서 사이트를 확인합니다. 각 /website 요청은 Errors 값을 제공하며 실패는 1, 성공은 0입니다. 이미지와 다른 요청도 로그는 있지만 이 페이지 지표에는 포함되지 않습니다.
지표는 시간에 따른 수치입니다. namespace는 지표를 묶고 dimension은 앱을 구분합니다. 여기서는 LabEx/Portfolio의 Errors, Application=portfolio입니다. 경보는 평가 데이터를 임계값과 비교하며 사이트를 자동으로 고치지는 않습니다.
식별자를 불러오고 표시합니다. 순서대로 인스턴스 ID, SCP 주소, 로그 그룹입니다:
cd /home/labex/project
source website.env
echo "$INSTANCE_ID"
echo "$PUBLIC_IP"
echo "$LOG_GROUP"
준비된 파일을 읽습니다. 표는 평가할 설정을 설명합니다:
cat website-alarm.json
| 설정 | 의미 |
|---|---|
MetricName: Errors |
페이지 요청 오류 |
Statistic: Sum |
주기 내 오류 합계 |
Period: 10 |
10초 주기 평가 |
EvaluationPeriods: 1 |
한 주기로 판단 |
Threshold: 0 / GreaterThanThreshold |
오류가 있으면 합계가 0 초과 |
TreatMissingData: missing |
요청 없음은 정상으로 간주하지 않음 |
Unit: Count |
실패 요청 횟수 |
10초 경보에는 고해상도 사용자 지표가 필요하며 연동은 1초 해상도로 게시합니다. 알림 대상은 구성하지 않습니다. launch.json처럼 --cli-input-json이 file://로 로컬 파일을 읽습니다:
aws cloudwatch put-metric-alarm \
  --cli-input-json file://website-alarm.json
성공 시 출력은 없습니다. --query로 이름, 상태와 이유만 읽습니다:
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
평가 데이터가 없으면 StateValue가 INSUFFICIENT_DATA일 수 있습니다. AWS View도 같은 경보를 표시합니다. 다음 단계에서는 실제 요청으로 상태를 만들고 수동 설정은 하지 않습니다.
실제 오류 감지하기
이 단계에서는 잘못된 소개를 게시하고 실제 오류를 경보와 연결합니다.
profile-broken.json을 확인합니다. {invalid-json은 준비된 장애이며 앱이 JSON으로 파싱할 수 없습니다. 앞서 배운 SCP 연결과 경로로 게시합니다:
cat profile-broken.json
scp -F ssh_config profile-broken.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
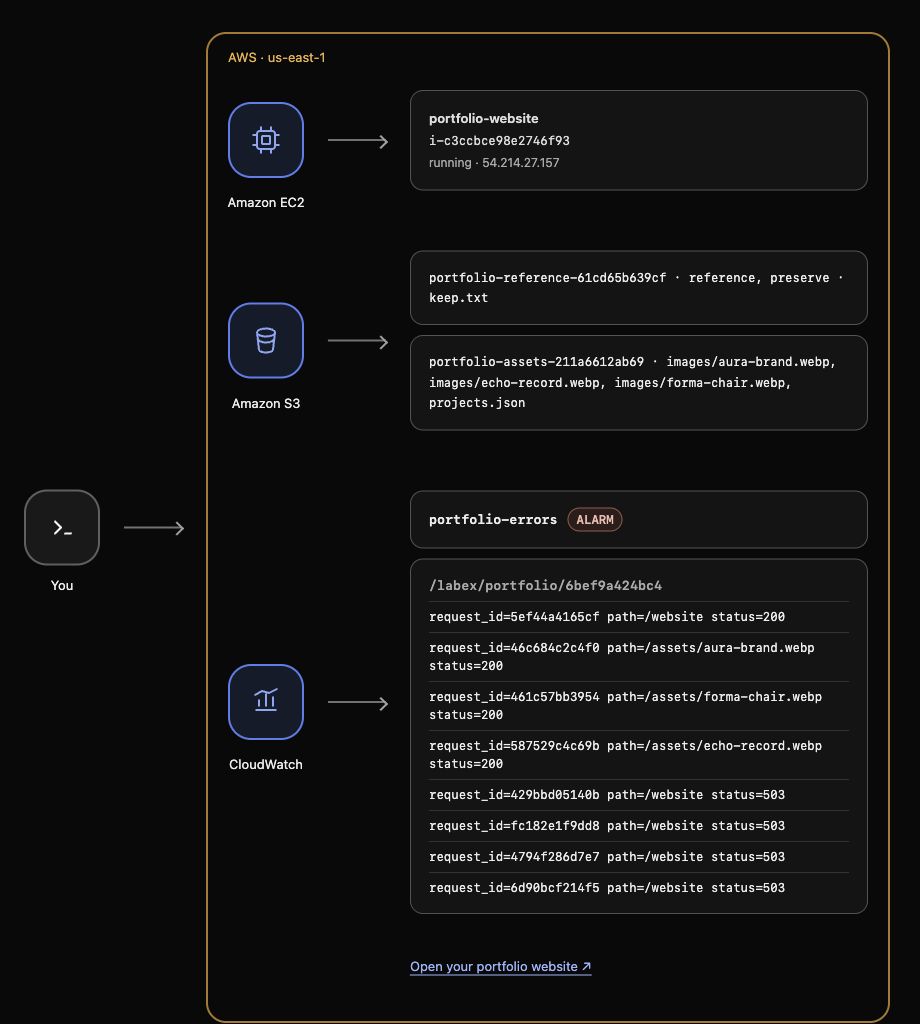
새로고침하면 Website unavailable이 나타나지만 AWS View의 EC2는 running입니다. 서버는 실행되어도 페이지 요청을 처리할 수 없습니다. 로그에서 실패를 찾습니다:
aws logs filter-log-events \
  --log-group-name "$LOG_GROUP" \
  --filter-pattern '"status=503"' \
  --query 'events[].message'
path=/website status=503을 확인합니다. HTTP 503은 실패 응답입니다. 최근 게시가 구체적 원인 후보이며 상태 코드만으로 모든 원인을 알 수는 없습니다.
평가를 위해 약 10초 기다린 뒤 경보를 읽습니다. 아직 ALARM이 아니면 오류 페이지를 새로고침하고 한 주기를 더 기다려 같은 조회를 반복합니다:
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
응답과 AWS View에서 StateValue: ALARM을 확인합니다. 오래된 503 로그는 새 측정값이 아니므로 실패 요청을 최신으로 유지하세요. 게시와 측정된 오류가 연결되었습니다.
10초 평가를 기다리며 약 5초마다 새로고침하여 인접 주기에 샘플을 유지하세요. 예상 상태가 나오면 요청이 최신인 동안 Check를 누릅니다.
사이트 복구하고 회복 확인하기
이 단계에서는 정상 소개를 복구하고 성공 요청과 경보를 확인합니다.
profile-working.json에는 올바른 세 필드가 있습니다. 같은 경로에 게시합니다:
cat profile-working.json
scp -F ssh_config profile-working.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
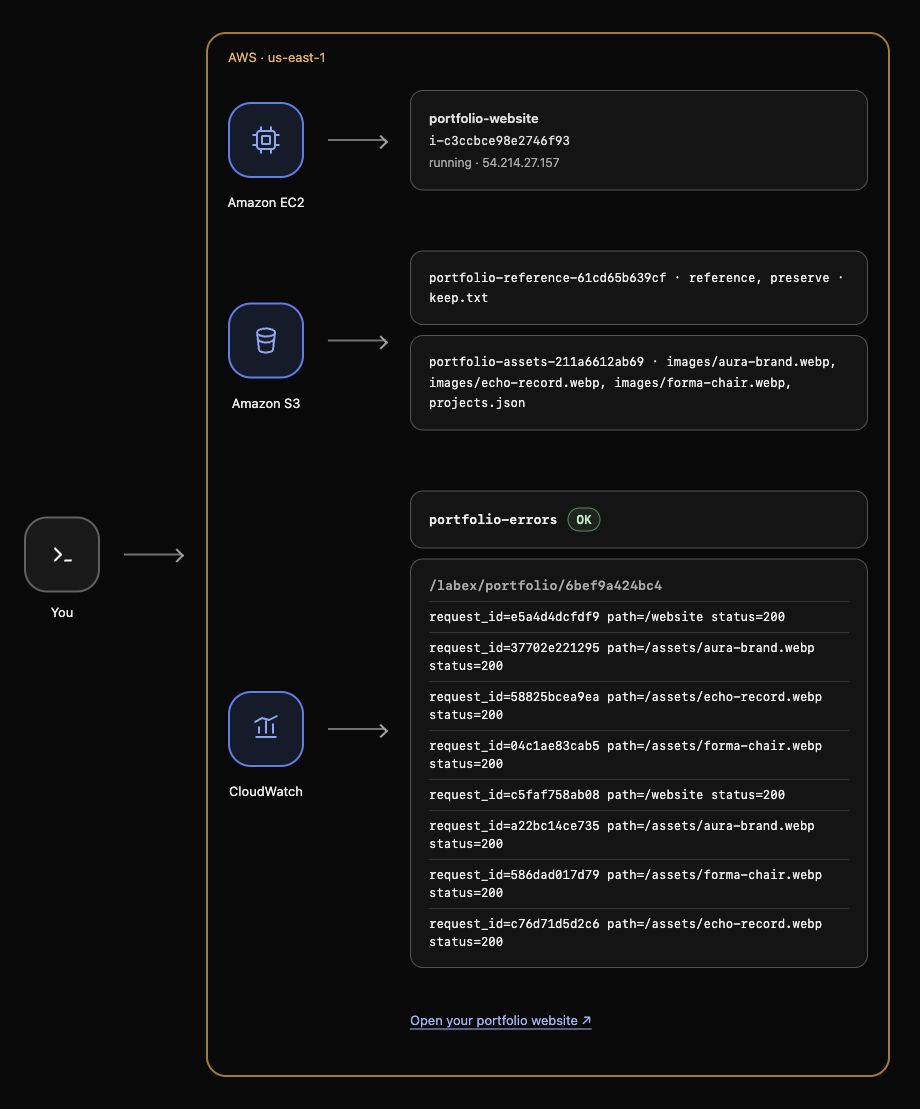
새로고침하면 Alex Morgan, Make it memorable.과 세 표지가 돌아와 앱 복구를 확인합니다. 성공 메시지를 읽습니다:
aws logs filter-log-events \
  --log-group-name "$LOG_GROUP" \
  --filter-pattern '"status=200"' \
  --query 'events[].message'
오류 이후의 새 path=/website status=200을 찾습니다. 이전 503은 이력에 남습니다. 이후 성공이 이전 주기의 오류를 지우지 않으므로 페이지가 먼저 복구될 수 있습니다.
성공 요청을 새 평가 주기로 보냅니다. 약 5초마다 정상 페이지를 새로고침하고 필요하면 StateValue: OK까지 조회합니다. 평가 데이터가 오류 임계값을 넘지 않는 뜻입니다. 요청을 멈추면 INSUFFICIENT_DATA로 돌아갈 수 있으며 정상 트래픽의 증거는 아닙니다.
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
10초 평가를 기다리며 약 5초마다 새로고침하여 인접 주기에 샘플을 유지하세요. 예상 상태가 나오면 요청이 최신인 동안 Check를 누릅니다.
요약
게시 실패, 응답 로그, 측정 오류와 복구로 사이트와 OK가 돌아오는 실제 운영을 완료했습니다. 데이터 부재와 성공 요청도 구분하고 사이트는 계속 확인할 수 있습니다.