소개
매장은 공유할 월별 판매 CSV가 필요합니다. Athena로 계산하고 실제 S3 출력을 받은 뒤 판매액을 수정해 새 요약을 만듭니다. 두 출력을 비교하여 실행 시점의 입력과 결과 관계를 확인합니다.
Query Partitioned Sales Data를 완료하세요. 독립 환경에 두 월별 S3 파일, 등록된 Glue 파티션, AWS 자격, 로컬 September 수정 파일이 제공됩니다. 개인 계정이나 이전 VM 리소스는 필요 없습니다. Terminal에서 공식 CLI, AWS View에서 실제 파일과 카탈로그 및 결과를 확인합니다.
자격증 관련 내용
| 자격증 | 시험 과제 | 실습 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Athena와 Glue로 S3를 분석하고 계산 결과를 가져옵니다. |
월별 요약 계산
이 단계에서는 현재 파일에서 요약을 계산합니다. Glue는 스키마와 위치, Athena는 읽기와 월별 그룹화를 담당합니다. 실행마다 별도 ID와 결과 파일이 있습니다.
프로젝트에서 자격을 확인합니다:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN은 labex-an04-operator로 끝납니다. jq -r는 JSON 문자열을 추출하고 $(...)는 출력을 변수에 저장합니다:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
등록된 위치를 확인합니다:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
두 달 모두 등록되어 있습니다. 정수 센트 total_cents 합산은 통화 반올림을 피합니다. COUNT(*)는 주문 수, GROUP BY month는 월별 그룹, ORDER BY month는 비교 순서입니다. 따옴표 heredoc은 SQL을 그대로 씁니다:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
데이터베이스와 S3 접두사로 제출합니다. file://는 SQL 파일, CLI --query와 --output text는 ID를 읽습니다:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
QUEUED/RUNNING이면 반복하고 SUCCEEDED일 때 계속하며 FAILED이면 Reason을 확인합니다:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
중첩 [*] 투영은 행별 열 구조를 유지합니다:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
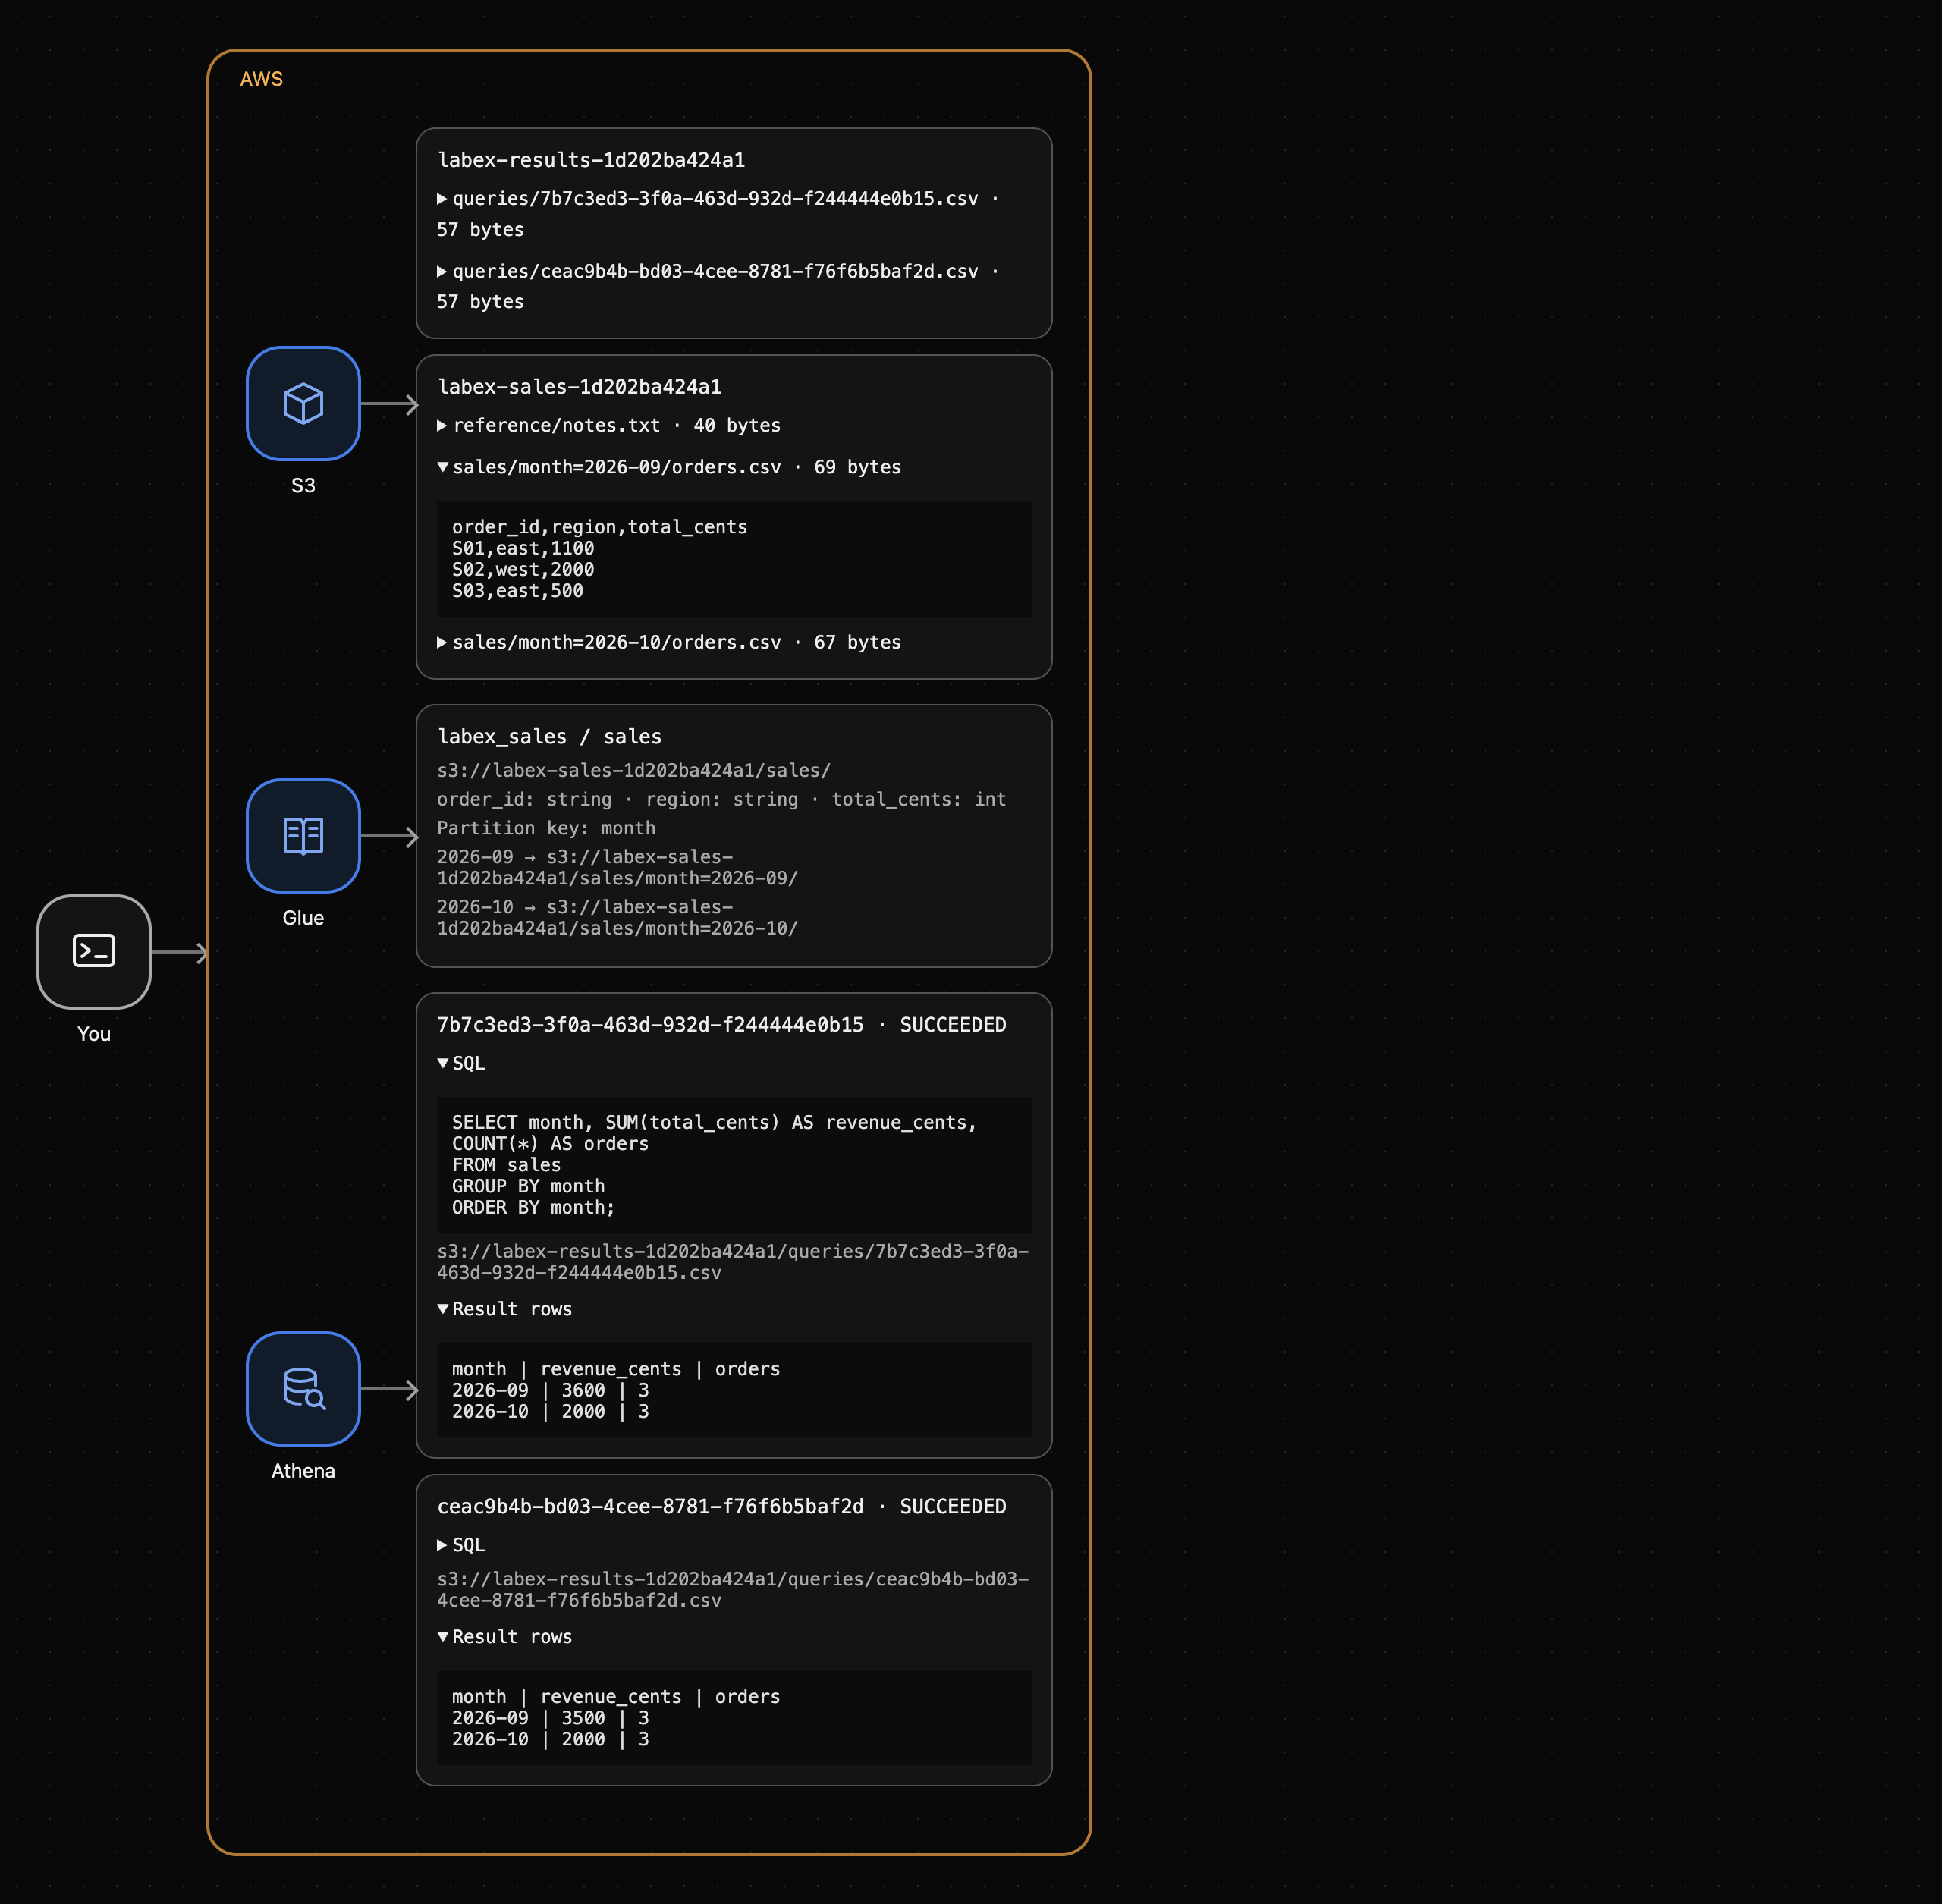
September는 3500센트/3건, October는 2000/3건입니다. AWS View에서 SQL과 행을 월별 위치와 비교합니다.
실제 S3 결과 파일 다운로드
이 단계에서는 해당 실행의 CSV를 가져옵니다. 결과 API는 행을 보여 주고 실행 메타데이터는 정확한 S3 위치를 제공합니다. 버킷이나 ID를 추측하지 마세요.
URI를 추출하고 표시합니다:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
끝은 /queries/<your-execution-id>.csv이며 ID가 파일과 쿼리를 연결합니다. summary.csv로 다운로드합니다:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
내용을 확인합니다:
cat summary.csv
헤더와 두 레코드입니다:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
API와 값이 같습니다. 직접 쓴 보고서가 아니라 실제 다운로드한 S3 파일입니다. summary.csv와 원본 S3 출력을 비교용으로 유지합니다.
입력 수정 후 다시 계산
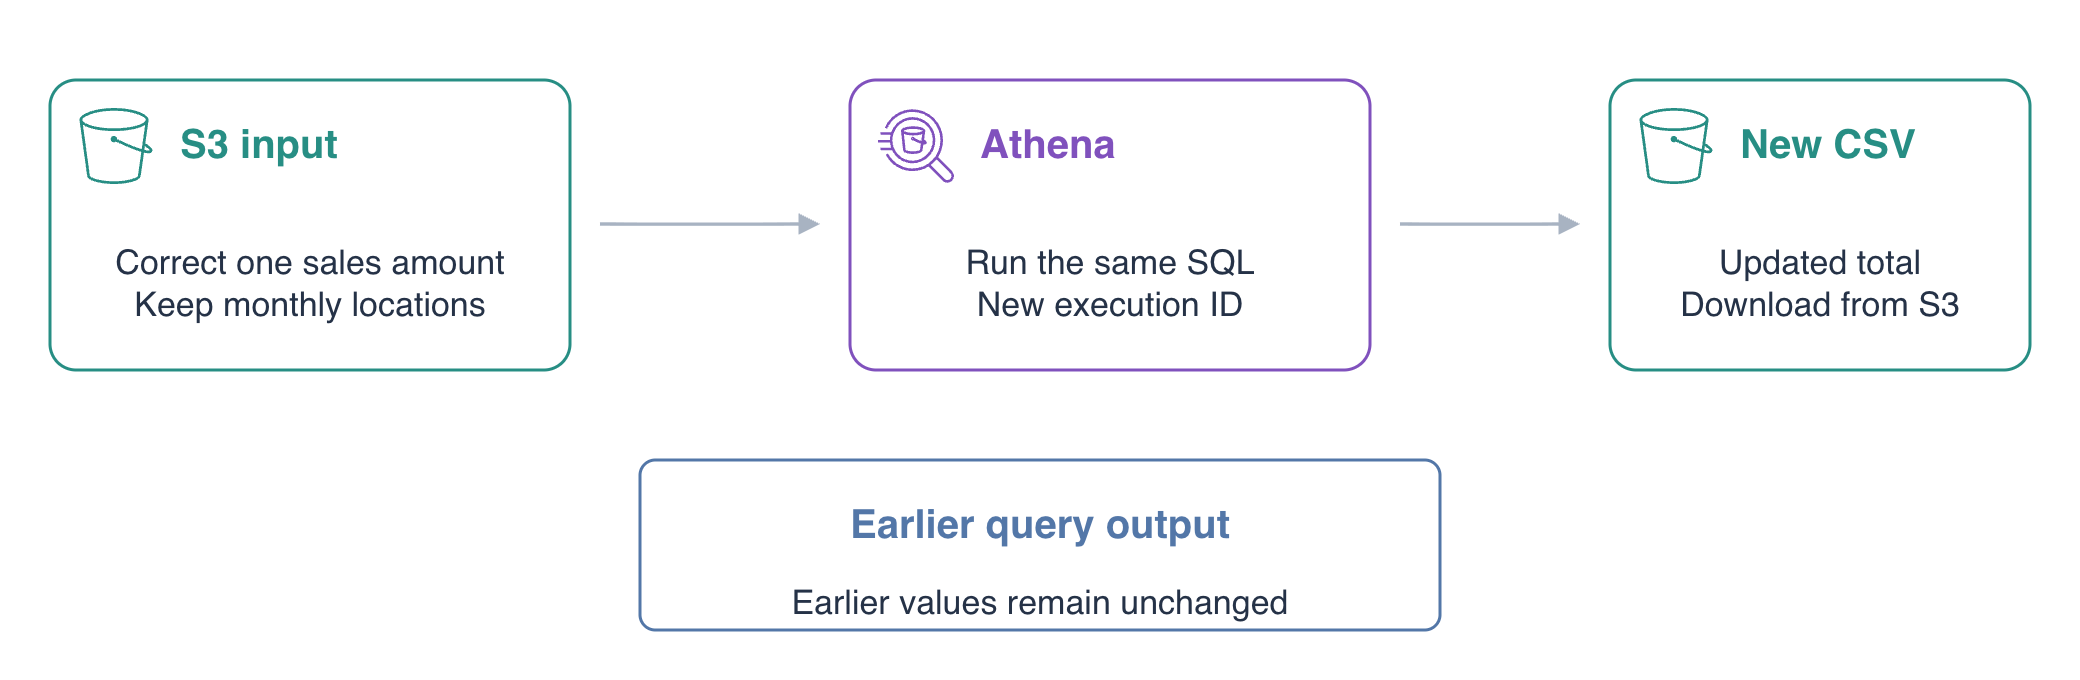
이 단계에서는 September 금액 하나를 수정하고 같은 SQL을 실행합니다. 기존 결과는 자동 갱신되지 않으므로 새 실행이 현재 입력을 읽어야 합니다.
수정 파일을 확인합니다:
cat september-revised.csv
S01은 1000에서 1100센트로 바뀌고 나머지는 같아 합계가 3600입니다. 기존 객체를 갱신하고 October와 reference/notes.txt를 유지합니다:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
다시 읽어 확인합니다:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
마지막 -는 내용을 출력합니다. 위치와 스키마가 같아 Glue 파티션은 유효합니다. 같은 SQL을 새로 실행합니다:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
성공을 확인하고 대기 상태는 반복하며 오류 이유를 확인합니다:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
행을 가져옵니다:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September는 3600/3, October는 2000/3입니다. 입력 변경이 계산에 반영되었습니다.
새 실행의 출력 위치를 가져옵니다:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
이전 로컬 요약을 덮어쓰지 않고 다운로드합니다:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
새 CSV를 확인합니다:
cat summary-revised.csv
기존 S3 출력을 비교합니다:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
기존 September는 여전히 3500입니다. 서로 다른 ID와 파일이 이전 및 수정 입력을 설명합니다. AWS View에서 현재 원본과 실제 결과 둘을 봅니다. 정확성 실험이며 운영 비용이나 성능 측정은 아닙니다.
요약
월별 합계를 계산하고 정확한 CSV를 다운로드한 뒤 원본을 수정하여 다시 계산했습니다. September는 3500에서 3600센트, October는 2000입니다. 이전 파일은 값을 유지하므로 입력이 바뀌면 다시 실행해야 합니다.
자세한 내용은 AWS 공식 문서를 참고하세요: 쿼리 실행별 출력 파일 찾기; SELECT 필터, 그룹화 및 정렬.