소개
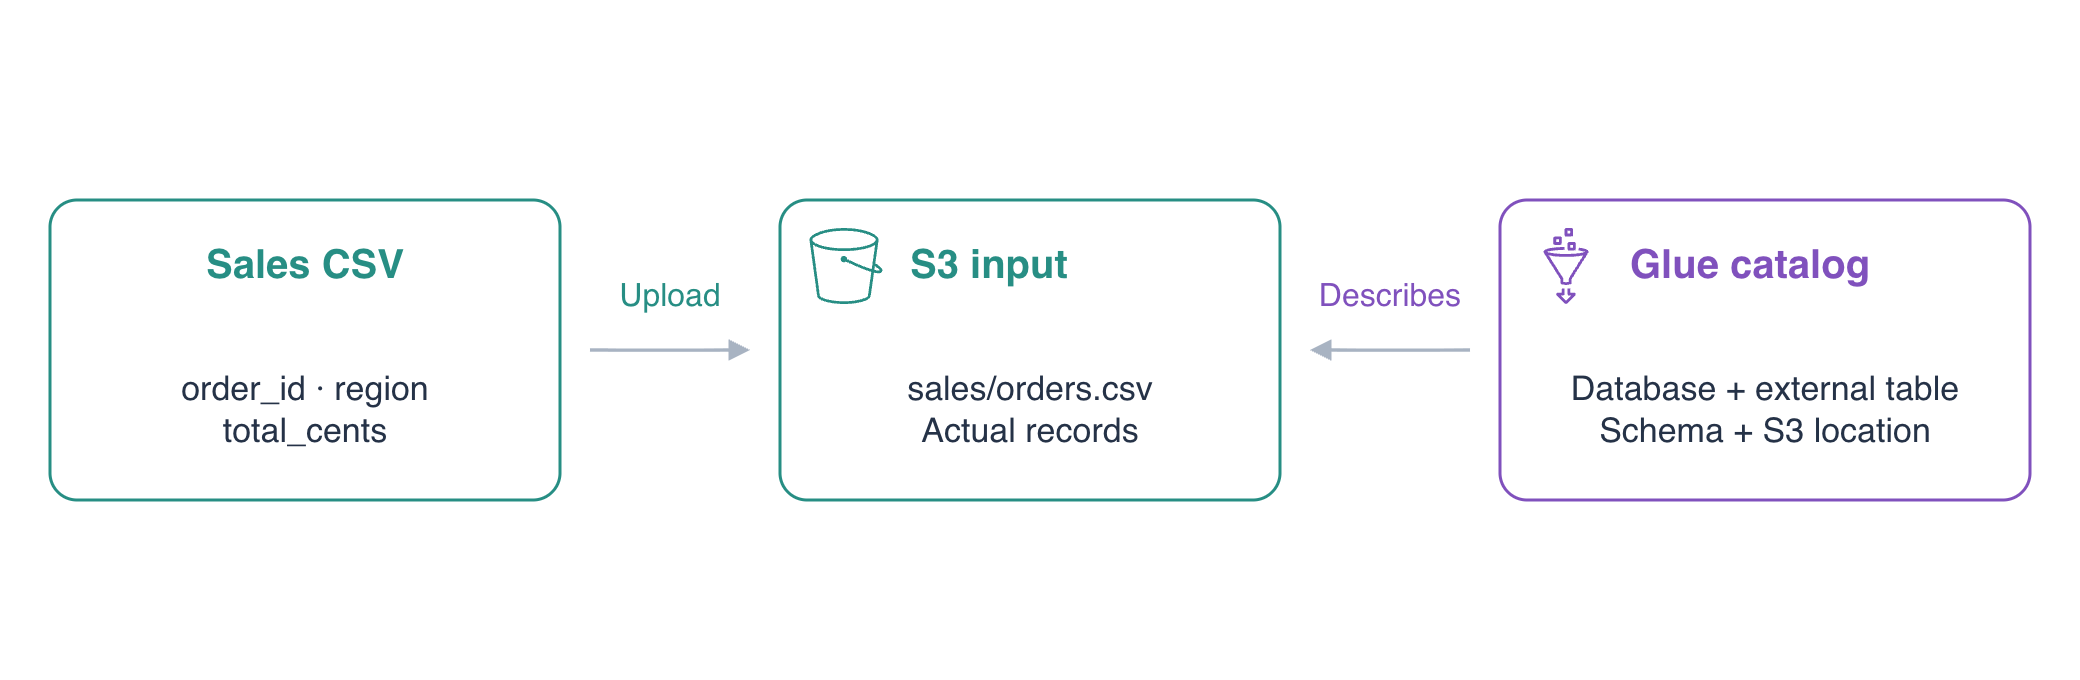
작은 상점이 판매를 CSV로 내보냅니다. 분석가는 데이터베이스 서버로 복사하지 않고 파일을 조회하려고 합니다. Amazon S3에 파일을 저장하고 AWS Glue Data Catalog로 설명하세요. 이 메타데이터 디렉터리는 쿼리 서비스에 데이터 위치와 읽는 방법을 알려 줍니다.
AWS Foundations for Beginners, 기본 S3 객체 작업, IAM 자격 증명 기초를 먼저 학습하세요. 독립 환경에는 빈 S3 버킷, CSV, 설정된 AWS CLI 자격 증명이 있습니다. 개인 계정이나 다른 실습의 리소스는 필요하지 않습니다. Terminal에서 명령을 실행하고 AWS View에서 실제 객체와 카탈로그를 확인하세요. 카탈로그는 파일을 설명하며 내용을 복사, 변환, 조회하지 않습니다. Athena는 다음 실습에서 사용합니다.
자격증 연계
| 자격증 | 시험 항목 | 실습 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | 파일 분석에서 Glue 카탈로그 역할과 S3 데이터 저장을 구분합니다. |
판매 파일 업로드
이 단계에서는 제공된 데이터를 확인하고 S3에 업로드합니다. CSV는 한 줄에 한 기록을 두고 쉼표로 필드를 구분합니다. 첫 줄에는 필드 이름이 있습니다. 스키마는 이름, 순서, 자료형을 정의하여 쿼리가 기록을 올바르게 해석하도록 합니다.
프로젝트로 이동해 설정된 자격 증명을 확인하세요:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN은 labex-an01-operator로 끝납니다. 이 사용자의 S3와 Glue 리소스를 사용합니다. September 파일을 읽으세요:
cat september.csv
세 판매 기록의 필드는 order_id, region, total_cents입니다. 앞의 두 필드는 문자열이며 금액은 정수 센트입니다. 1000, 2000, 500의 합계는 3500입니다. 값에는 따옴표가 없고 헤더는 한 줄입니다.
새 환경은 고유한 입력 버킷을 제공합니다. jq -r은 JSON 필드를 텍스트로 읽고 $(...)는 출력을 변수에 저장합니다. 이름을 저장하고 표시하세요:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
테이블이 읽을 데이터를 모으는 sales/ 접두사 아래 sales/orders.csv로 업로드하세요:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
업로드한 객체를 직접 다시 읽으세요:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
마지막 -는 S3 객체를 터미널에 출력합니다. 헤더와 세 기록이 september.csv와 같아야 합니다. AWS View에서 객체를 펼쳐 비교하세요. sales/ 밖의 관련 없는 reference/notes.txt는 변경하지 마세요.
카탈로그 데이터베이스 생성
이 단계에서는 테이블 정의를 담을 네임스페이스를 만듭니다. Glue 데이터베이스는 카탈로그 테이블을 모으고 메타데이터를 저장합니다. 데이터베이스 서버를 실행하지 않으며 생성해도 S3 파일이 이동하지 않습니다.
리소스 목록에서 이름을 읽으세요:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input은 이름과 설명의 일반 JSON 정의를 받습니다:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
성공한 생성 명령은 본문을 출력하지 않습니다. 다시 읽어 존재를 확인하세요:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
이름은 labex_sales, 설명은 지정한 값입니다. AWS View에는 데이터베이스와 아직 테이블이 없는 상태가 표시됩니다. S3 파일은 원래 위치에 있습니다.
외부 테이블로 파일 설명
이 단계에서는 CSV 필드를 이름과 자료형에 연결하고 실제 S3 접두사를 가리킵니다. 외부 테이블은 카탈로그 밖의 데이터를 설명합니다. 테이블 정의를 지워도 S3 객체 자체는 삭제되지 않습니다.
스토리지 설명자에는 열, 위치, 읽기 설정이 있습니다. SerDe는 직렬화/역직렬화 도구로 파일 기록을 테이블 필드로 해석합니다. LazySimpleSerDe는 여기의 따옴표 없는 쉼표 구분 값을 읽습니다. 헤더는 판매 기록이 아니므로 skip.header.line.count로 첫 줄을 건너뜁니다.
테이블 위치 접두사를 저장하고 표시하세요:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF는 마지막 EOF까지의 텍스트를 파일에 씁니다. 구분자에 따옴표가 없어 $SALES_LOCATION이 실제 버킷 접두사로 확장됩니다:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys는 비어 있습니다. 첫 테이블은 분할되지 않은 한 접두사를 읽으며 월별 파티션은 뒤에서 다룹니다. 두 형식 클래스는 텍스트 입력과 일반 Hive 호환 출력을 정의하며 직접 설치하거나 실행할 필요가 없습니다.
JSON으로 테이블을 만드세요. file://는 CLI 입력을 로컬 파일에서 읽습니다:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
Glue에서 정의를 다시 읽으세요:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
열 순서가 CSV 헤더와 같고 total_cents가 int, 위치가 /sales/로 끝나며 헤더 설정이 1인지 확인하세요. AWS View는 S3 객체와 Glue 정의를 나란히 표시합니다.
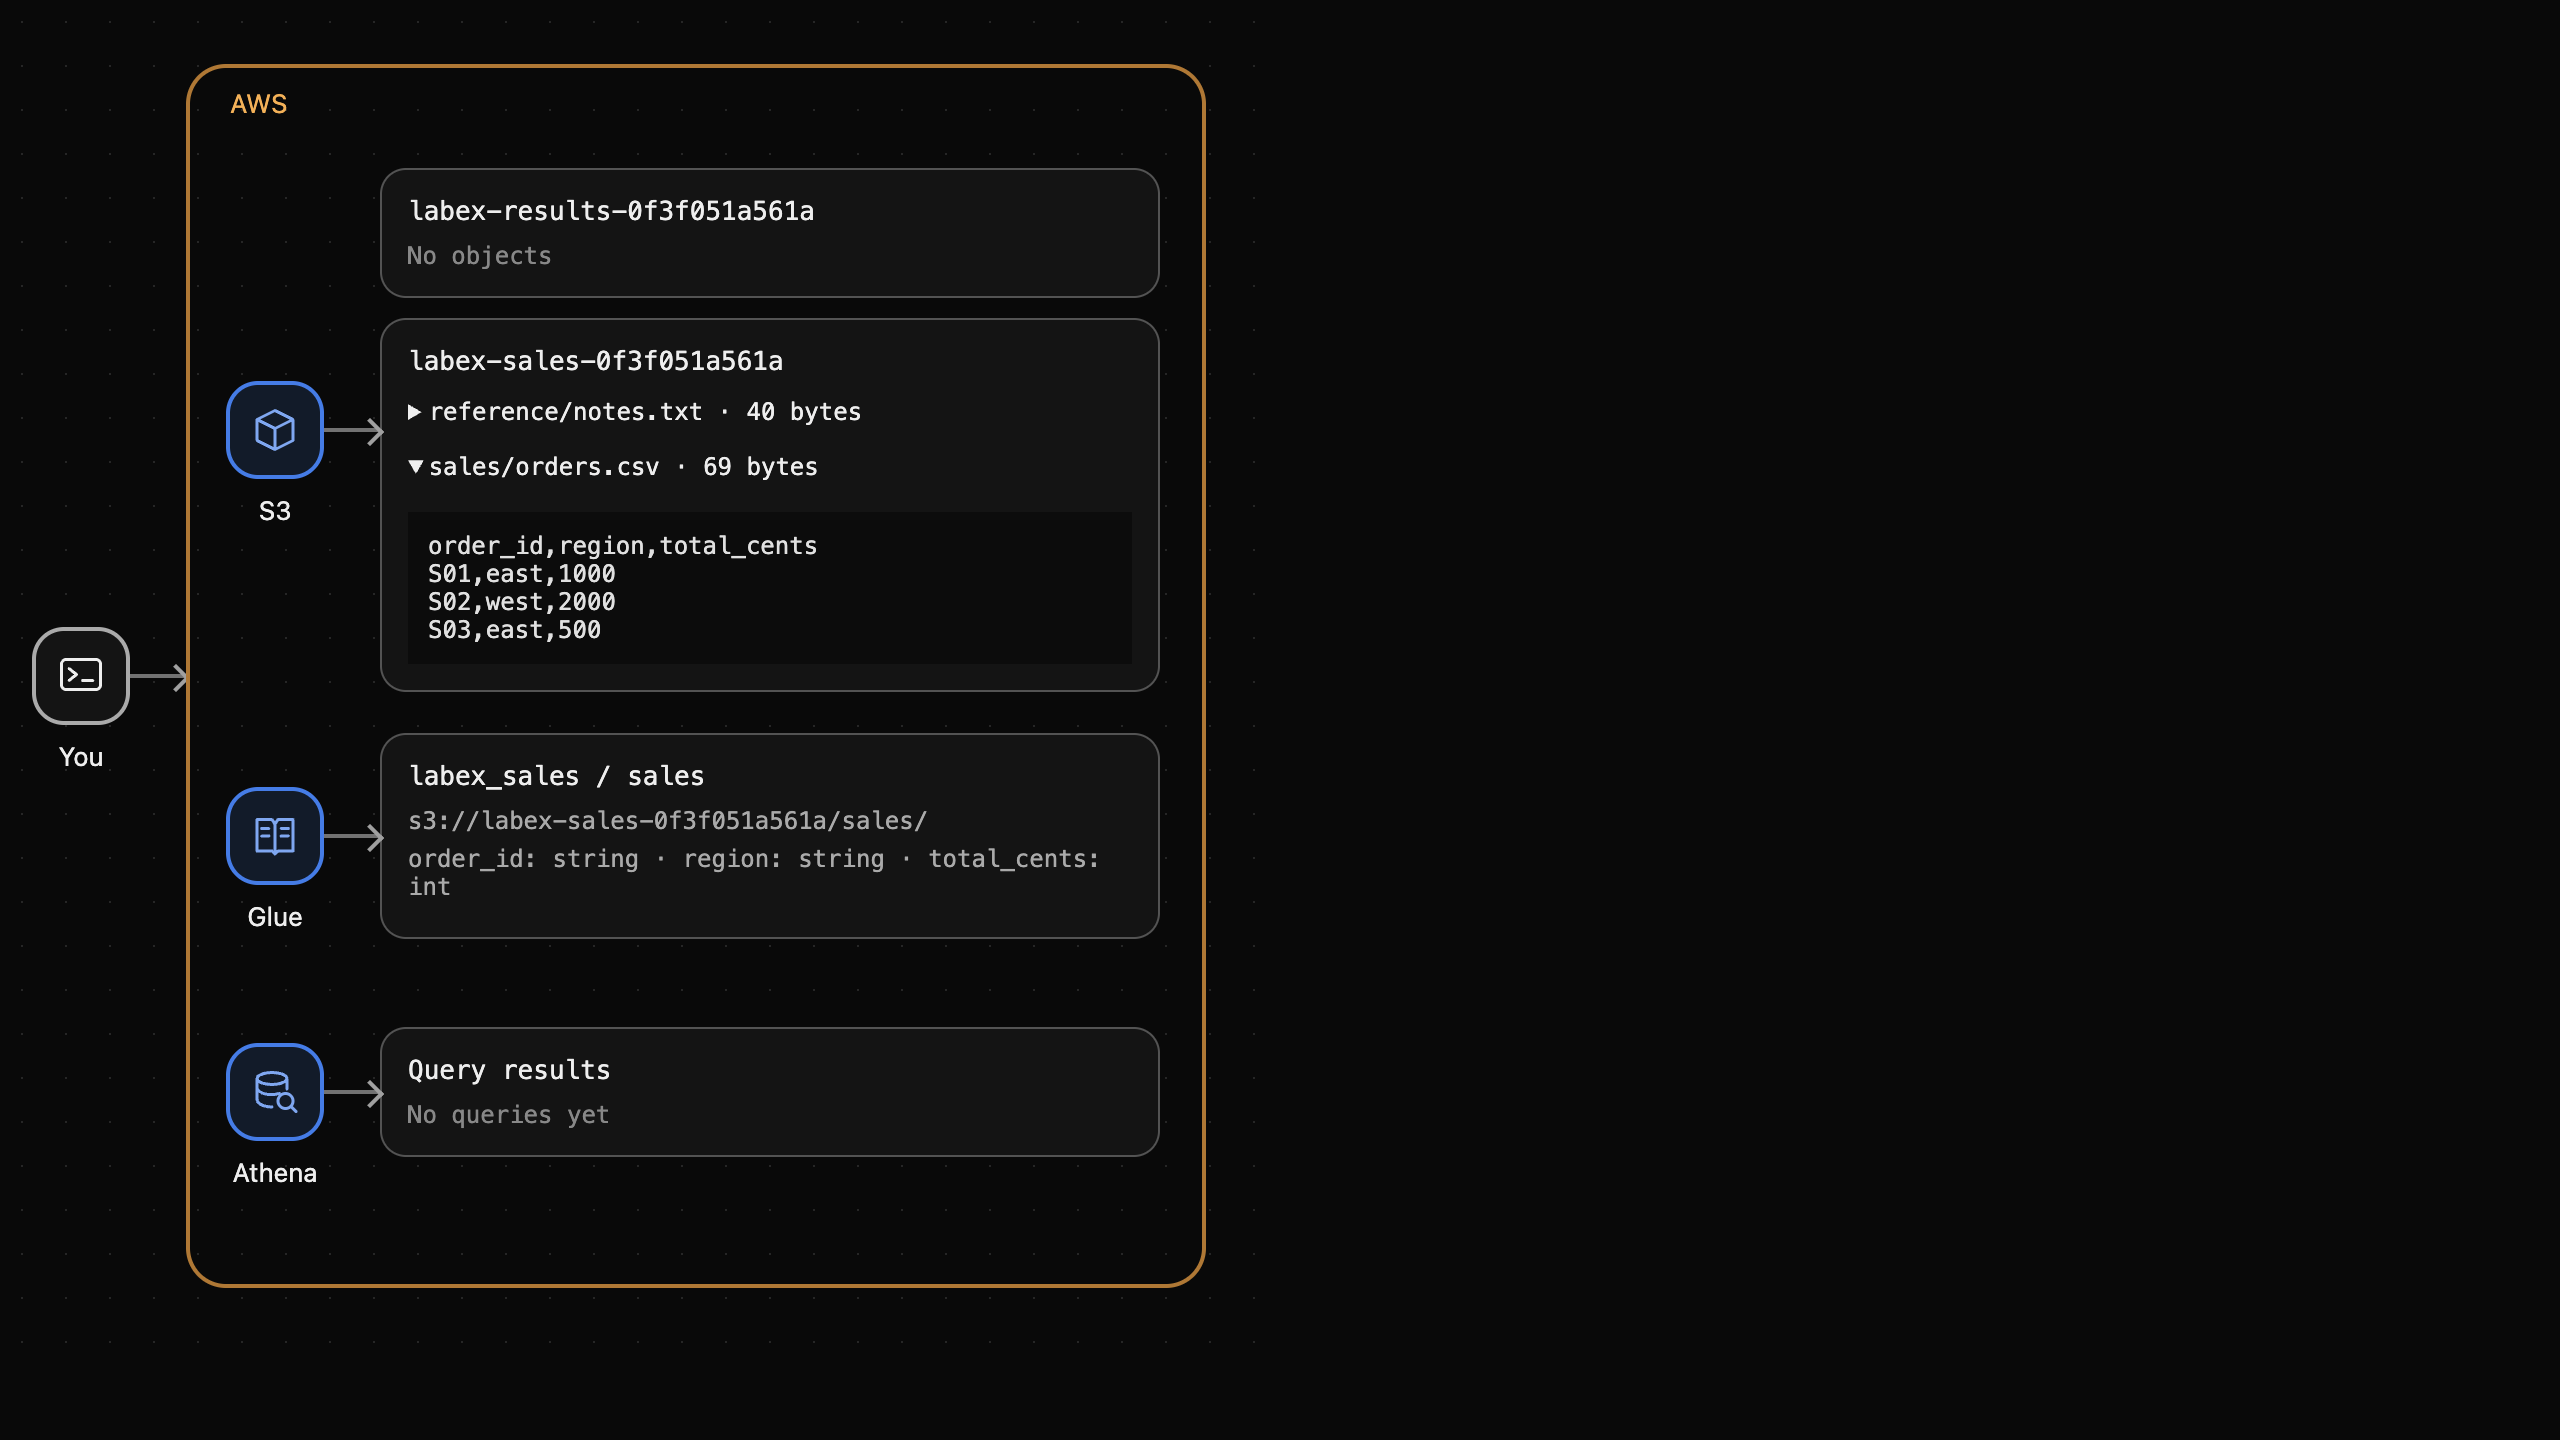
카탈로그 생성은 CSV를 바꾸거나 Athena 결과를 만들지 않습니다. 잘못된 스키마나 위치는 이후 쿼리 실패나 다른 기록 읽기로 이어집니다. 올바른 메타데이터가 조회의 기반이 됩니다.
요약
실제 판매를 S3에 업로드하고 Glue 데이터베이스와 열, CSV 형식, 위치가 일치하는 외부 테이블을 만들었습니다. S3는 데이터, Glue는 메타데이터를 저장합니다. 다음 실습에서는 이 카탈로그 모델로 독립적으로 준비된 데이터를 Athena에서 조회합니다.
자세한 내용은 AWS 공식 문서를 참고하세요: 카탈로그 메타데이터 수동 정의; 따옴표 없는 CSV 필드 및 헤더 처리.