소개
운영 팀에는 요청이 실패하면 활성화되고 정상 트래픽 이후 복구되는 오류 신호가 필요합니다. 지표 경보를 설정하고 실제 요청에서 발생한 두 상태 전환을 관찰하며, 0과 누락 데이터를 비교한 뒤 자신의 경보를 제거합니다.
지표 차원과 Sum을 포함한 CloudWatch 지표로 애플리케이션 상태 측정을 먼저 완료하세요. 이 실습에는 새로운 애플리케이션과 지표 시리즈가 제공됩니다.
인증 시험 관련 주제
| 자격증 | 시험 과제 | 실습 내용 |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | 태스크 1.1 | CloudWatch 경보 평가, 정상 상태 복귀와 누락된 데이터. |
| DevOps Engineer – Professional (DOP-C02) | 태스크 4.2 | 기초 실습: CloudWatch 경보 평가, 정상 상태 복귀와 누락된 데이터. |
| Solutions Architect – Professional (SAP-C02) | 태스크 3.1 | 기초 실습: CloudWatch 경보 평가, 정상 상태 복귀와 누락된 데이터. |
실습 개요
지표 경보 설정
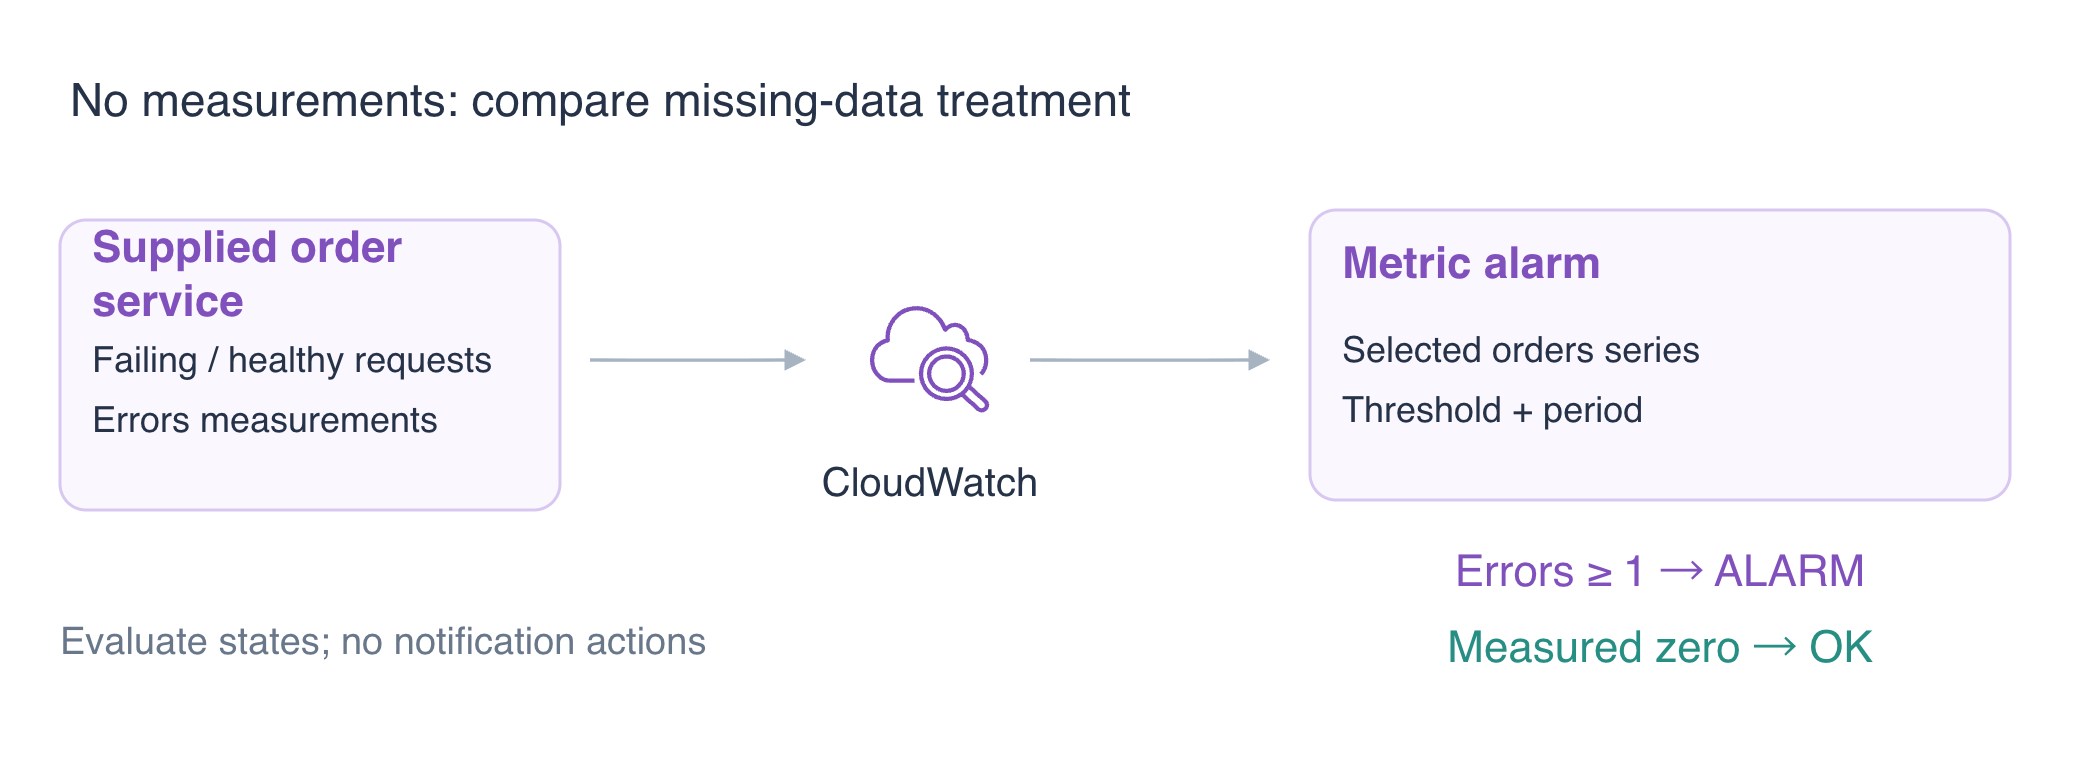
이 단계에서는 orders 애플리케이션의 서버 오류 수를 감시합니다. 경보는 지표를 임계값과 비교해 평가하고 OK, ALARM 또는 INSUFFICIENT_DATA를 표시합니다. 작업이 설정되지 않으면 알림을 보내지 않습니다. 이 실습은 평가에 집중합니다.
독립적으로 준비된 애플리케이션은 실제 요청 지표를 게시합니다. Errors 지표는 HTTP 5xx일 때 1, 정상 요청일 때 0입니다. 고해상도 게시로 10초 주기를 사용할 수 있어 여러 주기를 빠르게 관찰할 수 있습니다. 운영 환경의 주기와 임계값은 작업 부하와 비용에 따라 달라집니다.
cd /home/labex/project
단일 지표 경보를 생성하세요. 네임스페이스, 이름, 차원은 시리즈를 선택합니다. Sum은 완료된 각 주기의 오류 수를 셉니다.
이 경보는 완료된 10초 주기 하나를 평가합니다 (--period 10, --evaluation-periods 1). Sum이 1 이상이면 임계값에 도달합니다. GreaterThanOrEqualToThreshold는 “크거나 같다”를 뜻합니다. notBreaching은 측정값이 없는 주기를 임계값을 넘지 않은 것으로 처리합니다. 유휴 주기를 OK로 유지하지만 애플리케이션의 정상 상태를 입증하지는 않습니다.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
아래 명령으로 경보를 읽으세요. 아직 평가를 기다리는 중이면 몇 초 기다린 뒤 OK가 표시될 때까지 이 읽기 명령을 반복하세요.
초기 OK는 성공한 상태 확인이 아니라 누락 데이터 처리 때문에 나타납니다. 평가 이유를 검사하세요.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
/labex/o03-reference는 그대로 유지하세요. 각 실습은 독립적으로 시작하며 이전 지표 데이터는 필요하지 않습니다.
실제 실패로 경보 발생시키기
이 단계에서는 실제 실패 요청을 생성하고 자동 평가를 기다립니다. 완료된 주기에는 현재 진행 중인 주기의 포인트가 포함되지 않습니다. HTTP 응답 확인과 경보 상태 확인은 별개의 관찰입니다.
제공된 서비스에서 pear는 재고가 없습니다. 반복문은 여러 10초 주기에 걸치도록 2초 간격으로 요청 아홉 개를 보냅니다. for는 명령을 반복하고 sleep 2는 요청 사이에 일시 정지합니다. -f 없는 curl은 HTTP 503에서도 응답 본문을 반환하므로 실패를 관찰할 수 있습니다.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
평가된 상태를 읽으세요. 아직 ALARM에 도달하지 않았다면 몇 초 기다린 뒤 이 명령을 반복하세요. StateReasonData는 문자열로 저장된 JSON이므로 응답에서 따옴표가 이스케이프되어 표시됩니다. recentDatapoints는 평가한 주기의 합계를 나열합니다.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
ALARM과 StateReasonData 안의 1 이상인 recentDatapoints 값을 확인하세요. 평가가 아직 이전 주기를 보여 준다면 몇 초 기다린 뒤 읽기 명령을 반복하세요. 상태는 실제 요청에서 얻은 데이터 포인트를 따릅니다. 경보 상태를 수동으로 설정하지 마세요. 경보는 orders만 감시하므로 다른 애플리케이션의 시리즈는 이 평가에 들어가지 않습니다.
주문 팀에서 ALARM은 선택한 기간에 서버 오류가 있었는지 알려 줍니다. 어떤 요청이 실패했는지 또는 재고가 왜 부족했는지는 설명하지 않습니다. HTTP 응답은 비즈니스 요청의 실패를, 평가된 데이터 포인트는 경보 상태의 전환을 입증하며, 요청 로그는 진단에 필요한 세부 정보를 제공합니다. 조사 방향을 정할 때 이 증거들을 구분하세요.
복구 및 누락 데이터 관찰
이 단계에서는 실제 0과 없는 원격 측정 데이터를 구별합니다. 정상 apple 요청을 보내 완료된 주기에 측정된 Errors=0이 포함되도록 하세요. 여러 주기에 걸쳐 반복하면 현재 진행 중인 집계 구간을 복구로 오인하지 않을 수 있습니다.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
평가된 상태를 읽으세요. 아직 OK에 도달하지 않았다면 몇 초 기다린 뒤 이 명령을 반복하세요.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
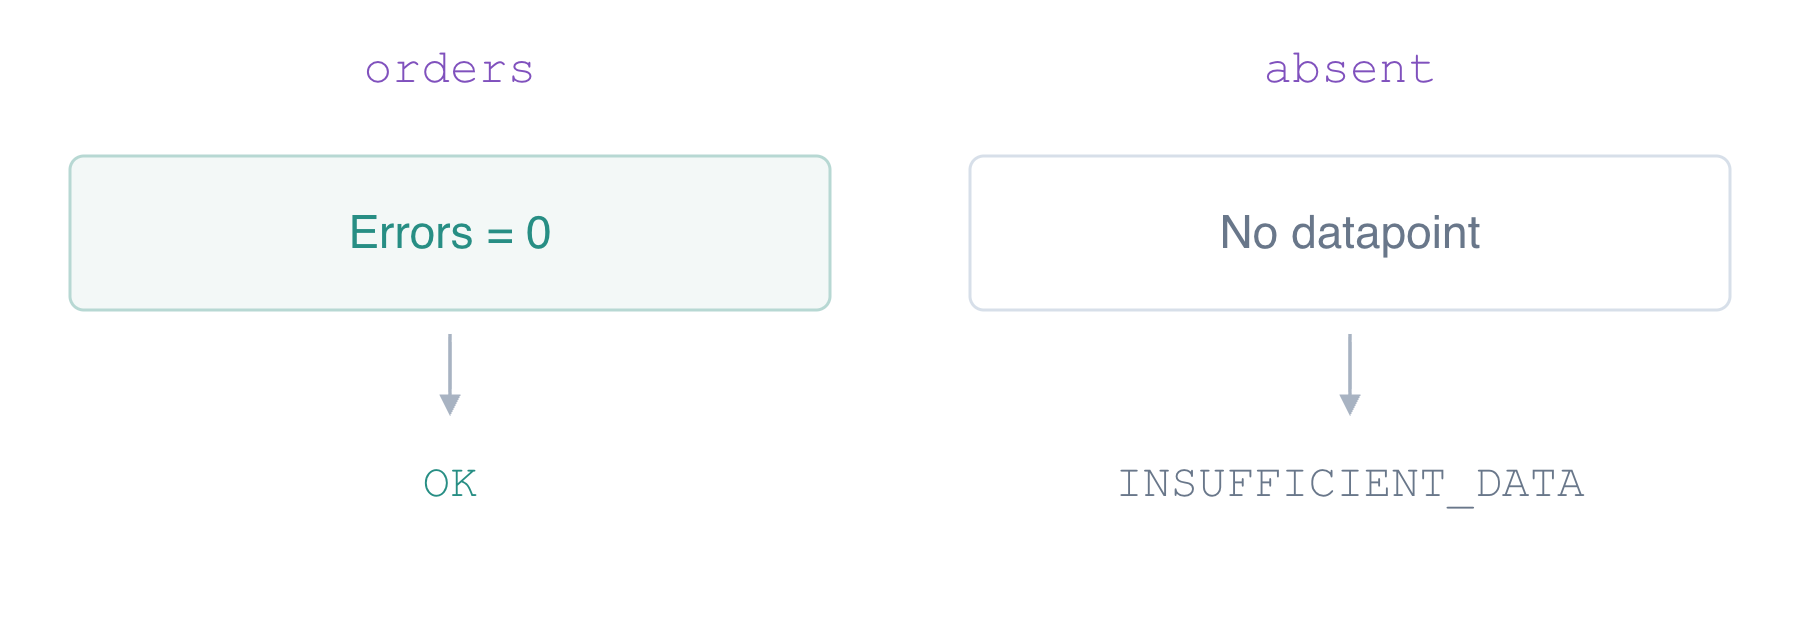
recentDatapoints: [0]과 함께 OK를 확인하세요. 빈 목록은 원격 측정 데이터가 없다는 뜻이므로 계속하기 전에 측정된 0을 확인하세요.
애플리케이션이 전혀 게시하지 않는 시리즈인 Application=absent에 대해 별도 경보를 생성하세요. 누락 데이터를 정상으로 처리하는 대신 누락으로 처리하세요.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
선택한 시리즈에 측정값이 없으므로 새 경보는 INSUFFICIENT_DATA로 유지되어야 합니다.
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
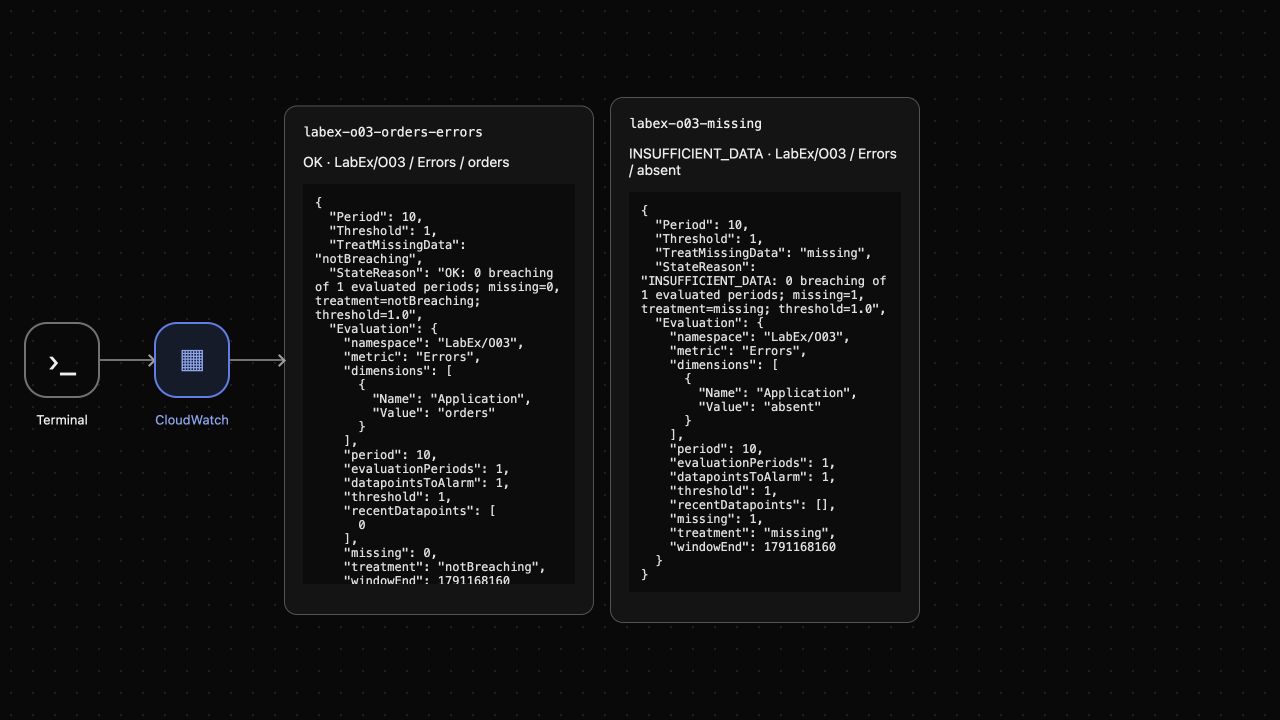
측정된 0에 따른 orders의 OK와 absent의 INSUFFICIENT_DATA를 확인하세요. 평가 이유로 측정된 0과 누락된 원격 측정 데이터를 구별하세요.
AWS View는 실제 서비스 상태와 평가된 데이터 포인트를 표시합니다. 모든 OK를 애플리케이션 정상 상태의 증거로 간주하지 말고 이유를 비교하세요.
소유한 경보 제거 및 게시 중단
이 단계에서는 이 실습의 경보만 제거하고 관련 없는 데이터를 보존합니다. 정리 전에 계측을 비활성화해 애플리케이션이 새 포인트 게시를 중단하도록 하세요.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
빈 경보 목록과 INFO platform reference keep unchanged를 확인하세요. 기존 지표 포인트는 보존됩니다. CloudWatch에는 개별 지표를 삭제하는 명시적 API가 없습니다. 이후 작성자 및 플랫폼 정리가 이 일회성 환경을 제거합니다.
요약
오류 경보를 설정하고 실제 요청에 따른 자동 발생과 복구를 관찰했으며, 측정된 0과 누락 데이터를 구별했습니다. 참조 로그를 보존하면서 소유한 경보를 제거했습니다.
자세한 내용은 AWS 공식 문서를 참고하세요: 지표 경보 및 작업; 누락된 데이터가 있을 때 경보 평가.