Introducción
V03 convirtió una pregunta en un embedding y recuperó artículos de ayuda cercanos. Sin embargo, un sistema de soporte real suele atender a más de un cliente, y la similitud semántica por sí sola nunca debe decidir qué documentos de un cliente puede ver quien realiza la solicitud.
Este laboratorio añade dos límites de búsqueda. Un namespace de Vectorize es una partición dentro de un índice; buscar en un namespace excluye los vectores de todos los demás namespaces antes de comenzar la clasificación por similitud. Después, un filtro de metadatos reduce esa partición del cliente mediante un campo como category. Puede pensar en el namespace como el archivador correcto y en el filtro de categoría como un cajón dentro de ese archivador.
Ninguno de estos mecanismos autentica a una persona. La aplicación debe validar primero un inicio de sesión, un token u otra señal de identidad, y derivar el namespace en el servidor. Para que el ejercicio sea seguro y reproducible, este Worker usa dos etiquetas de sesión sintéticas públicas que representan sesiones ya validadas. Son elementos de prueba didácticos, no credenciales reales ni un sistema de autenticación completo. Nunca se permite que una solicitud elija su propio cliente o namespace.
Implementará un Worker desechable con bindings de Workers AI y Vectorize. Cuatro artículos sintéticos incluyen deliberadamente el mismo texto de contraseña en dos namespaces de clientes. Los embeddings en tiempo real hacen que la búsqueda sea realista, mientras que las comprobaciones exactas de namespace, categoría e ID demuestran el aislamiento sin evaluar las puntuaciones exactas de un modelo. También probará un resultado vacío autorizado y rechazará un intento de anular el ámbito antes de llamar a cualquiera de los dos servicios en la nube.
Si ha accedido directamente a este curso, complete primero Conectar LabEx a su cuenta de Cloudflare. V01–V03 también son requisitos previos: presentan índices compatibles, mutaciones asíncronas y recuperación semántica.
El índice pequeño y las solicitudes acotadas a BGE Small caben en las asignaciones documentadas de Workers Free; no se requiere Workers Paid. Las llamadas a modelos locales o desplegados siguen consumiendo la asignación diaria compartida de Workers AI de la cuenta. Si esa asignación no está disponible, deténgase en lugar de repetir los intentos.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 como dependencia local del proyecto en /home/labex/project/scoped-vector-search. Proporciona pruebas deterministas y comprobaciones independientes de solo lectura, pero no autoriza Wrangler, crea un índice, despliega un Worker, ejecuta inferencias ni carga datos en la nube.
Autorizar y nombrar los recursos de búsqueda segmentada
En este paso autorizará la VM recién preparada y describirá un Worker junto con su índice de Vectorize asociado mediante la configuración habitual de Wrangler.
Entre en el proyecto preparado y confirme la versión fijada de la CLI:
cd /home/labex/project/scoped-vector-search
npx wrangler --version
Debe aparecer 4.132.0. La autorización mediante dispositivo permite que la VM reciba una concesión OAuth temporal sin recibir su contraseña de Cloudflare. Los ámbitos solicitados cubren la identidad de la cuenta, el índice desechable, el despliegue del Worker y el binding de Workers AI usado para los embeddings:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Abra en su navegador el enlace que se muestra, introduzca el código actual y apruebe la cuenta de aprendizaje prevista. De vuelta en la terminal, confirme loggedIn: true, authType: OAuth Token y el nombre de la cuenta antes de copiar su ID.
Genere un sufijo aleatorio y derive el nombre del índice a partir del nombre del Worker. Este patrón de propiedad permite limpiar los recursos con precisión más adelante:
RUN="labex-c08-v04-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Sustituya YOUR_ACCOUNT_ID por el ID que mostró whoami. Un binding proporciona al código del Worker un nombre local para un servicio de Cloudflare: AI creará embeddings y DOCUMENTS consultará exactamente el índice indicado en index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
El archivo nombra los recursos previstos, pero todavía no crea ninguno. Mantener explícitas la identidad y la propiedad antes de realizar una escritura es especialmente importante en una cuenta de aprendizaje compartida.
Crear un Worker de búsqueda con ámbito controlado por el servidor
En este paso implementará el límite antes de desplegarlo.
El encabezado x-lab-session utiliza solo dos etiquetas públicas para simular el resultado de una capa de autenticación anterior. resolveSession asigna ese contexto validado a un namespace en el servidor. El cuerpo de la solicitud puede elegir una consulta y una categoría permitida, pero no puede indicar un cliente ni un namespace. En una aplicación de producción, sustituya estas etiquetas por una sesión o un proveedor de identidad verificado correctamente; un namespace organiza datos, no autentica.
Los cuatro documentos incluyen el mismo texto de contraseña para los clientes blue y green. Esto hace que el resultado de seguridad sea fácil de observar: la similitud no puede distinguir las copias, de modo que solo el ámbito controlado por el servidor puede mantenerlas separadas.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);
const SESSION_CONTEXTS = Object.freeze({
  "blue-session": Object.freeze({ customer: "blue", namespace: "customer-blue" }),
  "green-session": Object.freeze({ customer: "green", namespace: "customer-green" })
});

const DOCUMENTS = [
  {
    id: "blue-password",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "blue-invoice",
    namespace: "customer-blue",
    category: "billing",
    title: "Download an invoice",
    text: "Download an invoice or receipt for a completed payment."
  },
  {
    id: "green-password",
    namespace: "customer-green",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "green-upload",
    namespace: "customer-green",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function resolveSession(label) {
  const context = SESSION_CONTEXTS[label];
  if (!context) throw new Error("session_invalid");
  return context;
}

export function parseSearchInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const query = typeof value.query === "string" ? value.query.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!query || query.length > 200) throw new Error("query_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { query, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    namespace: document.namespace,
    values: vectors[index],
    metadata: {
      category: document.category,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "scoped_documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let context;
  try {
    context = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch (error) {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 3,
    namespace: context.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });
  const matches = result.matches.map((match) => ({
    id: match.id,
    score: match.score,
    namespace: match.namespace,
    title: match.metadata?.title,
    category: match.metadata?.category
  }));
  console.log(JSON.stringify({
    event: "scoped_search",
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    returnedCount: matches.length
  }));
  return json({
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    candidateCount: result.matches.length,
    matches
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Ejecute las pruebas deterministas. Sus bindings en memoria demuestran que el Worker construye ambos límites de consulta a partir del contexto del servidor sin consumir cuota en la nube:
node --test test/worker.test.mjs
Deben aprobarse seis pruebas. Genere los tipos de binding a partir de la configuración real y cree el paquete sin desplegarlo:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v04-dry-run
El archivo generado debe contener AI: Ai y DOCUMENTS: VectorizeIndex. La ejecución de prueba demuestra que el código fuente y la configuración pueden empaquetarse juntos; no crea ni prueba ninguno de los dos recursos en la nube.
Crear el índice filtrable y desplegar
En este paso creará el índice compatible, preparará el campo category para filtrarlo y desplegará el Worker solo después de que esa preparación se haya procesado.
Un vector puede almacenar metadatos sin hacer que estos se puedan buscar. Un índice de metadatos indica a Vectorize qué campo debe organizar para las consultas que aplican primero el filtro. Debe existir antes de insertar los vectores de los documentos; de lo contrario, los registros anteriores no participarán en ese filtro de metadatos.
Cree un índice de 384 dimensiones con métrica coseno, compatible con BGE Small. --update-config=false impide que Wrangler reescriba el binding explícito que ya revisó:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Ahora ponga en cola la preparación del campo de tipo cadena category y conserve su identificador de mutación:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Una mutación aceptada es trabajo en cola, no trabajo completado. Escriba un comprobador acotado de solo lectura que reutilizará después de cargar los datos. Requiere tres lecturas consecutivas de la misma mutación y del mismo recuento de vectores, para que una lectura temporalmente obsoleta no se convierta en la evidencia final del laboratorio:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
La mutación puede procesarse antes de que la vista de lista independiente se actualice. Use un bucle acotado de solo lectura para esperar a que aparezca la fila visible category, en lugar de tratar una respuesta de lista obsoleta como un error:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Debe aparecer category con el tipo String. Finalmente, despliegue el Worker cuyo binding DOCUMENTS apunta a este índice preparado:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
El índice todavía está vacío. El despliegue conecta los bindings, pero no crea automáticamente embeddings de documentos.
Cargar datos en dos namespaces de clientes
En este paso creará embeddings en tiempo real y almacenará cada registro exactamente en un namespace de cliente, junto con sus metadatos de categoría.
Un namespace pertenece al propio registro vectorial. Los dos registros de contraseña contienen deliberadamente el mismo texto, pero viven en particiones diferentes. category es un metadato independiente, por lo que un registro puede pertenecer al namespace blue y a la categoría account al mismo tiempo.
Llame una vez al endpoint fijo de carga inicial. El corpus está controlado por el servidor, por lo que el cuerpo de la solicitud está vacío:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " scoped vectors in mutation " + value.mutationId);
'
Debe aparecer count: 4, 384 dimensiones, pooling cls y un UUID de mutación. Espere a esa mutación y a ese recuento exactos, en lugar de adivinar cuántos segundos necesita el servicio:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 4
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'blue-password' <<<"$VECTOR_LIST" &&
     grep -q 'blue-invoice' <<<"$VECTOR_LIST" &&
     grep -q 'green-password' <<<"$VECTOR_LIST" &&
     grep -q 'green-upload' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in blue-password blue-invoice green-password green-upload; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed vector %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
El inventario debe contener blue-password, blue-invoice, green-password y green-upload. Los ID relacionan las coincidencias con los documentos de origen; el namespace y la categoría determinan si un registro que, por lo demás, es similar puede participar en una consulta.
Demostrar el aislamiento por cliente y categoría
En este paso ejecutará la misma pregunta semántica como dos clientes y después probará un resultado vacío autorizado y una anulación no segura.
Comience con la sesión sintética blue y la categoría account:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/blue-account.json
La respuesta debe indicar customer: blue, namespace: customer-blue y únicamente blue-password. Ahora envíe la misma pregunta con la sesión green:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: green-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/green-account.json
Esta vez, solo green-password puede participar. El texto del documento es idéntico, por lo que la diferencia procede del namespace seleccionado por la sesión validada, no del modelo de embeddings ni de una puntuación afortunada.
Después, solicite la categoría files desde la sesión blue. Existe un artículo de carga de archivos green muy relevante, pero el namespace blue no contiene ningún artículo de archivos:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files"}' \
  | tee .labex/blue-files-empty.json
Debe obtener candidateCount: 0 y matches: []. Un resultado vacío es la respuesta autorizada correcta; tomar un registro relevante de otro namespace supondría una filtración de datos.
Por último, intente anular el namespace desde el cuerpo de la solicitud:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files","namespace":"customer-green"}'
cat .labex/override-response.json
Debe obtener HTTP 400 y scope_override_not_allowed. El Worker rechaza el campo antes de ejecutar el embedding o la consulta de Vectorize. Un cliente puede solicitar una categoría permitida, pero solo la lógica confiable del servidor asigna la identidad a un namespace de cliente.
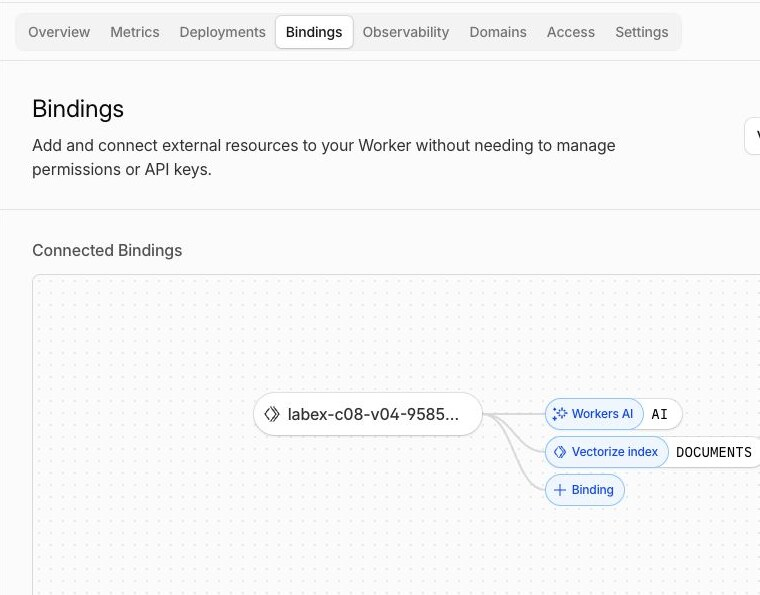
Abra Workers & Pages → su Worker labex-c08-v04-... → Bindings. Confirme que AI apunta a Workers AI y que DOCUMENTS apunta exactamente al índice desechable de Vectorize. Esta relación visual explica cómo env.AI y env.DOCUMENTS del código acceden a los servicios administrados; las comprobaciones independientes siguen demostrando las identidades exactas de los bindings.
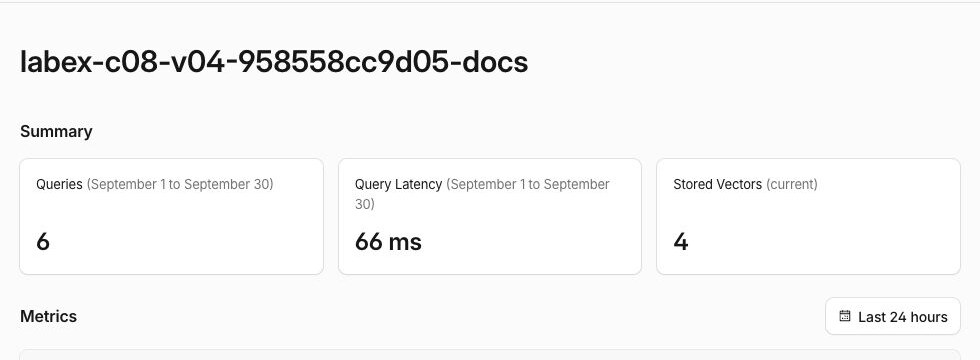
Después, abra AI → Vectorize → el índice -docs correspondiente. El recuento actual de vectores debería llegar finalmente a cuatro, y las métricas de consultas deberían empezar a reflejar las búsquedas segmentadas. Los contadores del panel pueden tardar en actualizarse; las lecturas autenticadas de registros y las respuestas HTTP siguen siendo la fuente autoritativa para los ID, namespaces y categorías exactos.
Si Workers Logs está disponible, abra la vista Observability → Logs del Worker e inspeccione una entrada scoped_search. Registra únicamente la etiqueta sintética del cliente, el namespace, la categoría y el recuento devuelto, no el texto de la pregunta ni la etiqueta de sesión. Los logs estructurados y limitados en cuanto a privacidad ayudan a diagnosticar qué ámbito seleccionado por el servidor se ejecutó sin copiar contenido confidencial de la solicitud.
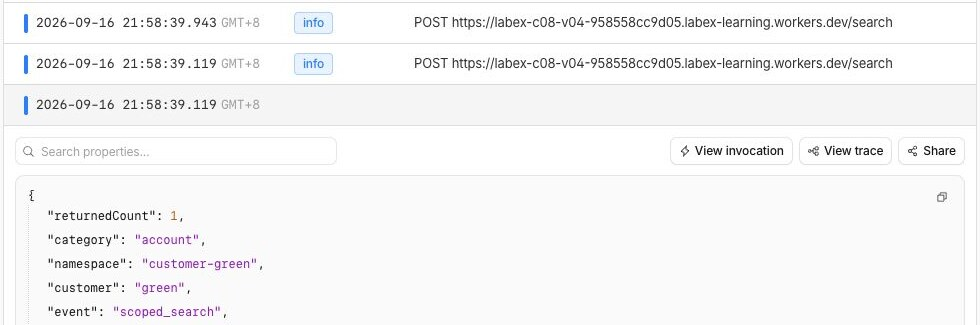
Estas capturas muestran ejemplos concretos de una ejecución de prueba desechable. El nombre aleatorio de sus recursos, las marcas de tiempo, la latencia y el total de consultas serán diferentes; compare los nombres de los bindings, el recuento actual de vectores y las relaciones entre campos, en lugar de copiar los valores del ejemplo.
Eliminar los recursos de búsqueda segmentada
En este paso eliminará el Worker y el índice desechables y demostrará que ya no existen mientras Wrangler sigue autorizado.
Recupere los nombres exactos de wrangler.jsonc para que la limpieza no dependa de variables de una sesión anterior de la terminal:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Confirme que ambos valores comienzan por su prefijo único labex-c08-v04-.... Elimine primero el Worker para que ningún código desplegado conserve el binding; después, elimine únicamente el índice asociado:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Guarde un inventario autenticado correcto y compruebe el nombre exacto:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Complete este paso antes de cerrar la sesión. Un error de red o de autorización no permite sacar conclusiones; la evaluación requiere de forma independiente lecturas correctas de la cuenta y la ausencia del nombre exacto.
Cerrar la sesión de la VM de aprendizaje
En este paso eliminará la autorización temporal de Wrangler de esta VM. Los recursos en la nube ya no existen y la comprobación de limpieza autenticada se ha realizado correctamente:
npx wrangler logout
npx wrangler whoami --json
Debe aparecer loggedIn: false. La sesión del navegador en Cloudflare Dashboard es independiente y seguirá disponible para su cuenta de aprendizaje.
Resumen
Añadió dos comprobaciones independientes de elegibilidad a la recuperación semántica. Una sesión sintética validada seleccionó un namespace de cliente en el servidor, y un campo category indexado redujo esa partición antes de que Vectorize clasificara los resultados. Los documentos de contraseña idénticos demostraron que la similitud por sí sola no puede imponer el aislamiento entre clientes, mientras que la consulta de archivos de blue mostró que un resultado vacío autorizado es más seguro que tomar un registro relevante de otro cliente.
También rechazó las anulaciones de cliente y namespace proporcionadas por el cliente antes de ejecutar inferencias, inspeccionó en el Dashboard las relaciones reales entre bindings, índice y logs limitados en cuanto a privacidad, eliminó el Worker y el índice desechables mientras seguía autorizado y, finalmente, cerró la sesión. V05 reutilizará este límite seguro de recuperación para reunir evidencia de origen acotada antes de que un modelo de lenguaje responda.