Introducción
V01 almacenó vectores identificados y V02 mantuvo esos registros actualizados. En este laboratorio añadirá la ruta de lectura que falta: una persona escribe una pregunta, la aplicación convierte ese texto en un vector compatible y pregunta a Vectorize qué documentos almacenados apuntan en las direcciones más cercanas.
Esto es búsqueda semántica. Compara embeddings orientados al significado en lugar de exigir que la consulta repita las palabras exactas de un artículo. La consulta y los documentos almacenados deben utilizar el mismo modelo, 384 dimensiones y el pooling cls. Una puntuación de similitud de Vectorize ayuda a ordenar los vectores compatibles con una consulta; no es un porcentaje de confianza universal ni demuestra que un artículo responda a la pregunta.
Construirá un Worker desechable con dos bindings de Cloudflare. AI enviará texto breve al modelo de embeddings alojado por Cloudflare @cf/baai/bge-small-en-v1.5. DOCUMENTS escribirá y consultará un índice desechable de Vectorize. El Worker expondrá una operación fija /seed para tres artículos de ayuda sintéticos y una operación /search que acepta una consulta, topK y una puntuación mínima opcional. topK significa «devuelva como máximo esta cantidad de candidatos más cercanos», no «estos candidatos son definitivamente relevantes».
Este es el tercer laboratorio de Vectorize. Si accedió directamente, complete primero Conecte LabEx a su cuenta de Cloudflare y, después, V01 y V02, para familiarizarse con la compatibilidad del índice, los ID estables y las mutaciones asíncronas.
Vectorize y Workers AI tienen asignaciones gratuitas. En este laboratorio almacenará tres vectores pequeños y realizará solo unas pocas solicitudes de embeddings breves. No necesita Workers Paid. La inferencia local o implementada sigue consumiendo la asignación diaria compartida de Workers AI; por eso, deténgase en lugar de reintentar repetidamente si el modelo o la asignación gratuita no están disponibles.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 local para el proyecto en /home/labex/project/vector-search. Proporciona pruebas deterministas y comprobaciones independientes, pero no autoriza Wrangler, llama a un modelo, crea un índice, implementa un Worker ni siembra datos en la nube.
Autorice y asigne nombres a los recursos de búsqueda
En este paso autorizará la máquina virtual recién preparada y creará una configuración que asigne nombres al Worker y a su índice de Vectorize asociado.
Entre en el proyecto preparado y confirme la versión fijada de la CLI:
cd /home/labex/project/vector-search
npx wrangler --version
Debe aparecer 4.132.0. Wrangler utiliza un flujo de dispositivo para que su contraseña nunca entre en la máquina virtual. Solicite acceso a la identidad de la cuenta, al Worker, a Vectorize y a Workers AI para este ejercicio desechable:
Wrangler separa la operación del índice de la implementación del script y de las comprobaciones de limpieza. Solicite workers:write para Vectorize, workers_scripts:write para el Worker, workers_kv:write para la comprobación de eliminación segura de dependencias de Wrangler y ai:write para el binding del modelo:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Confirme loggedIn: true y la cuenta de aprendizaje prevista. Genere un sufijo aleatorio y derive de él los nombres de ambos recursos para que la limpieza no los confunda con recursos ajenos:
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Sustituya YOUR_ACCOUNT_ID por el ID real de la cuenta seleccionada. Un binding es el nombre mediante el cual el código del Worker recibe un servicio administrado de Cloudflare. AI proporcionará la inferencia del modelo; DOCUMENTS proporcionará el índice exacto de Vectorize indicado por index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
La configuración asigna nombres a los recursos, pero no los crea. Esta separación le permite revisar el límite de propiedad previsto antes de modificar la cuenta.
Construya el Worker de búsqueda con los bindings
En este paso implementará la siembra fija de documentos y el endpoint de búsqueda destinado al usuario antes de implementar cualquier código.
Los tres documentos fuente permanecen en el código de la aplicación porque Vectorize almacena vectores y metadatos, no el sistema de registro completo de los artículos. /seed genera los embeddings de este corpus fijo una vez. /search genera el embedding de una consulta validada, solicita a Vectorize los candidatos más cercanos según topK y aplica minScore después. Los metadatos devueltos ayudan a la aplicación a convertir los ID de los vectores en referencias útiles.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Ejecute las pruebas deterministas. Sustituyen ambos bindings por pequeños recursos en memoria, por lo que comprueban la validación y el flujo de control sin consumir cuota de AI ni de Vectorize:
node --test test/worker.test.mjs
Deben aprobarse cinco pruebas. Después, genere los tipos de los bindings y pida a Wrangler que empaquete el Worker sin implementarlo:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
El archivo de tipos generado debe contener AI: Ai y DOCUMENTS: VectorizeIndex. Una ejecución en seco demuestra que el módulo y la configuración se pueden empaquetar juntos; no demuestra que los servicios en la nube existan.
Cree el índice e implemente ambos bindings
En este paso creará el índice vacío compatible y, después, implementará el Worker que recibe ambos bindings administrados.
El modelo de embeddings devuelve 384 números. La distancia coseno compara su dirección, así que cree un índice con el mismo contrato inmutable:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Implemente el Worker solo después de que exista el índice, porque Cloudflare debe resolver el binding configurado DOCUMENTS con un recurso real:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
Wrangler debe mostrar ambos bindings e imprimir la URL de workers.dev. Guarde la URL exacta en lugar de reconstruir un subdominio por aproximación:
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
En este momento el índice está intencionadamente vacío. La implementación conecta los servicios; no genera embeddings ni siembra documentos automáticamente.
Siembre embeddings de documentos reales
En este paso llamará una vez a la operación fija /seed, registrará su mutación y esperará hasta que los tres embeddings del modelo se puedan leer.
El Worker envía los tres textos breves de los documentos a BGE Small en un único lote. Valida la forma devuelta, asigna ID estables y metadatos útiles y, después, realiza un upsert de los registros. Llámelo con un objeto JSON vacío porque el corpus está controlado por el servidor:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
Debe recibir datos HTTP 202 que contengan count: 3, 384 dimensiones, pooling cls y un UUID de mutación. La mutación aceptada es asíncrona, así que cree la misma comprobación de estabilidad acotada que utilizó en los laboratorios anteriores. execFileSync ejecuta el proceso de Wrangler fijado, mientras que readFileSync lee la respuesta de siembra guardada; proceden de distintos módulos integrados de Node.js:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
Las tres lecturas coincidentes protegen el resultado visible frente a una réplica temporalmente obsoleta. Cuando el proceso de espera termine correctamente, enumere los ID estables de la aplicación:
npx wrangler vectorize list-vectors "$INDEX" --count=10
El inventario debe contener password-reset, upload-pdf y billing-receipt. Sus valores reales proceden del modelo alojado por Cloudflare en vivo, no de los vectores deterministas de enseñanza utilizados en V01 y V02.
Recupere e interprete artículos similares
En este paso enviará una pregunta clara sobre contraseñas, inspeccionará los dos candidatos más cercanos y distinguirá entre la clasificación y un resultado vacío explícito.
Solicite topK: 2. Vectorize puede examinar todo el índice pequeño, pero devuelve como máximo los dos candidatos más cercanos. El primer resultado debe ser el artículo sobre contraseñas porque la consulta y el artículo comparten un significado claro, aunque sus palabras exactas sean diferentes:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
Debe obtener dos filas ordenadas por puntuación descendente, con password-reset en primer lugar. Interprete las puntuaciones de forma comparativa: un valor mayor está más cerca para esta consulta y este índice compatibles, pero 0.8 no significa «80 % correcto». topK tampoco aplica un umbral de relevancia.
Ahora haga una pregunta no relacionada y establezca minScore: 1. Vectorize seguirá devolviendo tres candidatos a la aplicación, pero la aplicación eliminará todos los candidatos que estén por debajo del umbral:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
Debe obtener candidateCount: 3 y matches: []. Una lista de coincidencias vacía es una decisión explícita de la aplicación, no una prueba de que el índice no contenga vectores.
Por último, envíe una entrada vacía:
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
Debe obtener HTTP 400 y query_required. La validación ocurre antes de la llamada al modelo o a la base de datos, por lo que una entrada incorrecta no consume capacidad de inferencia ni de consulta.
Abra Workers & Pages → su Worker labex-c08-v03-... → Bindings. Un binding proporciona al código del Worker un nombre seguro para otro servicio de Cloudflare. Aquí, AI es el nombre que env.AI utiliza para ejecutar el modelo de embeddings, mientras que DOCUMENTS es el nombre que env.DOCUMENTS utiliza para consultar este índice exacto de Vectorize.
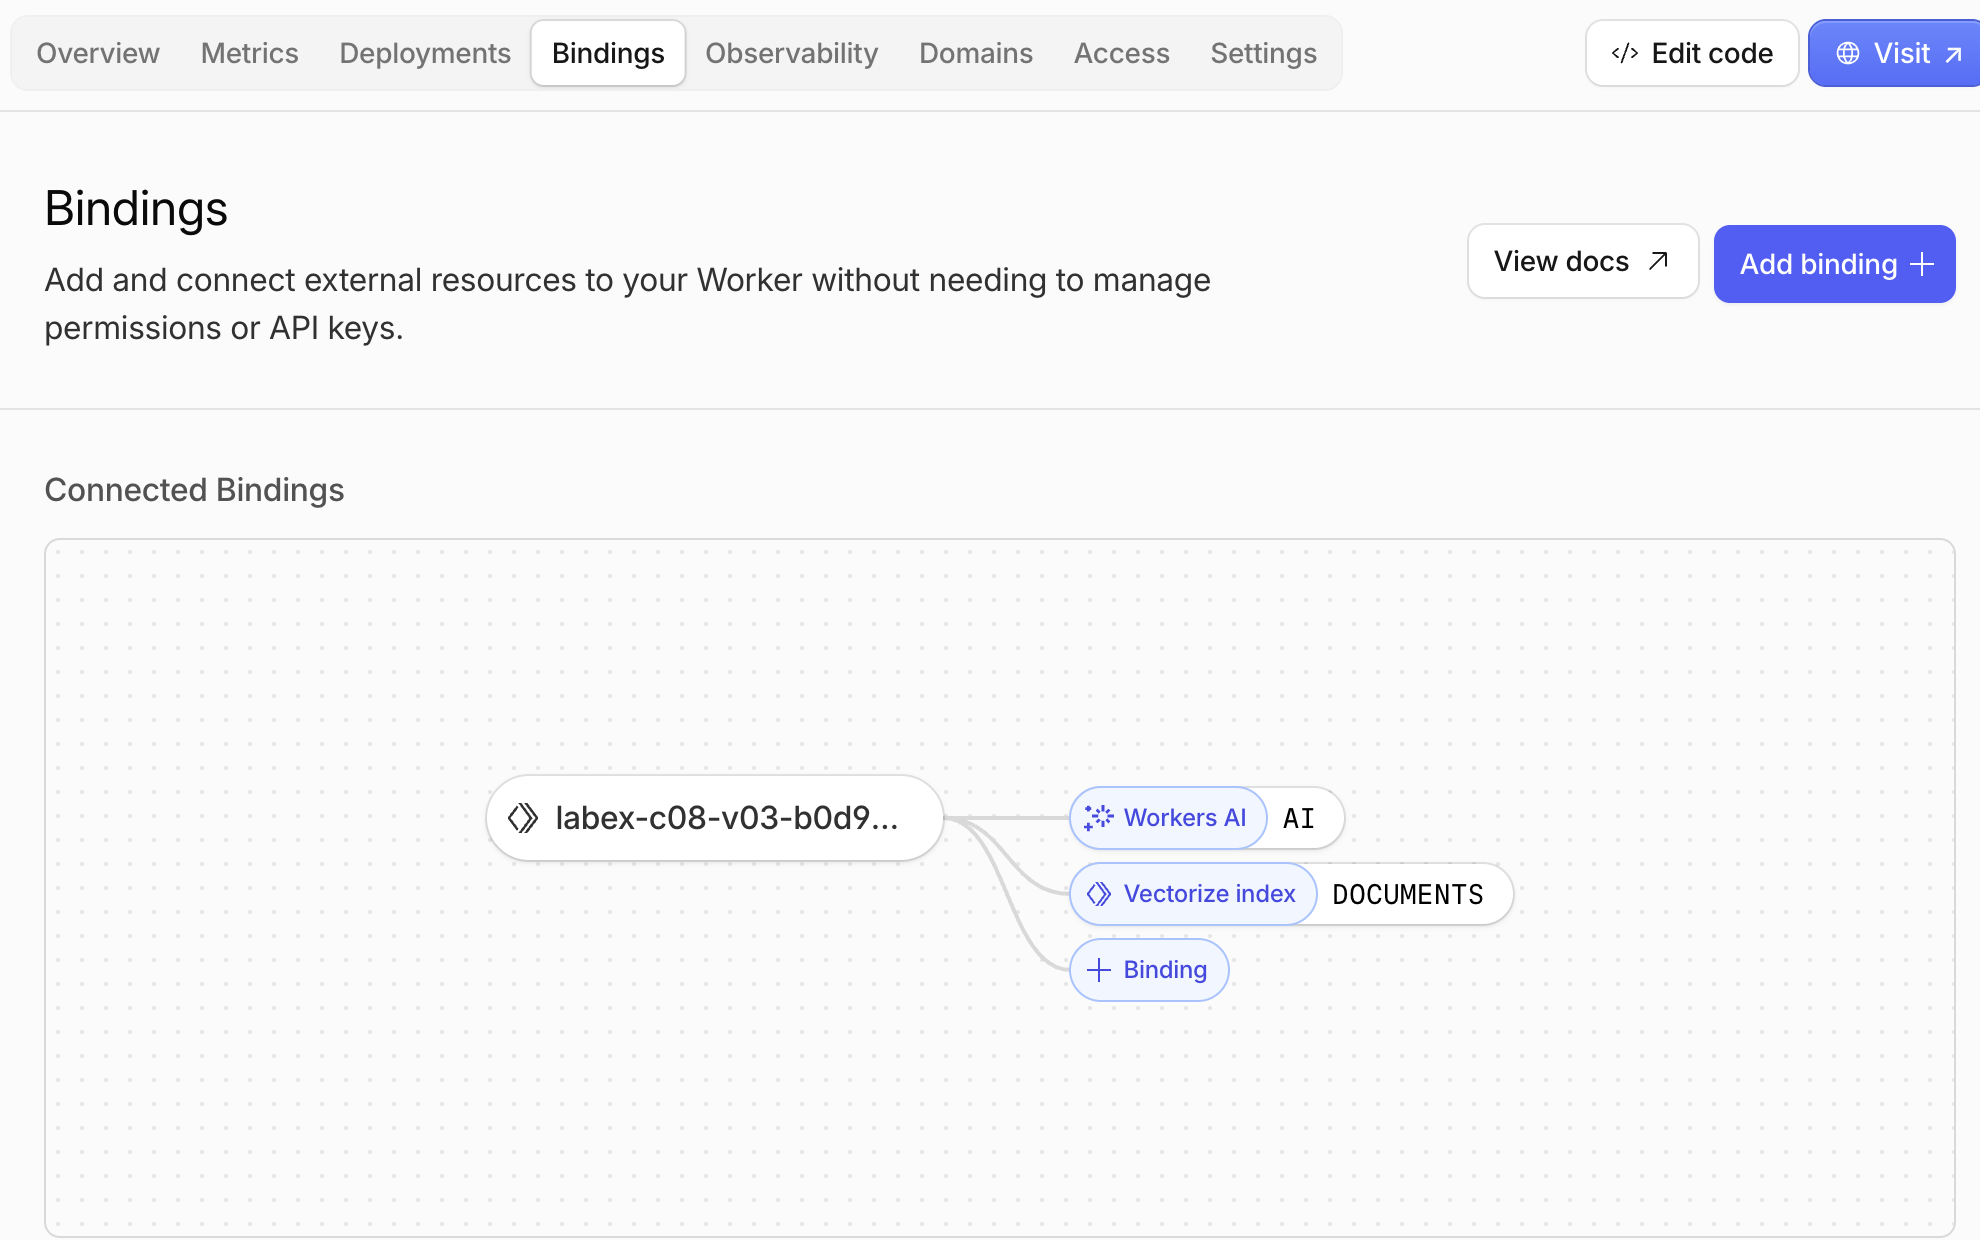
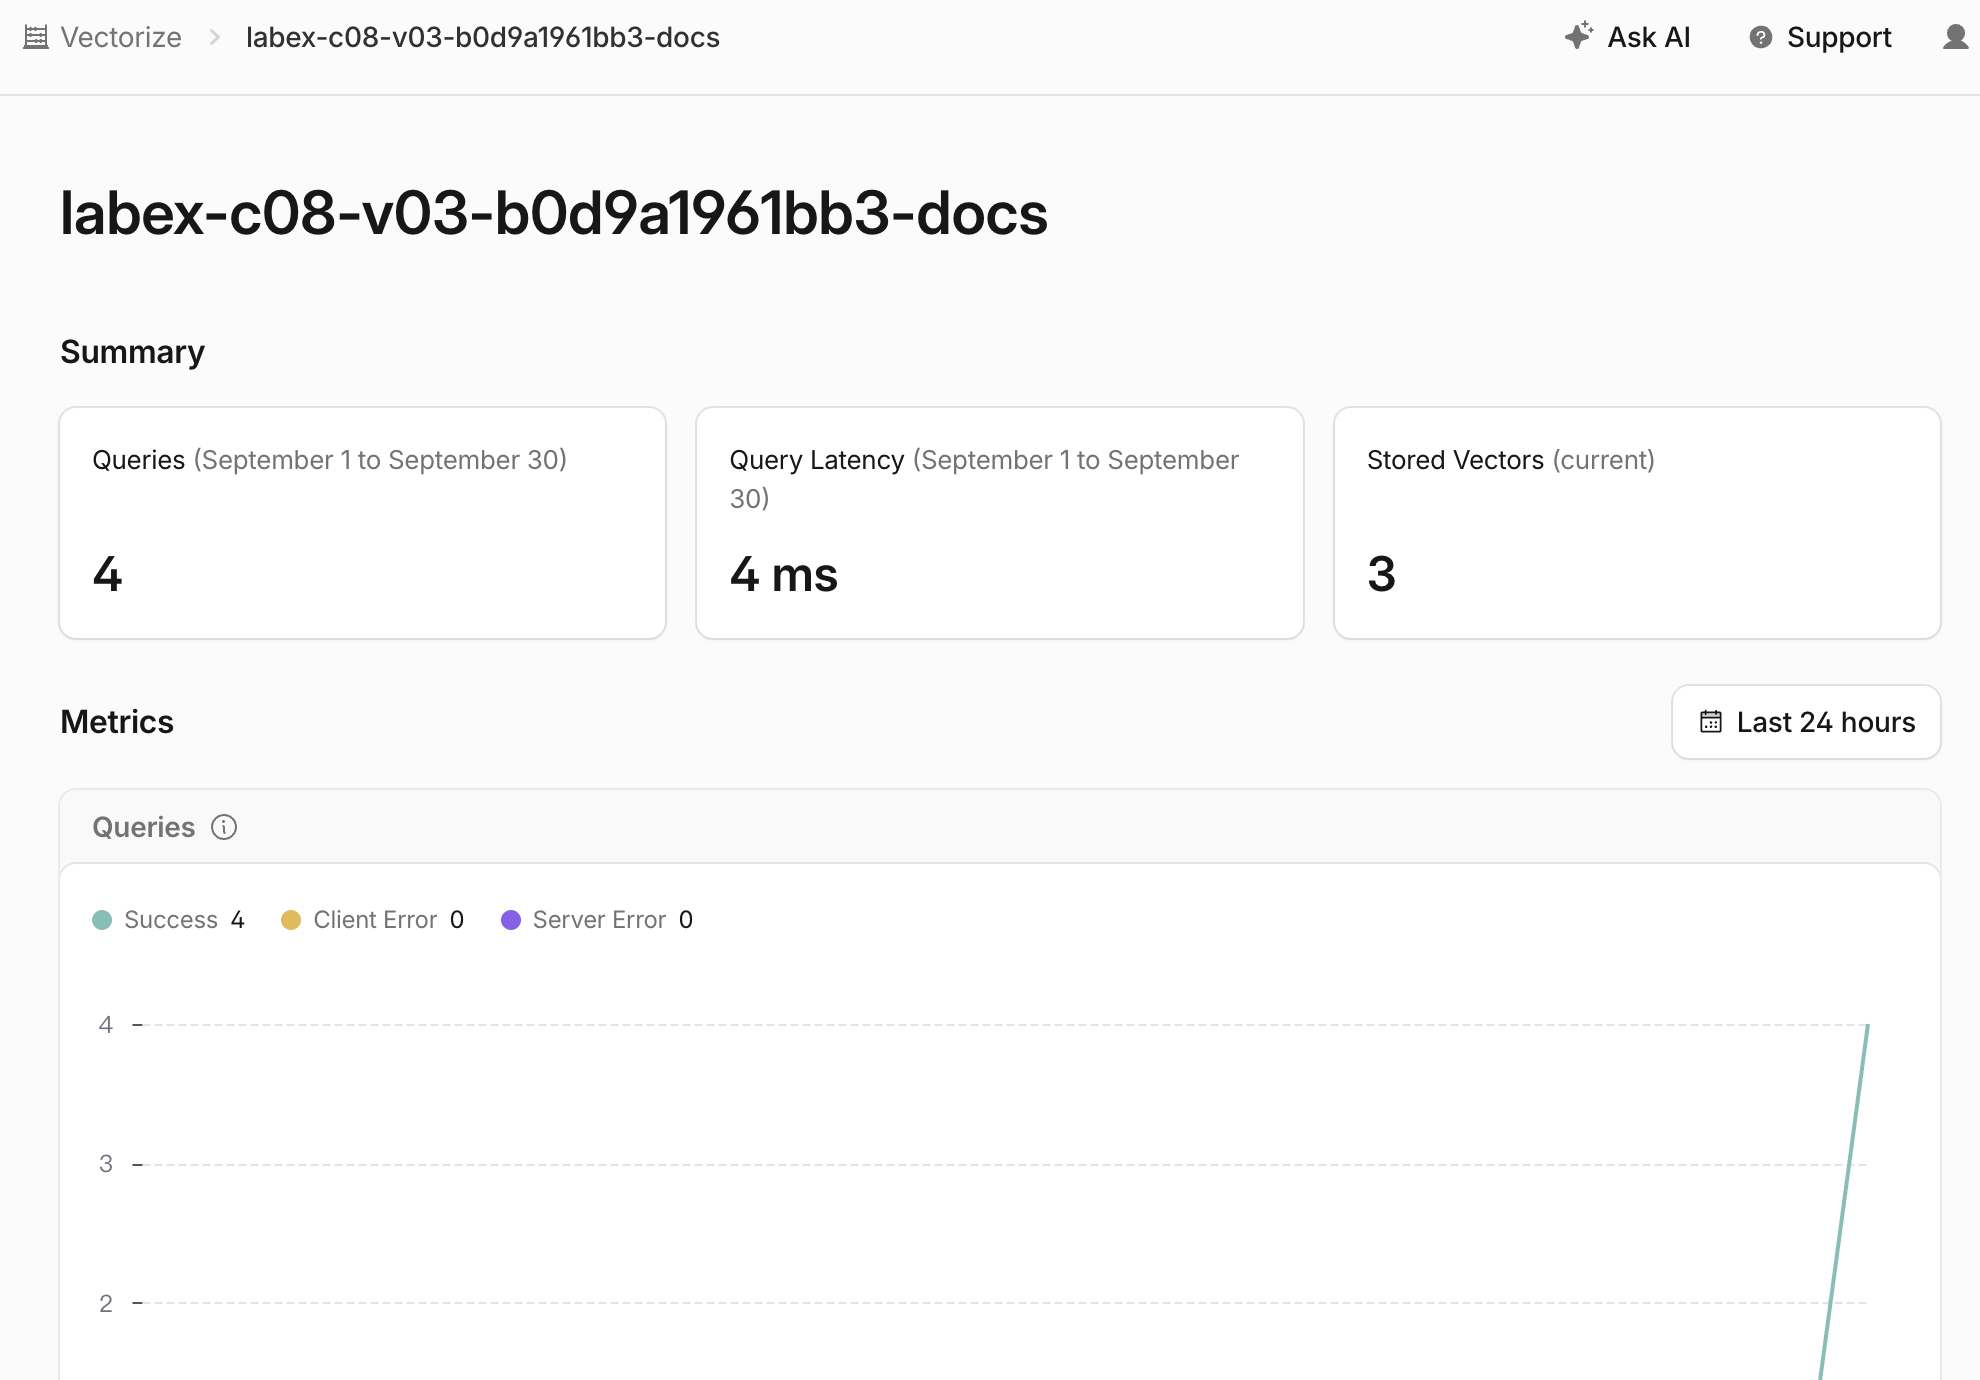
Después, abra AI → Vectorize → el índice -docs correspondiente. El resumen debe mostrar tres vectores actuales: uno por cada artículo de ayuda que sembró. El total de consultas puede diferir del ejemplo porque cada búsqueda correcta añade otra consulta, incluidas las comprobaciones repetidas.
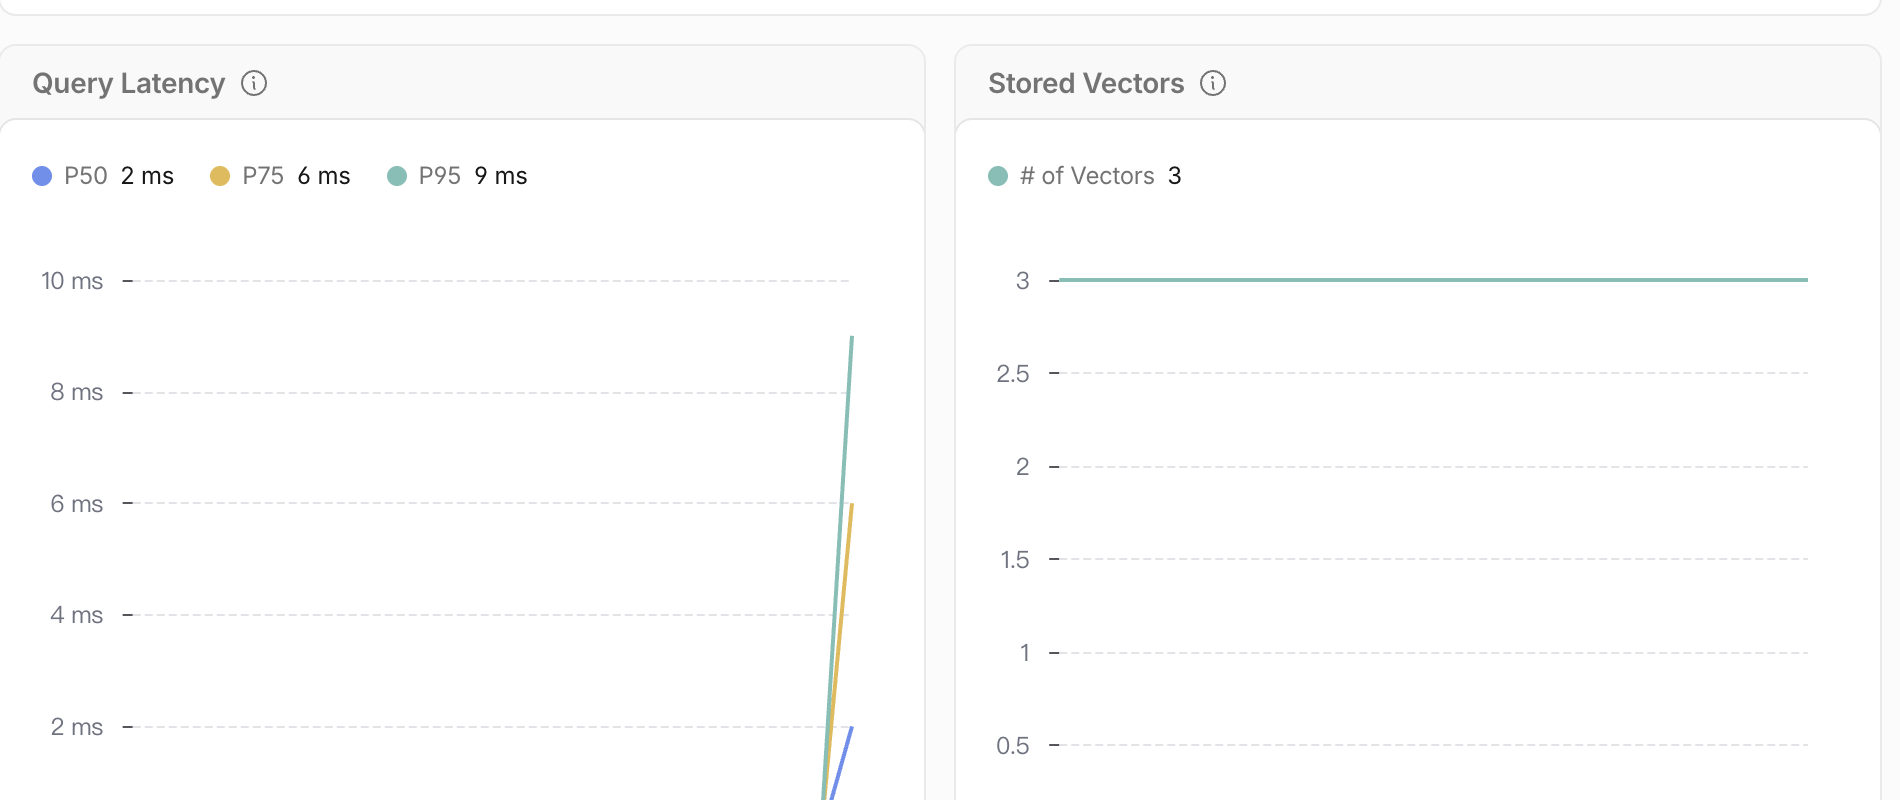
Desplácese hasta Metrics. P50, P75 y P95 son percentiles de latencia: por ejemplo, P95 significa que el 95 % de las consultas correctas terminó en ese tiempo o menos. Estas cifras describen la velocidad, no la relevancia de una coincidencia. El gráfico Stored Vectors debe mantenerse en tres mientras solo realice búsquedas y no añada ni elimine documentos.
Los contadores del Dashboard pueden tardar unos instantes en reflejar lo que aparece en la terminal. Considere las respuestas de la API, los ID devueltos y las comprobaciones independientes como el resultado autoritativo; utilice el Dashboard para relacionar esos resultados con los recursos que puede ver y administrar.
Elimine el Worker y el índice de búsqueda
En este paso eliminará ambos recursos desechables en la nube y demostrará que ya no existen mientras Wrangler siga autorizado. Cerrar sesión es un paso final separado porque la comprobación de limpieza necesita acceso de lectura a Cloudflare.
Primero, recupere los nombres exactos de wrangler.jsonc. Esto hace que la limpieza sea segura incluso si abrió otra terminal y las variables RUN e INDEX anteriores ya no existen:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Confirme que ambos valores comienzan con su prefijo único labex-c08-v03-... antes de eliminar cualquier elemento.
Elimine primero el Worker para que ningún código implementado conserve un binding al índice:
npx wrangler delete --name "$RUN" --force
Elimine únicamente el índice asociado y, después, guarde un inventario autenticado correcto para la evaluación de limpieza:
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Complete el paso ahora, antes de cerrar sesión. La evaluación lee Cloudflare de forma independiente y no acepta un fallo de autenticación o de red como prueba de eliminación.
Cierre la sesión de la máquina virtual de aprendizaje
En este paso eliminará la autorización temporal de Wrangler de esta máquina virtual. Los recursos en la nube ya se eliminaron y la comprobación de limpieza autenticada se realizó correctamente, así que ahora puede cerrar sesión:
npx wrangler logout
npx wrangler whoami --json
Debe aparecer loggedIn: false. La sesión del navegador en el Dashboard de Cloudflare es independiente y seguirá disponible para su cuenta de aprendizaje.
Resumen
Construyó un Worker que utiliza un mismo contrato de modelo para los embeddings de documentos almacenados y los embeddings de consultas en vivo, sembró tres ID estables en Vectorize y esperó a que la mutación asíncrona real estuviera disponible. Utilizó topK para limitar los candidatos, interpretó las puntuaciones como señales de clasificación relativa, devolvió metadatos en lugar de vectores sin procesar y generó un resultado vacío explícito después de aplicar un umbral en la aplicación. Por último, confirmó ambos bindings en el Dashboard, eliminó el Worker y el índice desechables mientras seguía autorizado y después cerró sesión en la máquina virtual.
V04 añadirá espacios de nombres de clientes controlados por el servidor y filtros de metadatos, de modo que un registro semánticamente similar solo se devuelva cuando también pertenezca al ámbito de búsqueda autorizado.