Introducción
En V01 se almacenó un vector para cada artículo de ayuda. Los artículos reales no permanecen sin cambios: las instrucciones se modifican, los títulos se corrigen y las páginas obsoletas se retiran. Un índice de búsqueda debe seguir ese ciclo de vida; de lo contrario, puede devolver respuestas desactualizadas aunque el sitio web de origen sea correcto.
Cloudflare Vectorize proporciona tres operaciones de escritura relacionadas:
- insert agrega un nuevo ID de vector y no debería reemplazar silenciosamente uno existente;
- upsert significa «actualizar o insertar» y reemplaza el vector y los metadatos de ese ID;
- delete by ID retira registros seleccionados sin reconstruir todo el índice.
Usted cargará tres documentos sintéticos, reemplazará mediante upsert un artículo revisado sobre contraseñas, eliminará un artículo retirado sobre facturación y demostrará que el artículo no relacionado sobre cargas nunca cambia. Cada escritura devuelve un ID de mutación asíncrona, por lo que esperará hasta alcanzar el estado exacto en lugar de asumir que una escritura aceptada ya se puede leer.
Este es el segundo laboratorio sobre Vectorize. Si accedió directamente, complete primero Conectar LabEx con su cuenta de Cloudflare y, después, V01 para familiarizarse con la compatibilidad del índice, los ID de documentos y la visibilidad de las mutaciones.
Vectorize está disponible en Workers Free. En este laboratorio se almacenan como máximo tres vectores pequeños de 384 dimensiones, se ejecutan lecturas acotadas y no se invoca ningún modelo de IA; por tanto, no se requieren Workers Paid ni Workers AI Neurons.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 local para el proyecto en /home/labex/project/document-lifecycle-index. Proporciona comprobaciones independientes de solo lectura, pero no autoriza Wrangler, no crea un índice, no escribe vectores ni modifica su cuenta de Cloudflare.
Autorizar un índice nuevo para el ciclo de vida de documentos
En este paso, autorizará la nueva VM, registrará la cuenta prevista y creará una configuración local única para un índice desechable.
Acceda al proyecto preparado y confirme la versión fijada de la CLI:
cd /home/labex/project/document-lifecycle-index
npx wrangler --version
Debe aparecer 4.132.0. Autorice la misma cuenta limitada y el mismo acceso al recurso de Workers que utilizó en V01:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
npx wrangler whoami --json
Confirme que aparece loggedIn: true, identifique su cuenta de aprendizaje y genere un nombre único:
RUN="labex-c08-v02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Reemplace YOUR_ACCOUNT_ID por el ID real de esa cuenta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
El nuevo índice es independiente de V01. Reutilizar los conocimientos no significa depender de la VM ni del recurso en la nube de un laboratorio anterior.
Cargar el conjunto actual de documentos
En este paso, creará el índice e insertará los tres registros que representan el centro de ayuda actual antes de realizar cualquier modificación o retiro.
Cree el mismo contrato de 384 dimensiones y métrica coseno que utiliza el modelo de embeddings BGE Small:
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Cree un mecanismo de espera reutilizable y acotado. Tres lecturas coincidentes protegen el resultado visible para el estudiante frente a una réplica que todavía pueda estar temporalmente desactualizada:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
Genere tres vectores de documentos deterministas. El campo revision permite reconocer fácilmente un reemplazo posterior; el objeto completo de metadatos representa la información que necesitaría la aplicación de búsqueda después de actualizar el origen.
cat > scripts/create-seed.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const documents = [
  { id: "password-reset", axis: 0, category: "account", title: "Reset your password" },
  { id: "upload-pdf", axis: 1, category: "files", title: "Upload a PDF" },
  { id: "billing-receipt", axis: 2, category: "billing", title: "Download a billing receipt" }
];

const rows = documents.map((document) => {
  const values = Array(DIMENSIONS).fill(0);
  values[document.axis] = 1;
  return {
    id: document.id,
    values,
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      revision: 1,
      model: "@cf/baai/bge-small-en-v1.5",
      pooling: "cls"
    }
  };
});

writeFileSync("vectors/seed.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`prepared ${rows.length} current documents`);
JS
node scripts/create-seed.mjs
Inserte únicamente IDs nuevos, conserve todo el resultado y espere a que la mutación se procese realmente:
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/seed.ndjson 2>&1 | tee .labex/seed-output.txt
Continúe solo cuando Wrangler indique que hay tres vectores en cola y muestre un ID de mutación. Un error de autenticación o de red no permite concluir nada; corríjalo antes de esperar.
SEED_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/seed-output.txt | tail -n 1)
if [ -z "$SEED_MUTATION_ID" ]; then
  printf '%s\n' 'No seed mutation ID was returned; fix the insert error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$SEED_MUTATION_ID" 3
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
El inventario debe contener los tres IDs estables de la aplicación. insert es adecuado en este caso porque son nuevos; en el siguiente paso reemplazará deliberadamente un ID existente.
Actualizar el artículo sobre contraseñas mediante upsert
En este paso, reemplazará el vector y los metadatos de password-reset sin modificar su ID estable.
Un upsert inserta un ID inexistente o reemplaza un ID existente. Reemplazar resulta útil cuando cambia un documento de origen, pero también significa que debe enviar todos los metadatos deseados. No debe asumir que los campos omitidos en el nuevo registro se conservarán.
Genere la revisión 2 con otro eje determinista y un título actualizado, conservando todos los campos de metadatos que siguen siendo válidos:
cat > scripts/create-update.mjs <<'JS'
import { writeFileSync } from "node:fs";

const values = Array(384).fill(0);
values[3] = 1;
const updated = {
  id: "password-reset",
  values,
  metadata: {
    category: "account",
    published: true,
    title: "Reset an expired password",
    revision: 2,
    model: "@cf/baai/bge-small-en-v1.5",
    pooling: "cls"
  }
};

writeFileSync("vectors/password-update.ndjson", JSON.stringify(updated) + "\n");
console.log("prepared password-reset revision 2");
JS
node scripts/create-update.mjs
Envíe el reemplazo y conserve su mutación exacta:
set -o pipefail
npx wrangler vectorize upsert "$RUN" --file=vectors/password-update.ndjson 2>&1 | tee .labex/upsert-output.txt
UPSERT_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/upsert-output.txt | tail -n 1)
if [ -z "$UPSERT_MUTATION_ID" ]; then
  printf '%s\n' 'No upsert mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$UPSERT_MUTATION_ID" 3
fi
npx wrangler vectorize get-vectors "$RUN" --ids password-reset > .labex/password-after-upsert.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/password-after-upsert.txt", "utf8");
const [row] = JSON.parse(text.slice(text.indexOf("[")));
console.table([{ id: row.id, dimensions: row.values.length, changedAxis: row.values[3], title: row.metadata.title, revision: row.metadata.revision }]);
JS
Debe obtener el mismo ID, 384 dimensiones, el eje 3 igual a 1, el título revisado y la revisión 2. El recuento total sigue siendo tres porque upsert reemplazó una identidad en lugar de agregar un cuarto documento.
Retirar un documento sin reconstruir el índice
En este paso, eliminará por su ID estable el artículo de facturación retirado y demostrará que el artículo actualizado sobre contraseñas y el artículo intacto sobre cargas permanecen.
Eliminar por ID es más específico que eliminar un índice completo: el contrato del índice y todos los registros no relacionados permanecen en su lugar. Envíe únicamente el ID retirado:
set -o pipefail
npx wrangler vectorize delete-vectors "$RUN" --ids billing-receipt 2>&1 | tee .labex/delete-output.txt
Espere a que se procese la mutación de eliminación y a que el recuento sea dos:
DELETE_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/delete-output.txt | tail -n 1)
if [ -z "$DELETE_MUTATION_ID" ]; then
  printf '%s\n' 'No delete mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$DELETE_MUTATION_ID" 2
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/documents-after-retirement.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/documents-after-retirement.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map((row) => ({ id: row.id, title: row.metadata.title, revision: row.metadata.revision })));
JS
Solo deben permanecer password-reset con la revisión 2 y upload-pdf con la revisión 1. La ausencia de billing-receipt es significativa porque la misma lectura autenticada también devolvió los dos registros que debían conservarse.
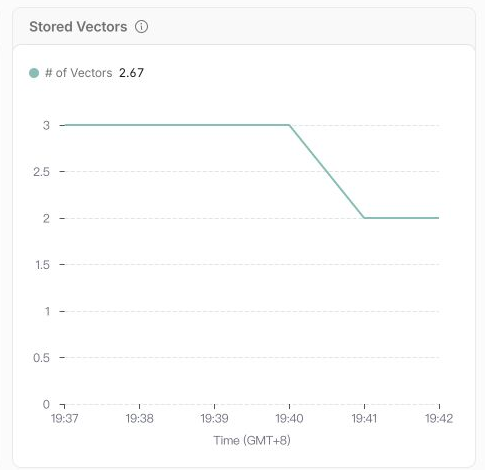
Abra la cuenta seleccionada en el Cloudflare Dashboard y vaya a AI → Vectorize; después, abra el índice cuyo nombre aparece en $RUN. Confirme que el resumen muestra dos vectores almacenados. En el gráfico Stored Vectors, relacione el ciclo de vida visible con los comandos: el recuento sube a tres después de la mutación de carga inicial y baja a dos después de la eliminación específica. El Dashboard no muestra qué ID se eliminó, por lo que las lecturas de Wrangler y de la API independiente siguen siendo la evidencia autorizada de las identidades.
El resumen muestra el estado actual de un vistazo: después de retirar un registro, todavía se pueden buscar dos documentos.
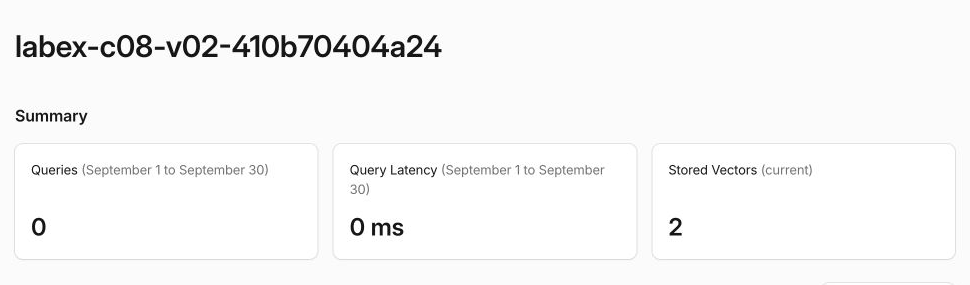
El gráfico convierte el ciclo de vida en una imagen. Su promedio puede mostrar brevemente un número decimal porque la línea abarca varias muestras de un minuto; lo importante es la transición visible de tres vectores almacenados a dos.
Eliminar el índice del ciclo de vida y cerrar sesión
En este paso, eliminará el índice desechable completo solo después de demostrar el ciclo de vida específico del documento.
En el paso anterior, eliminar un vector conservó el índice. Este comando final elimina deliberadamente todo el recurso del laboratorio:
npx wrangler vectorize delete "$RUN" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Complete la comprobación de limpieza del laboratorio mientras el inventario autenticado correcto todavía esté disponible. Mantenga Wrangler autorizado hasta que la comprobación termine correctamente, porque cerrar sesión antes haría que un error de autenticación no pudiera distinguirse de una eliminación correcta.
Después, elimine la autorización de esta VM e inspeccione el resultado estructurado:
npx wrangler logout
npx wrangler whoami --json
Debe aparecer loggedIn: false. La sesión independiente del navegador del Dashboard seguirá disponible para su cuenta de aprendizaje.
Resumen
Comenzó con tres IDs de documentos actuales, utilizó upsert para reemplazar el vector y los metadatos completos de un artículo revisado y usó una eliminación específica para retirar un artículo obsoleto. Los IDs exactos de mutación y las lecturas consecutivas acotadas permitieron distinguir entre escrituras aceptadas y estados que ya se podían leer.
También demostró las dos propiedades de seguridad importantes en una canalización de indexación real: una actualización no creó una identidad duplicada y un retiro no eliminó documentos no relacionados. Por último, relacionó el estado de dos registros con el Dashboard, eliminó el índice desechable, confirmó su ausencia mediante una comprobación autenticada y cerró sesión en la nueva VM.
En V03 generará un embedding de consulta en vivo con el mismo contrato del modelo y utilizará el índice mantenido para recuperar artículos de ayuda similares.