Introducción
Una respuesta de IA escrita para una persona puede variar en la forma de expresarse sin causar problemas. El código de una aplicación necesita algo más estricto. Por ejemplo, un servicio de enrutamiento de tickets necesita campos con nombres como category y priority, cuyos valores pertenezcan a un conjunto conocido. La salida estructurada solicita al modelo datos legibles por máquinas en lugar de prosa libre.
En este laboratorio utilizará JSON Mode con un JSON Schema. JSON es el formato de los datos. El esquema es un contrato que describe qué campos son obligatorios, qué tipos de valores están permitidos y si se prohíben los campos inesperados. Pedir al modelo que siga un esquema mejora la estructura de su respuesta, pero no constituye un límite de confianza: la salida del modelo sigue siendo un dato externo y puede estar incompleta, tener un formato incorrecto o ser incompatible con la aplicación.
Creará POST /extract. El Worker enviará un pequeño ticket de soporte sintético a un modelo Llama alojado en Cloudflare y solicitará cuatro campos: una categoría, una prioridad, un resumen breve y una decisión de seguimiento. Después, Ajv comprobará de forma independiente el mismo esquema antes de que el Worker devuelva un registro aceptado. Los fixtures deterministas inyectarán resultados incorrectos del modelo para que pueda demostrar que los datos no válidos siguen una ruta de error en lugar de entrar en la respuesta aceptada.
Este es el tercer laboratorio del curso. Se da por hecho que sabe que un Cloudflare Worker gestiona solicitudes HTTP y que el binding AI expone Workers AI como env.AI. Si accedió directamente a este laboratorio, complete primero Conectar LabEx con su cuenta de Cloudflare para aprender a usar la terminal de la VM, autorizar Wrangler, confirmar su cuenta de aprendizaje y guardar su ID de cuenta.
El laboratorio utiliza @cf/meta/llama-3.3-70b-instruct-fp8-fast, que admite JSON Mode, y mantiene pequeños todos los prompts y resultados. Actualmente, las cuentas de Workers Free reciben una asignación diaria compartida de 10.000 Neurons, por lo que no se necesita Workers Paid mientras quede asignación gratuita en la cuenta. La inferencia local sigue llegando a Cloudflare y consume esa asignación. Si el modelo o la asignación no están disponibles, deténgase en lugar de enviar solicitudes repetidas.
La configuración instala Node.js 22.22.0, Wrangler 4.132.0 local del proyecto y Ajv 8.17.1 en /home/labex/project/ticket-fields. También proporciona pruebas deterministas y comprobaciones independientes. La configuración no inicia sesión, no invoca un modelo, no implementa un Worker ni crea recursos en la nube. Mantenga abierta esta VM hasta eliminar el Worker temporal y comprobar que ha cerrado la sesión.
Autorizar la VM y configurar el Worker de extracción
En este paso autorizará esta VM nueva y configurará un Worker temporal. El inicio de sesión en el Dashboard pertenece al navegador; Wrangler, en una VM nueva, necesita su propia autorización limitada antes de poder administrar la cuenta de aprendizaje.
Entre en el proyecto preparado y confirme la versión fijada de Wrangler:
cd /home/labex/project/ticket-fields
npx wrangler --version
Debe aparecer 4.132.0. Solicite los mismos permisos limitados que se utilizaron en los laboratorios anteriores de Workers AI. Wrangler 4.132.0 comprueba las dependencias de KV al eliminar un Worker, por lo que workers_kv:write evita un error de limpieza no relacionado, aunque este laboratorio no crea datos de KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra el enlace mostrado, introduzca el código actual del dispositivo, revise la cuenta y los permisos, y autorice la cuenta de aprendizaje. Vuelva a la terminal e inspeccione los datos estructurados de identidad:
npx wrangler whoami --json
Confirme loggedIn: true y lea name e id de la cuenta prevista. Genere un nombre único para el Worker temporal:
RUN="labex-c07-a03-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Sustituya YOUR_ACCOUNT_ID por el ID real de esa cuenta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
El binding AI estará disponible como env.AI. remote: true significa que el proceso local del Worker seguirá llamando al modelo real asociado a la cuenta. Observability guardará los pequeños eventos del ciclo de vida que inspeccionará después de la implementación. Todavía no se ha realizado ninguna inferencia ni implementación.
Leer el contrato de salida estructurada
En este paso inspeccionará las dos capas que protegen la aplicación. JSON Mode envía un esquema junto con la solicitud al modelo. Ajv comprueba el valor devuelto con ese esquema dentro del Worker. La primera capa orienta la generación; la segunda decide si el valor se puede aceptar de forma segura.
Genere los tipos del entorno del Worker:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Busque AI: Ai. Es un binding proporcionado por la plataforma, no una clave de API del modelo guardada en el código fuente.
El registro tendrá cuatro campos:
category: billing | account | upload | other
priority: low | medium | high
summary: nonempty text, at most 160 characters
needs_follow_up: true or false
En JSON Schema, type controla el tipo de valor, enum limita un valor a una lista conocida, required indica los campos que deben existir y additionalProperties: false rechaza los campos inesperados. Esta última regla es importante porque, de lo contrario, un campo inventado podría pasar inadvertido. El esquema describe la estructura, no si la interpretación del modelo es objetivamente correcta; una persona o una regla de negocio posterior aún puede revisar los campos aceptados.
Inspeccione los fixtures con formato incorrecto proporcionados para la prueba determinista:
grep -nE 'security|priority: 1|internal_note|not-an-object' test/worker.test.mjs
Estos fixtures no consumen Neurons. Permiten probar de forma fiable casos que no deberían generarse deliberadamente mediante prompts reales repetidos.
Crear el endpoint de extracción validada
En este paso implementará el esquema, la solicitud al modelo y la validación del lado de la aplicación. Solo la rama que supera Ajv devuelve un record.
Cree el punto de entrada del Worker:
cat > src/index.js <<'JS'
import Ajv from "ajv";

const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_TICKET = 1200;

export const TICKET_SCHEMA = {
  type: "object",
  properties: {
    category: { type: "string", enum: ["billing", "account", "upload", "other"] },
    priority: { type: "string", enum: ["low", "medium", "high"] },
    summary: { type: "string", minLength: 1, maxLength: 160 },
    needs_follow_up: { type: "boolean" }
  },
  required: ["category", "priority", "summary", "needs_follow_up"],
  additionalProperties: false
};

const ajv = new Ajv({ allErrors: true });
const isTicketRecord = ajv.compile(TICKET_SCHEMA);

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readTicket(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const ticket = typeof body?.ticket === "string" ? body.ticket.trim() : "";
  if (!ticket) return { error: json({ error: "invalid_ticket" }, 400) };
  if (ticket.length > MAX_TICKET) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }
  return { ticket };
}

async function extractTicket(request, env) {
  const parsed = await readTicket(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };

  let result;
  try {
    result = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Extract support-ticket fields. Use only evidence in the ticket. Keep the summary short and do not add fields."
        },
        { role: "user", content: parsed.ticket }
      ],
      response_format: {
        type: "json_schema",
        json_schema: TICKET_SCHEMA
      },
      max_tokens: 160,
      temperature: 0
    });
  } catch {
    console.error(JSON.stringify({ event: "ticket_extraction_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }

  const candidate = result?.response;
  if (!isTicketRecord(candidate)) {
    console.error(JSON.stringify({ event: "ticket_output_rejected", ...details }));
    return json({ error: "invalid_model_output", requestId }, 502);
  }

  console.log(JSON.stringify({ event: "ticket_output_accepted", ...details }));
  return json({ record: candidate, requestId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/extract") {
      return extractTicket(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
El Worker nunca registra el ticket ni los campos devueltos. El ID de solicitud relaciona la respuesta del cliente con un evento de ciclo de vida aceptado, rechazado o fallido sin copiar el contenido de soporte en los datos de observabilidad. Los detalles de error de Ajv tampoco aparecen en la respuesta al cliente, porque podrían revelar el diseño interno de validación; los clientes reciben el contrato estable invalid_model_output.
Ejecute las pruebas deterministas:
node --test test/worker.test.mjs
Debe obtener cinco pruebas aprobadas. Una prueba inyecta siete candidatos con formato incorrecto mediante un binding de IA simulado y exige que ninguna respuesta incluya record. Después, cree el bundle del Worker real sin implementarlo:
npx wrangler deploy --dry-run
Los fixtures demuestran el comportamiento de rechazo sin depender de una salida variable del modelo. La ejecución en seco demuestra que el código fuente, la dependencia Ajv y la configuración del Worker se agrupan correctamente. En el siguiente paso realizará una inferencia estructurada real.
Ejecutar un resultado estructurado real
En este paso ejecutará el Worker desde la VM y realizará una solicitud real mediante JSON Mode. “Local” describe el controlador de solicitudes; el binding de IA sigue utilizando la cuenta de Cloudflare seleccionada y consume parte de su asignación diaria.
Inicie Wrangler en segundo plano y guarde su ID de proceso:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Espere a que esté disponible la ruta de comprobación que no usa IA:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Envíe un ticket sintético claro:
curl --silent --show-error http://127.0.0.1:8787/extract \
  --header 'Content-Type: application/json' \
  --data '{"ticket":"Customer cannot upload a PDF and needs help before today’s deadline."}'
Debe recibir una respuesta JSON con record y requestId. La categoría, la prioridad, el texto exacto del resumen y la decisión de seguimiento pueden variar. La evidencia importante es que el registro contiene exactamente cuatro campos y que cada valor cumple el esquema.
Ahora demuestre que una solicitud no válida de la aplicación se rechaza antes de llamar al modelo:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/extract \
  --header 'Content-Type: application/json' \
  --data '{"ticket":""}'
Debe obtener {"error":"invalid_ticket"} y HTTP 400. La validación de entrada protege la llamada al modelo; la validación de salida protege el registro de la aplicación. Son límites independientes.
Implementar e inspeccionar la salida aceptada
En este paso implementará el mismo endpoint validado y relacionará su estado visible en el Dashboard con el resultado de ejecución. Primero detenga únicamente el proceso de desarrollo guardado:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Implemente el Worker:
npx wrangler deploy
Guarde la URL exacta de workers.dev que muestre Wrangler:
WORKER_URL="https://YOUR_WORKER_URL"
Envíe una solicitud pública limitada:
curl --silent --show-error "$WORKER_URL/extract" \
  --header 'Content-Type: application/json' \
  --data '{"ticket":"Customer cannot upload a PDF and needs help before today’s deadline."}'
Confirme que la respuesta pública vuelve a contener exactamente los campos del esquema dentro de record. Un estado HTTP correcto por sí solo no es suficiente; la comprobación independiente también valida cada campo devuelto y el binding AI implementado.
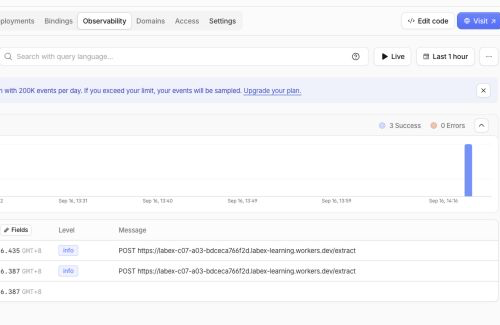
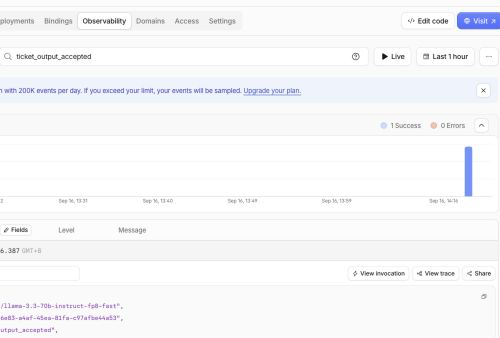
Abra el Cloudflare Dashboard y vaya a Workers & Pages → Overview → su Worker labex-c07-a03-.... Inspeccione su binding y, después, abra Observability → Logs. Busque ticket_output_accepted, expanda el evento y confirme su model, requestId y nombre del evento. El registro excluye deliberadamente el ticket y el registro extraído.
La vista del binding que aparece a continuación corresponde a una ejecución de depuración temporal. Tanto el diagrama como la tabla relacionan el nombre AI con Workers AI, que es la representación visible en el Dashboard de env.AI dentro del Worker. El nombre único de su Worker será diferente.
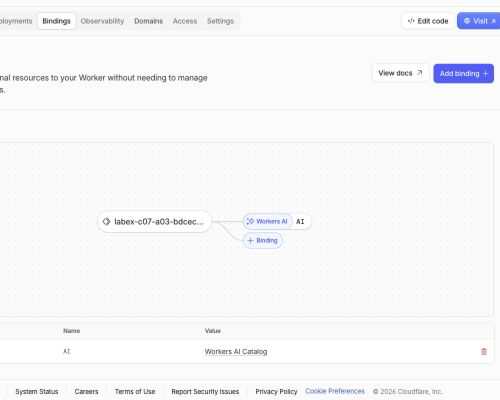
La misma ejecución registró 3 Success y 0 Errors después de la solicitud pública y las comprobaciones independientes. Estos totales son ejemplos y no son cantidades obligatorias. La relación importante es que el Worker seleccionado gestionó correctamente las solicitudes visibles a /extract.
Después de filtrar por ticket_output_accepted, el evento de aplicación expandido muestra el modelo Llama exacto, un ID de solicitud y el nombre del evento aceptado. No contiene el ticket sintético ni el registro extraído. Esto confirma el límite de privacidad, pero no debe considerarse una prueba de que la validación del esquema se completó correctamente; la respuesta de ejecución y la comprobación independiente proporcionan esa prueba.
Después, abra Workers AI e inspeccione el uso de modelos de hoy. Busque el modelo Llama 3.3 y confirme que las ejecuciones limitadas siguen dentro de la asignación de 10.000 Neurons de Workers Free. La información del Dashboard puede tardar en aparecer, así que espere brevemente en lugar de repetir la inferencia solo para forzar la actualización de un gráfico o registro.
La cuenta del ejemplo mostró 261.63/10k Neurons para el modelo Llama. Ese total incluye ejercicios anteriores de producción del curso realizados en la misma cuenta de aprendizaje, por lo que no representa únicamente el coste de este laboratorio y su valor será diferente. El punto de comprobación es mantenerse dentro de la asignación Free, no igualar el número del ejemplo.
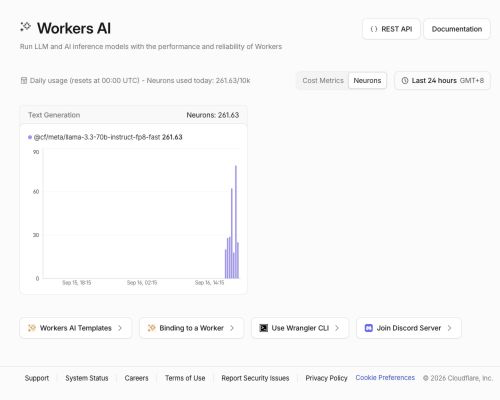
Los valores del Dashboard corresponden a esta ejecución temporal. Los objetivos didácticos son la identidad exacta del Worker, su binding de IA, un evento aceptado con privacidad limitada y el uso de la asignación Free. Si una vista del Dashboard se retrasa, las comprobaciones de la CLI, la API y el tiempo de ejecución siguen siendo la referencia principal.
Eliminar el Worker y cerrar la sesión
En este paso eliminará el Worker temporal y después quitará la autorización de esta VM. El uso de Workers AI forma parte del historial de la cuenta, por lo que eliminar el Worker elimina su endpoint, pero no borra el registro de uso ni cambia el plan de la cuenta.
Elimine exactamente el Worker cuyo nombre aparece en wrangler.jsonc:
npx wrangler delete
Confirme únicamente cuando Wrangler muestre el nombre único de este laboratorio, labex-c07-a03-.... El comando debe terminar con Successfully deleted. Actualice Workers & Pages → Overview y confirme que ese nombre exacto ya no aparece.
Mientras la VM siga autorizada, ejecute la comprobación de administración independiente:
python3 .labex/verify.py deleted
Solo después de que informe PASS: deleted, elimine la autorización almacenada de la VM:
npx wrangler logout
npx wrangler whoami --json
Debe obtener loggedIn: false. La ausencia de un archivo local, cerrar una pestaña del navegador o un error de red no demostraría que se eliminó el recurso en la nube ni que se cerró la sesión.
Resumen
Creó un endpoint de Workers AI que solicita campos estructurados de tickets mediante JSON Mode y un JSON Schema. Aprendió por qué solicitar una estructura no equivale a obtener datos confiables, utilizó Ajv como límite independiente de la aplicación y demostró con fixtures con formato incorrecto que una salida no válida del modelo nunca se convierte en un registro aceptado. Ejecutó un resultado real, tanto local como implementado, en Workers Free, relacionó el evento aceptado con la observabilidad del Dashboard, eliminó el Worker temporal y cerró la sesión de la VM nueva.