Introducción
En el laboratorio anterior sobre embeddings de Workers AI, el texto se convirtió en un embedding: una lista ordenada de números que captura relaciones útiles entre significados. Un embedding no es el artículo original ni una respuesta generada. Solo resulta útil para las búsquedas cuando una aplicación puede almacenarlo con un ID de documento estable y, más adelante, encontrar vectores cercanos.
Cloudflare Vectorize es una base de datos vectorial. A diferencia de una tabla diseñada alrededor de filas y columnas, un índice vectorial está diseñado para comparar vectores numéricos de forma eficiente. Cada índice establece dos opciones de compatibilidad al crearse:
- dimensions: cuántos números contiene cada vector;
- distance metric: cómo determina Vectorize qué vectores están más cerca.
Creará un índice de 384 dimensiones para los embeddings @cf/baai/bge-small-en-v1.5 alojados en Cloudflare y elegirá la distancia coseno, la misma comparación basada en la dirección que se presentó en A04. Agregará índices de metadatos para category y published, insertará tres vectores sintéticos pequeños de artículos de ayuda, esperará a que la mutación asíncrona pueda leerse y confirmará que se rechaza un vector de tres dimensiones.
Este es el primer laboratorio del curso de Vectorize. Si accedió directamente, complete primero Conectar LabEx a su cuenta de Cloudflare para aprender a usar el terminal de la máquina virtual de LabEx, autorizar Wrangler, confirmar su cuenta de aprendizaje y configurar su ID de cuenta. Complete primero Workers AI A04 si los vectores, las dimensiones o la similitud coseno no le resultan familiares.
Vectorize está disponible en Workers Free. La cuota incluida actual es muy superior a los tres vectores de 384 dimensiones y a las comprobaciones de solo lectura de este laboratorio, por lo que no necesita Workers Paid. Este laboratorio no invoca Workers AI ni consume Neurons.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0, instalado localmente en el proyecto, en /home/labex/project/document-vector-index. También proporciona comprobaciones independientes de solo lectura. La configuración no autoriza Wrangler, no crea un índice, no escribe vectores ni modifica su cuenta de Cloudflare.
Autorizar la máquina virtual y asignar un nombre al índice
En este paso, autorizará la máquina virtual recién creada, seleccionará la cuenta de aprendizaje prevista y registrará un nombre de índice único y temporal.
El inicio de sesión en Cloudflare Dashboard pertenece a su navegador. Wrangler, en esta máquina virtual nueva, es un cliente independiente, por lo que necesita una autorización limitada antes de poder administrar recursos de Vectorize.
Acceda al proyecto preparado y confirme la versión fijada de la CLI:
cd /home/labex/project/document-vector-index
npx wrangler --version
Debe aparecer 4.132.0. Solicite la identidad de la cuenta y permisos para administrar recursos de Workers. En esta versión de Wrangler, el alcance OAuth workers:write incluye las operaciones de administración de Vectorize utilizadas aquí; el laboratorio no solicita un alcance de AI porque no realiza inferencias.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
Abra el enlace mostrado, introduzca el código actual, revise la cuenta y los permisos, y autorice su cuenta de aprendizaje. Después, consulte los datos estructurados de identidad:
npx wrangler whoami --json
Confirme loggedIn: true e identifique la cuenta de aprendizaje prevista. Genere un nombre de índice único y temporal:
RUN="labex-c08-v01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Reemplace YOUR_ACCOUNT_ID por el ID real de esa cuenta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
El binding registra la relación que utilizarán los próximos laboratorios desde el código de Worker: DOCUMENTS es el nombre que usa la aplicación, mientras que index_name es el recurso en la nube que le pertenece. remote: true indica que un Worker local se conectaría al índice remoto real en lugar de usar una simulación local aislada.
Crear el índice y sus campos filtrables
En este paso, creará el contrato fijo del vector y preparará dos campos de metadatos para filtrarlos más adelante.
Las dimensiones y la métrica de distancia de un índice son fijas porque todas las comparaciones deben seguir el mismo contrato numérico. BGE Small produce 384 números. La distancia coseno compara la dirección de los vectores, lo que resulta adecuado para los embeddings orientados al significado de A04.
Cree el índice V2:
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Los vectores también pueden incluir metadatos pequeños, como la categoría de un documento. Almacenar metadatos no los hace filtrables automáticamente. Un índice de metadatos indica a Vectorize qué campo debe preparar para los filtros. Cree estos campos antes de insertar los vectores:
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=category --type=string | tee .labex/category-index-output.txt
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=published --type=boolean | tee .labex/published-index-output.txt
--update-config=false impide que Wrangler le ofrezca reemplazar el binding que ya escribió. La creación de índices de metadatos es asíncrona. Cada comando pone en cola una mutación, por lo que un mensaje de éxito significa que Cloudflare aceptó el cambio, no que todas las lecturas ya puedan verlo.
Cree un comprobador reutilizable. Este ejecuta únicamente el comando de solo lectura vectorize info, compara el ID exacto de la mutación y exige tres lecturas consecutivas coincidentes antes de confiar en el resultado. Esta confirmación adicional evita presentar una réplica de lectura momentáneamente obsoleta como estado final. El comprobador se detiene con un error después de cuatro minutos, en lugar de esperar indefinidamente:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS

METADATA_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/published-index-output.txt | tail -n 1)
test -n "$METADATA_MUTATION_ID"
node scripts/wait-for-vectorize.mjs "$RUN" "$METADATA_MUTATION_ID" 0
npx wrangler vectorize get "$RUN"
npx wrangler vectorize list-metadata-index "$RUN"
Las tablas finales deben mostrar 384 dimensiones, distancia coseno, category como String y published como Bool. Bool es el nombre de visualización actual de la API para el campo creado con --type=boolean. Esperar a la segunda mutación de metadatos evita que la próxima inserción de vectores quede pendiente mientras termina la preparación del índice.
Crear vectores de documentos identificados
En este paso, generará un conjunto pequeño y transparente de vectores cuyos ID y metadatos se pueden comprobar de forma independiente.
Una base de datos vectorial no sustituye al documento de origen. Cada vector necesita un ID estable que la aplicación pueda relacionar con el contenido real. En este laboratorio se utilizan tres ID sintéticos de artículos de ayuda, y sus metadatos registran la categoría, el estado de publicación, el modelo de embedding y la opción de pooling.
Los embeddings reales se generarán en V03. Aquí, los vectores deterministas hacen que el comportamiento de almacenamiento sea repetible y gratuito: cada documento apunta a un eje distinto, seguido de ceros hasta alcanzar 384 posiciones.
Cree el generador transparente del conjunto de prueba:
cat > scripts/create-vectors.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const documents = [
  { id: "password-reset", axis: 0, category: "account" },
  { id: "upload-pdf", axis: 1, category: "files" },
  { id: "billing-receipt", axis: 2, category: "billing" }
];

function unitVector(axis) {
  const values = Array(DIMENSIONS).fill(0);
  values[axis] = 1;
  return values;
}

const rows = documents.map((document) => ({
  id: document.id,
  values: unitVector(document.axis),
  metadata: {
    category: document.category,
    published: true,
    model: MODEL,
    pooling: POOLING
  }
}));

writeFileSync("vectors/documents.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`wrote ${rows.length} vectors with ${DIMENSIONS} dimensions each`);
JS
node scripts/create-vectors.mjs
NDJSON significa JSON delimitado por saltos de línea: un objeto vectorial completo por línea, en lugar de un único arreglo JSON envolvente. Wrangler puede transmitir este formato en lotes. Inspeccione las identidades y las formas sin mostrar los 1.152 números:
node - <<'JS'
const rows = require("fs").readFileSync("vectors/documents.ndjson", "utf8").trim().split("\n").map(JSON.parse);
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Las tres filas deben indicar 384 dimensiones. Los metadatos del modelo y de cls documentan la compatibilidad; Vectorize no infiere ni valida por usted ese significado semántico.
Insertar los vectores y esperar a que se procese su mutación
En este paso, insertará un lote y esperará hasta que su mutación asíncrona exacta sea visible para las lecturas.
Las escrituras de Vectorize son asíncronas. Una inserción llega primero a un registro de escritura anticipada duradero y devuelve un ID de mutación. Después, el procesamiento en segundo plano hace que esa mutación sea visible para las lecturas. Este diseño mantiene la eficiencia de las escrituras, pero significa que «aceptada» y «legible» son dos momentos distintos.
Inserte el lote de tres vectores y conserve el resultado completo. pipefail evita que un error de Wrangler quede oculto por el comando tee, que se ejecuta correctamente después:
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/documents.ndjson 2>&1 | tee .labex/insert-output.txt
Continúe solo después de que Wrangler indique que puso en cola tres vectores y muestre un identificador de mutación. Si la API devuelve un error de autenticación o de red, el resultado no es concluyente: confirme npx wrangler whoami --json y vuelva a ejecutar este mismo bloque de inserción una vez. No inicie el comprobador sin un ID de mutación real.
Extraiga la mutación aceptada y espere únicamente cuando exista:
MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/insert-output.txt | tail -n 1)
if [ -z "$MUTATION_ID" ]; then
  printf '%s\n' 'No mutation ID was returned; fix the insert error before waiting.' >&2
else
  printf 'Waiting for mutation %s\n' "$MUTATION_ID"
  node scripts/wait-for-vectorize.mjs "$RUN" "$MUTATION_ID" 3
fi
El JSON final del comprobador debe mostrar vectorCount con el valor 3 y el ID de mutación registrado. Exigir tres lecturas coincidentes hace que el resultado visible para el estudiante sea resistente a un retraso breve de las réplicas. El sondeo con un límite de tiempo es más seguro que una espera fija: una mutación rápida termina pronto, mientras que una mutación saludable pero más lenta dispone de tiempo sin generar escrituras duplicadas.
Leer los documentos y probar la compatibilidad
En este paso, leerá los registros aceptados, observará el rechazo de una escritura incompatible y relacionará el estado de la CLI con el Dashboard.
Lea los registros almacenados mediante sus ID de aplicación:
Guarde los registros completos y, después, imprima una tabla compacta en lugar de llenar el terminal con 1.152 números:
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/stored-vectors.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/stored-vectors.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Cada fila resumida debe conservar su ID, su estructura de 384 valores y sus metadatos. El archivo sin resumir contiene todos los valores para realizar comprobaciones independientes. get-vectors lee registros conocidos; no realiza una búsqueda por similitud. Las consultas de similitud comienzan en V03.
Ahora cree intencionadamente un registro incompatible que solo tenga tres valores:
cat > vectors/incompatible.ndjson <<'NDJSON'
{"id":"wrong-dimensions","values":[1,0,0],"metadata":{"category":"account","published":true}}
NDJSON
if npx wrangler vectorize insert "$RUN" --file=vectors/incompatible.ndjson > .labex/incompatible.log 2>&1; then
  STATUS=0
else
  STATUS=$?
fi
printf '%s\n' "$STATUS" > .labex/incompatible-exit.txt
sed -n '/invalid vector/p' .labex/incompatible.log
test "$STATUS" -ne 0
El rechazo protege el contrato del índice: un vector de tres posiciones no se puede comparar de forma significativa con vectores de 384 posiciones. Confirme que los registros aceptados permanecen y que el ID rechazado no aparece:
npx wrangler vectorize info "$RUN"
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids wrong-dimensions
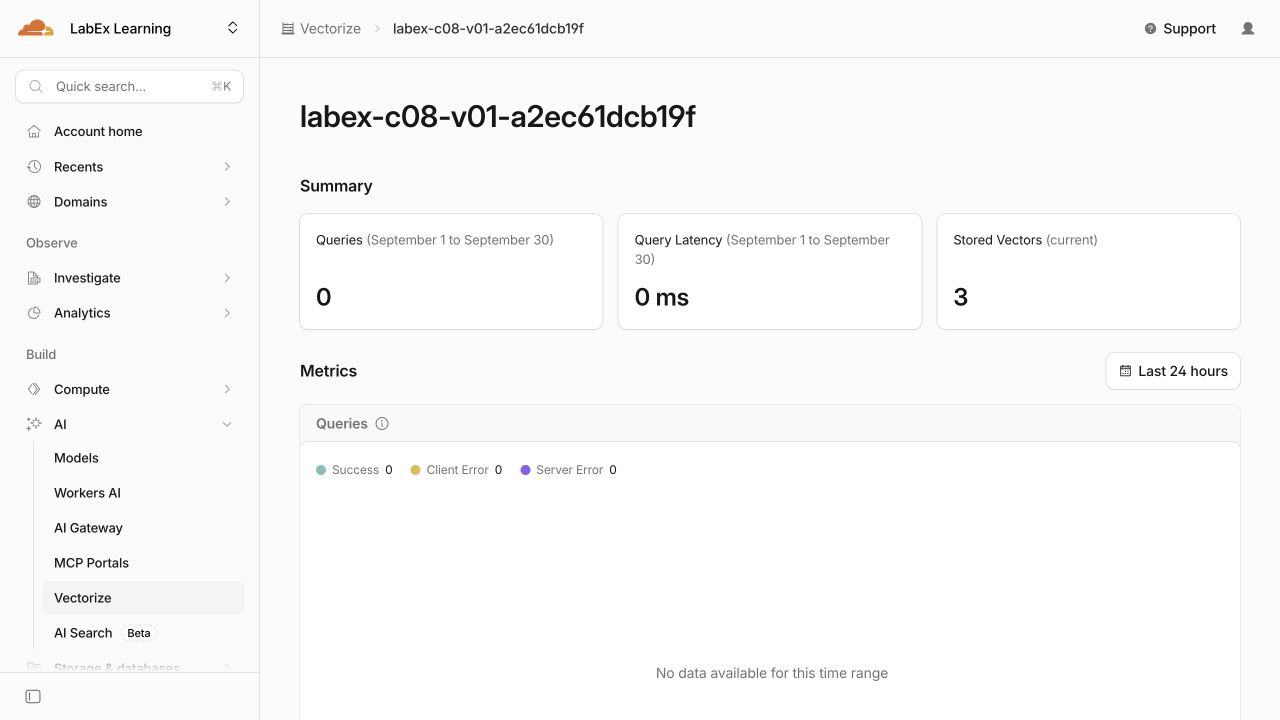
Abra Cloudflare Dashboard para la cuenta seleccionada y vaya a AI → Vectorize. El inventario relaciona el nombre de la CLI con el índice real, muestra 384 dimensiones y distancia coseno, y registra tres vectores en total sin uso facturable en este ejemplo pequeño.
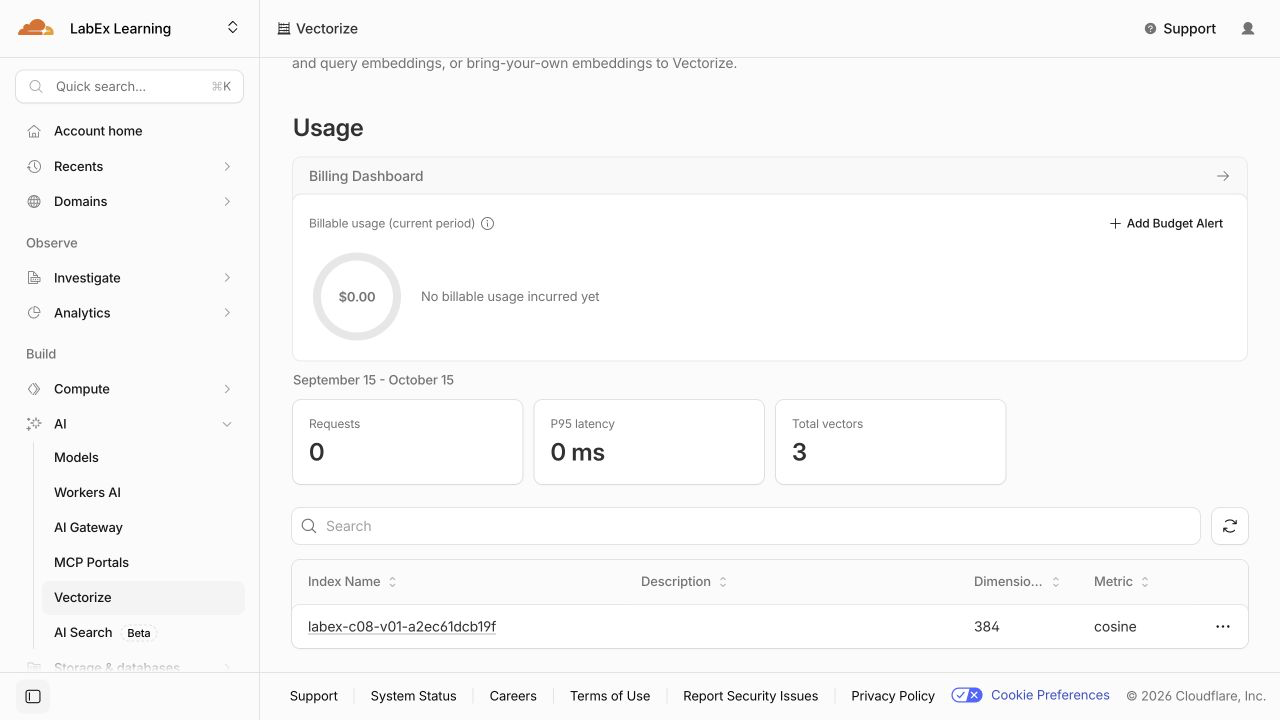
Abra el índice cuyo nombre aparece en $RUN. Su resumen muestra tres vectores almacenados actualmente. Las consultas siguen en cero porque este primer laboratorio utiliza lecturas por ID; las consultas de similitud comienzan en V03.
Desplácese hasta Stored Vectors. El gráfico hace visible el comportamiento asíncrono: el recuento permanece en cero y después cambia a tres cuando se procesa la mutación de inserción.
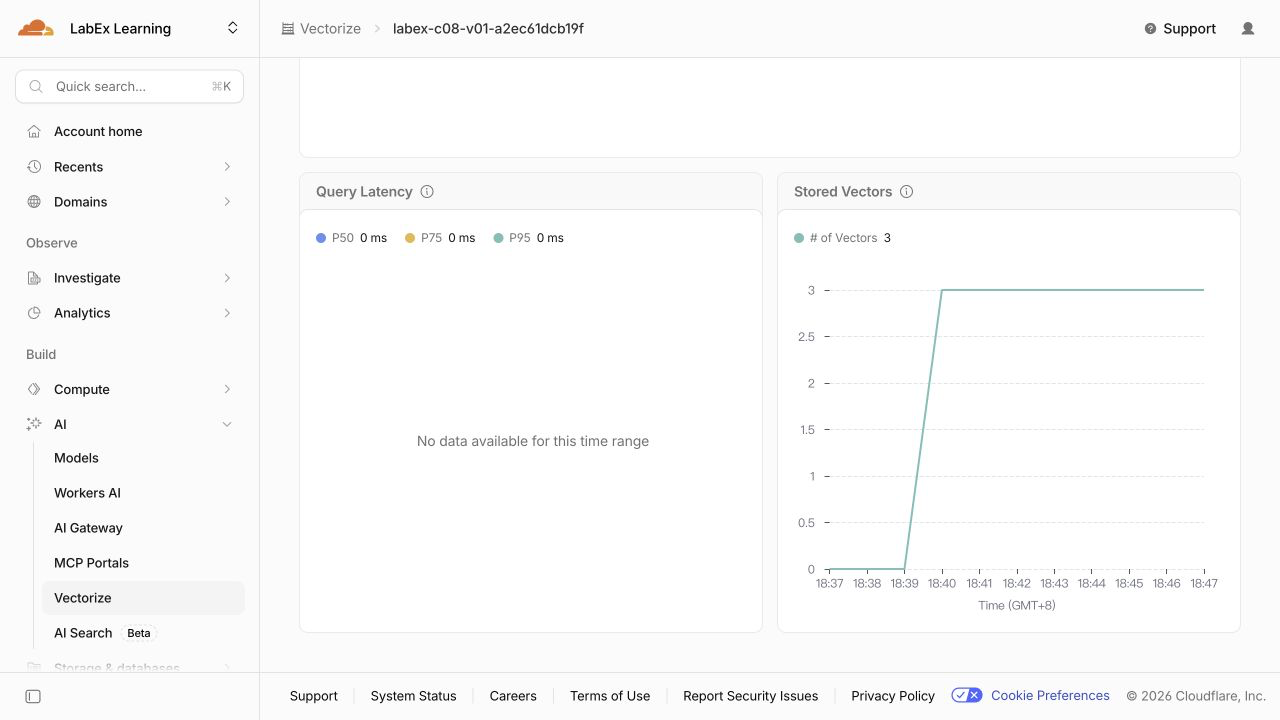
El Dashboard actual no muestra los ID individuales de los vectores ni las definiciones de los índices de metadatos. Utilice las lecturas anteriores de Wrangler para password-reset, upload-pdf, billing-receipt, category y published; no deduzca esos detalles a partir de un gráfico que solo muestra el recuento. Las páginas del Dashboard ayudan a orientarse, mientras que las comprobaciones independientes utilizan lecturas autorizadas de la API.
Las capturas de pantalla mostradas aquí después de la aceptación en la nube del laboratorio son ejemplos de una ejecución temporal. El nombre aleatorio de su índice y las marcas de tiempo serán diferentes; compare la configuración y los ID que le pertenecen en lugar de copiar los valores de ejemplo.
Eliminar el índice temporal y cerrar sesión
En este paso, eliminará el índice exacto que le pertenece, demostrará su ausencia mediante una consulta autenticada y, después, quitará la autorización de la máquina virtual.
El índice, sus índices de metadatos y sus vectores forman un único recurso temporal. Elimine el nombre exacto guardado en wrangler.jsonc mientras la autorización siga disponible:
npx wrangler vectorize delete "$RUN" --force
Confirme su ausencia mediante una lectura autenticada del inventario:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Este inventario correcto es importante: un error de red o de autorización no demostraría que la eliminación se realizó. Ejecute la evaluación de limpieza antes de revocar la autorización de la máquina virtual:
bash verify6-1.sh
Por último, elimine el inicio de sesión de Wrangler de la máquina virtual e inspeccione el resultado estructurado:
npx wrangler logout
npx wrangler whoami --json
Debe aparecer loggedIn: false. El inicio de sesión del navegador en Dashboard es independiente y seguirá disponible para su cuenta de aprendizaje.
Resumen
Creó un índice Vectorize V2 con el mismo contrato de 384 dimensiones que el modelo de embeddings seleccionado, eligió la distancia coseno y preparó dos campos de metadatos para filtros posteriores. Generó vectores deterministas identificados, los insertó como NDJSON, distinguió entre una mutación asíncrona aceptada y una mutación procesada, y volvió a leer los registros almacenados mediante su ID.
También comprobó que Vectorize rechaza un vector con dimensiones incorrectas mientras conserva los registros compatibles. Por último, inspeccionó el recurso real en el Dashboard, eliminó el índice temporal exacto, confirmó su ausencia mediante autenticación y eliminó la autorización de Wrangler de la máquina virtual recién creada.
El próximo laboratorio ampliará este ciclo de vida con upsert y la eliminación, para que los documentos modificados y retirados no dejen el índice obsoleto.