Introducción
V03 convertía las preguntas en embeddings y recuperaba artículos de ayuda cercanos. V04 mantenía esos resultados dentro de los límites de cliente y categoría controlados por el servidor. La recuperación es útil por sí sola, pero muchas aplicaciones de soporte necesitan un paso más: convertir los pasajes aprobados en una respuesta breve en lenguaje natural.
Este patrón se denomina generación aumentada por recuperación, normalmente abreviado como RAG. Primero, la aplicación recupera la evidencia, crea un contexto pequeño únicamente con esos registros y después pide a un modelo de lenguaje que responda a partir de ese contexto. La recuperación no hace que un modelo sea automáticamente veraz. La aplicación todavía debe controlar qué fuentes son válidas, limitar cuánto texto entra en el prompt, conservar las identidades de las fuentes y detenerse cuando no existe evidencia aprobada.
Creará un Worker desechable con dos bindings de Cloudflare. DOCUMENTS busca en un índice de Vectorize, mientras que AI ejecuta tanto el modelo de embeddings BGE Small como un modelo de generación de texto Llama alojado por Cloudflare. El Worker resuelve los ID de vectores devueltos mediante un corpus incluido en el código; los metadatos de los vectores son útiles para buscar, pero no se consideran el cuerpo canónico del artículo.
El endpoint devolverá un arreglo sources controlado por la aplicación junto a la respuesta generada. Si la recuperación no encuentra nada dentro del namespace y la categoría seleccionados, devolverá una respuesta fija no_evidence sin llamar al modelo de generación de texto. Esta rama explícita es más segura que pedirle a un modelo que improvise.
Si accedió directamente a este curso, complete primero Conectar LabEx a su cuenta de Cloudflare. V01–V04 son requisitos previos: presentan los índices compatibles, las mutaciones asíncronas, la recuperación semántica y el alcance controlado por el servidor.
Este laboratorio utiliza el modelo alojado por Cloudflare @cf/meta/llama-3.3-70b-instruct-fp8-fast porque ya se ha probado en Workers Free en el curso anterior de Workers AI. DeepSeek V4 Flash está alojado por Cloudflare, pero actualmente requiere acceso de pago, por lo que no es una dependencia obligatoria para el estudiante. El laboratorio solo envía solicitudes limitadas de embeddings y generación; Workers Paid no es necesario mientras siga disponible la asignación gratuita compartida de Workers AI de la cuenta.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 local al proyecto en /home/labex/project/grounded-answer. Proporciona pruebas deterministas y comprobaciones independientes de solo lectura, pero no autoriza Wrangler, crea un índice, implementa un Worker, ejecuta inferencias ni carga datos en la nube.
Autorizar y nombrar los recursos de RAG
En este paso autorizará esta VM nueva, confirmará la cuenta de aprendizaje y definirá un Worker y un índice de Vectorize emparejados antes de crear cualquier recurso.
Acceda al proyecto preparado e inspeccione las herramientas fijadas:
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Debería ver Node.js v22.22.0 y Wrangler 4.132.0. Iniciar sesión en el Dashboard desde el navegador no autoriza automáticamente esta VM, por lo que debe utilizar el flujo de dispositivo de Wrangler con los permisos necesarios para consultar la identidad de la cuenta y usar el Worker desechable, Vectorize y Workers AI:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Abra el enlace de autorización mostrado, confirme que el código coincide y apruebe la cuenta LabEx Learning prevista. No envíe el código, la contraseña ni el token a nadie. En el resultado JSON, confirme loggedIn: true y anote el nombre y el ID de la cuenta.
Genere un sufijo aleatorio. Ambos nombres de recursos lo compartirán para que la limpieza posterior pueda identificar exactamente el par:
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Cree wrangler.jsonc. Un here-document envía al archivo el bloque situado entre las marcas JSON; $RUN y $INDEX se expanden con los nombres únicos de esta VM. Sustituya YOUR_ACCOUNT_ID por el ID mostrado por whoami:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
AI es un solo binding, aunque el código llamará a dos modelos a través de él. DOCUMENTS apunta al índice emparejado. El archivo define los recursos previstos, pero todavía no crea ninguno.
Crear el Worker de recuperación y generación
En este paso implementará la secuencia RAG completa y comprobará sus decisiones con bindings deterministas en memoria antes de utilizar la cuota de la nube.
El CORPUS proporcionado es el mapa canónico de ID a texto. Vectorize almacena embeddings y metadatos que se pueden buscar; después de una consulta, el Worker solo acepta los ID que se resuelven mediante este mapa. A continuación, incluye como máximo dos pasajes en el prompt. Así evita que un registro inesperado del índice se convierta en contexto del modelo simplemente porque obtuvo una puntuación alta.
Cree el código fuente del Worker:
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Observe el orden de answer(): valida el alcance controlado por el servidor, genera el embedding de la pregunta, recupera como máximo dos coincidencias válidas, resuelve cada ID mediante CORPUS, crea un contexto limitado y, finalmente, genera la respuesta. La respuesta pública omite el texto completo del contexto y los valores de los vectores, pero conserva referencias resolubles a las fuentes.
Ejecute la suite determinista:
node --test test/worker.test.mjs
Debería obtener siete pruebas aprobadas. Los bindings simulados demuestran que los ID desconocidos y una recuperación vacía nunca llegan a la generación de texto. Genere los tipos de bindings y empaquete el proyecto sin implementarlo:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
Los tipos generados deben incluir AI: Ai y DOCUMENTS: VectorizeIndex. Una ejecución de prueba confirma que los archivos se pueden empaquetar juntos; no crea recursos en la nube ni ejecuta ninguno de los dos modelos.
Crear el índice preparado e implementar el Worker
En este paso creará un índice de Vectorize compatible, preparará category para el filtrado e implementará el Worker después de que esa preparación se estabilice.
Cree el índice de 384 dimensiones con similitud coseno que utiliza BGE Small. --update-config=false evita que Wrangler reescriba el binding explícito que ya revisó:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Cree el índice de metadatos de tipo string para category y guarde el ID de mutación devuelto. set -o pipefail hace que la canalización falle si Wrangler falla, aunque tee también escriba una copia de la salida:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Una mutación aceptada se pone en cola. Cree un script de espera limitado que requiera la mutación exacta y el número de vectores durante tres lecturas consecutivas:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
La vista de lista independiente puede tardar en reflejar el estado de la mutación procesada, así que espere brevemente hasta que su fila también sea visible:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Finalmente, implemente el Worker y guarde su URL pública:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
El índice todavía está vacío. La implementación conecta los bindings, pero no crea embeddings ni registros de fuentes automáticamente.
Cargar el corpus de fuentes aprobadas
En este paso creará embeddings activos para los tres artículos proporcionados y esperará hasta que todos los ID de fuente se puedan leer.
El texto de las fuentes permanece en CORPUS; los registros de vectores contienen el embedding compatible y pequeños metadatos de búsqueda. Esta separación permite que la aplicación resuelva un ID en el cuerpo de un artículo aprobado, en lugar de confiar en texto arbitrario copiado de los metadatos del vector.
Llame una vez al endpoint de carga fijo:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
Debería obtener tres registros, 384 dimensiones, pooling cls y un UUID de mutación. Espere hasta ese estado exacto y, después, espere brevemente hasta que los tres ID aparezcan en la vista de inventario independiente:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
Ahora cada ID conecta los resultados de búsqueda con una entrada exacta del corpus. El índice no contiene deliberadamente ningún artículo de files, lo que hará observable la rama de ausencia de evidencia sin depender de un umbral de similitud.
Comparar las respuestas fundamentadas y de ausencia de evidencia
En este paso enviará una pregunta admitida y otra cuya categoría autorizada no tiene fuentes. El contraste hará visible el flujo de control de RAG.
Pregunte cómo restablecer una contraseña caducada dentro del alcance de la cuenta blue:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
Debería obtener mode: grounded, generated: true, una respuesta no vacía y un arreglo sources encabezado por password-reset. El texto generado por su modelo puede ser diferente. La evidencia estable es que cada ID, título y URL devuelto se resuelve mediante el corpus proporcionado y que solo se incluyeron en el prompt pasajes aprobados de la categoría account.
Ahora pregunte cómo cargar un archivo, manteniendo el mismo alcance de cliente controlado por el servidor. files es una categoría permitida, pero este corpus no contiene ningún registro de archivos válido:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
Debería obtener mode: no_evidence, generated: false, el mensaje fijo I don't have enough approved evidence to answer that question. y sources: []. El Worker aun así generó el embedding de la pregunta para buscar, pero omitió la generación de texto porque no había contexto aprobado.
Pruebe una solicitud insegura que proporcione su propio namespace:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
Debería obtener HTTP 400 y scope_override_not_allowed. RAG no sustituye el límite de autorización aprendido en V04; la recuperación debe ser segura antes de que su texto se convierta en contexto del modelo.
Abra Workers & Pages → su Worker labex-c08-v05-... → Bindings. Confirme que AI apunta a Workers AI y que DOCUMENTS apunta al índice emparejado de Vectorize. Esta vista conecta los dos nombres de servicio del código con los recursos administrados reales.
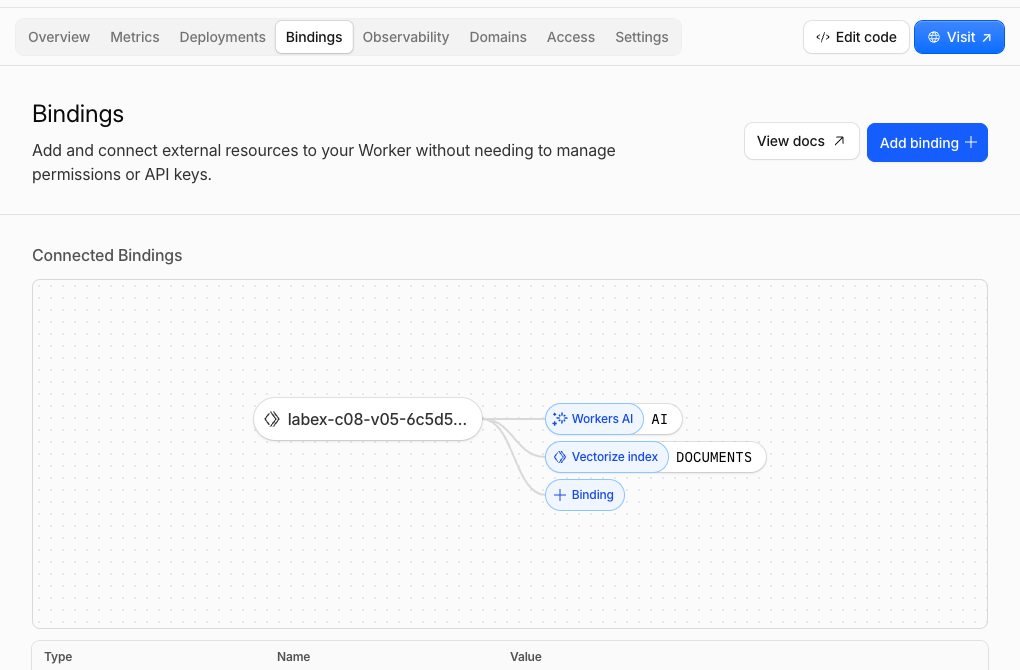
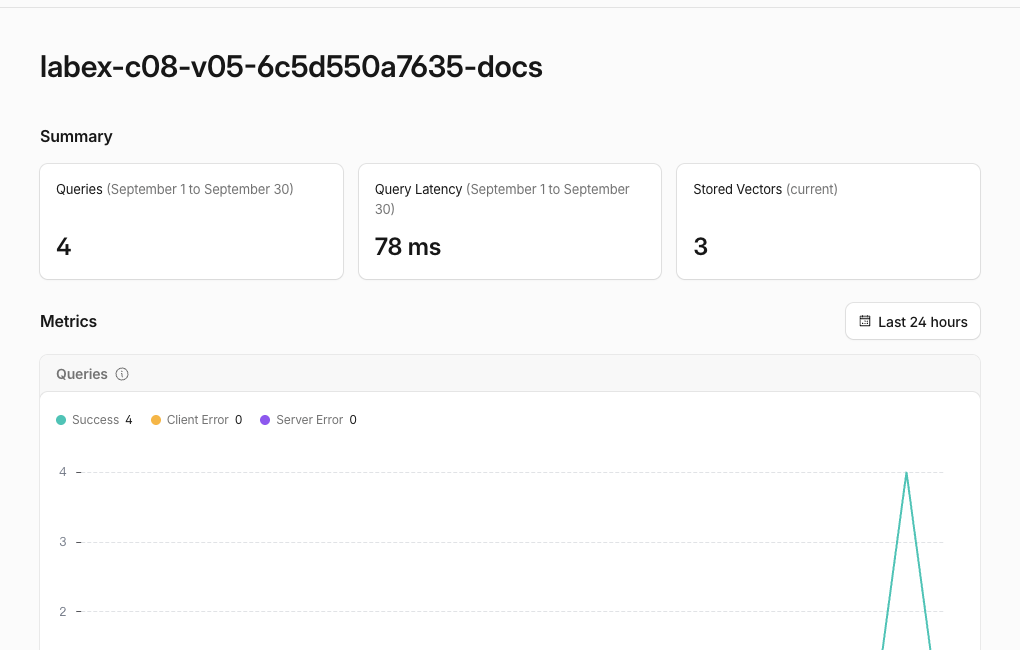
Después, abra AI → Vectorize → el índice -docs correspondiente. El recuento actual debería mostrar finalmente tres vectores, y la actividad de consultas debería reflejar las búsquedas con evidencia y sin evidencia. Las métricas del Dashboard pueden tardar en actualizarse, por lo que las lecturas autenticadas de los ID y las respuestas del endpoint siguen siendo la fuente de verdad.
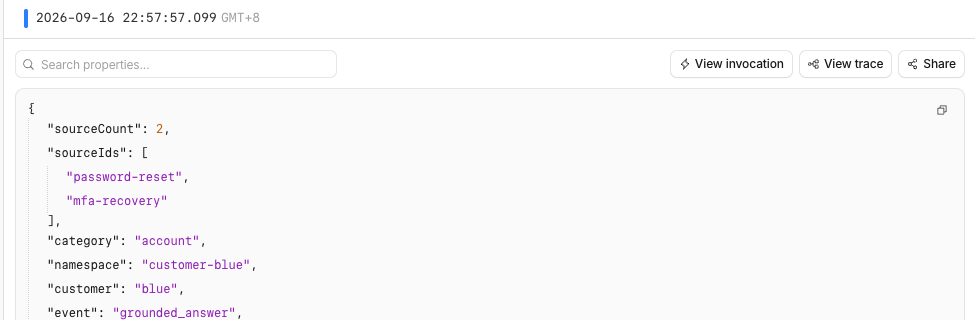
Si Workers Logs está disponible, abra Observability → Logs e inspeccione las entradas grounded_answer y grounded_no_evidence. Los registros incluyen la categoría, los ID de las fuentes y los recuentos, pero omiten la pregunta, la respuesta, el texto de los pasajes, la etiqueta de sesión y los valores de los vectores. Esto proporciona a los operadores evidencia útil del flujo de control sin copiar el prompt en los registros.
Eliminar los recursos de respuestas fundamentadas
En este paso eliminará el Worker desechable y el índice de Vectorize y, después, demostrará que ya no existen mientras Wrangler todavía está autorizado.
Recupere ambos nombres exactos desde wrangler.jsonc para que la limpieza no dependa de variables de una sesión de terminal anterior:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Confirme que ambos valores utilizan el prefijo único labex-c08-v05-.... Elimine primero el Worker para que ningún código implementado conserve el binding y, después, elimine únicamente su índice emparejado:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Guarde un inventario autenticado correcto de los índices y compruebe que el nombre exacto está ausente:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Complete esta comprobación antes de cerrar la sesión. Un error de red o de autorización no es concluyente; la evaluación requiere de forma independiente lecturas correctas de la cuenta y la ausencia del nombre exacto.
Cerrar la sesión de la VM de aprendizaje
En este paso eliminará la autorización temporal de Wrangler de esta VM. Los recursos de la nube ya no existen y la comprobación de limpieza autenticada se ha completado correctamente:
npx wrangler logout
npx wrangler whoami --json
Debería obtener loggedIn: false. La sesión del navegador en Cloudflare Dashboard es independiente y seguirá disponible para su cuenta de aprendizaje.
Resumen
Creó un endpoint pequeño de generación aumentada por recuperación: el alcance controlado por el servidor limitó la búsqueda de Vectorize, los ID devueltos se resolvieron mediante un corpus aprobado, como máximo dos pasajes se convirtieron en contexto del modelo y la aplicación devolvió referencias estables a las fuentes junto a un texto generado variable.
También demostró que una búsqueda válida sin resultados toma una rama fija de ausencia de evidencia sin generar texto, rechazó las modificaciones del alcance proporcionadas por el cliente antes de la recuperación, inspeccionó las relaciones entre el Worker, Vectorize y la observabilidad limitada por privacidad, eliminó ambos recursos desechables mientras tenía autorización y, finalmente, cerró la sesión. El desafío del curso le pedirá reparar un endpoint defectuoso que infringe el mismo límite de alcance.