



Introducción
La aplicación envía lecturas y escrituras al mismo primario. Crearás una réplica PostgreSQL, dirigirás las consultas a ella y demostrarás que recibe las nuevas escrituras del primario, mientras rechaza escrituras directas.
Esta es una extensión opcional después de los laboratorios de conexión, SQL y recuperación. El entorno empieza de forma independiente con un primario y tres pedidos de ejemplo. Eliminarás la réplica y el primario al final.
Relación con certificaciones
Este laboratorio ofrece práctica introductoria para los siguientes temas de examen.
- Cloud Practitioner (CLF-C02) · Tarea 3.4: Reconocer un caso de uso de réplicas de lectura relacionales.
- Solutions Architect – Associate (SAA-C03) · Tarea 3.3: Configurar réplicas para el patrón de lectura de una aplicación.
Crea e inspecciona una réplica de lectura
En este paso crearás otro PostgreSQL que recibe cambios del primario.
Una réplica de lectura atiende consultas con datos copiados. PostgreSQL envía cambios mediante el registro de escritura anticipada, o WAL. El servidor en espera reproduce los cambios; es un motor separado y la replicación puede ir por detrás de una escritura recién confirmada.
Una réplica de lectura y un servidor en espera Multi-AZ tienen fines distintos. La réplica ofrece un endpoint para consultas. El servidor en espera de una implementación estándar de instancia de base Multi-AZ sirve para disponibilidad y conmutación por error y no atiende lecturas de aplicaciones. Este laboratorio implementa una réplica, no una conmutación Multi-AZ.
Carga la configuración de conexión:
cd /home/labex/project
source database.env
Inspecciona el origen:
aws rds \
  describe-db-instances \
  --db-instance-identifier orders-db \
  --query 'DBInstances[0].{Identifier:DBInstanceIdentifier,Status:DBInstanceStatus,BackupRetention:BackupRetentionPeriod,Endpoint:Endpoint}'
RDS exige un período de retención de copias distinto de cero en el origen de una réplica. Este entorno proporciona un primario con retención 1. Usarás esa configuración; el ejercicio no prueba la programación automática de copias.
Crea la réplica:
aws rds \
  create-db-instance-read-replica \
  --db-instance-identifier orders-reader \
  --source-db-instance-identifier orders-db \
  --db-instance-class db.t3.micro \
  --no-publicly-accessible \
  --query 'DBInstance.{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Status:DBInstanceStatus,Endpoint:Endpoint}'
aws rds \
  wait db-instance-available \
  --db-instance-identifier orders-reader
Inspecciona ambos recursos:
aws rds \
  describe-db-instances \
  --query 'DBInstances[].{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Endpoint:Endpoint.Address}' \
  --output table
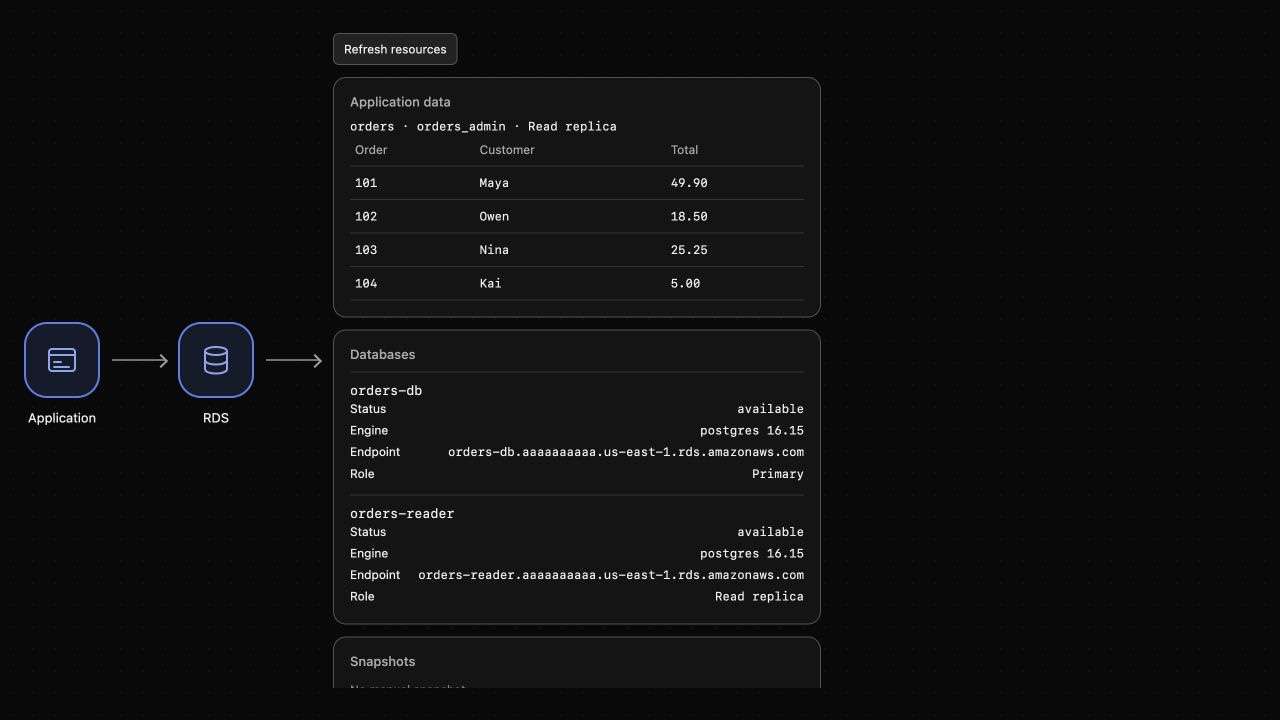
Debes obtener otro endpoint para orders-reader y una relación de origen con orders-db. AWS View debe listar primario y réplica.
Consulta el motor real de la réplica:
psql \
  "service=orders-reader" \
  --command 'SELECT current_database(), pg_is_in_recovery();'
Debes obtener la base orders y pg_is_in_recovery igual a t (true). PostgreSQL ejecuta realmente el modo de recuperación en espera, en vez de tener solo una etiqueta de réplica en RDS.
Separa los endpoints de lectura y escritura
En este paso mantendrás las escrituras en el primario y enviarás las consultas a la réplica.
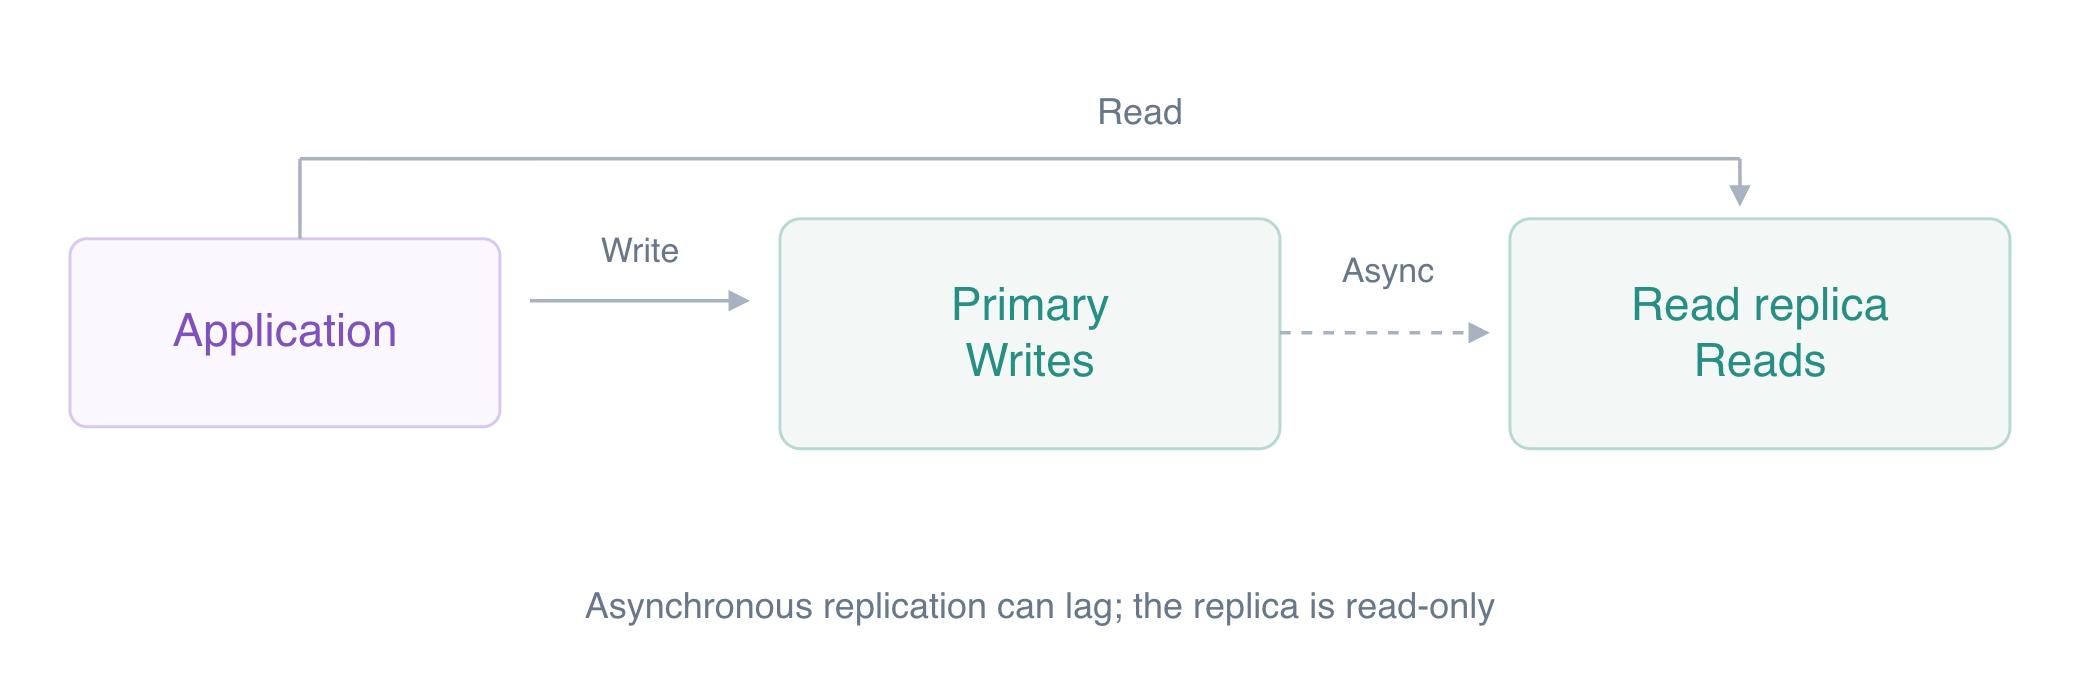
Diagrama conceptual: Las escrituras van al principal; las lecturas pueden usar la réplica asíncrona.
Inspecciona la configuración de la aplicación:
cat app-config.json
Ambos hosts indican el primario. Obtén el endpoint de la réplica:
READER_ENDPOINT=$(aws rds \
  describe-db-instances \
  --db-instance-identifier orders-reader \
  --query 'DBInstances[0].Endpoint.Address' \
  --output text)
Cambia solo read_host:
jq \
  --arg host "$READER_ENDPOINT" \
  '.read_host = $host' \
  app-config.json > app-config.new
mv app-config.new app-config.json
Lee mediante la aplicación:
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Debes obtener los tres pedidos originales y read_only: true. La respuesta procede de la conexión SQL real de la aplicación al servidor en espera. AWS View debe identificarlo como réplica de lectura.
La réplica usa las identidades de base copiadas del origen. Elegir el endpoint decide qué instancia recibe la conexión; la autenticación y los permisos SQL siguen aplicándose.
Observa la replicación y el rechazo de escrituras
En este paso guardarás un pedido por el primario y lo leerás de la réplica.
Añade un pedido por la aplicación. Su manejador POST usa write_host, que sigue apuntando al primario:
curl \
  --silent \
  --show-error \
  --fail \
  --request POST \
  --header 'Content-Type: application/json' \
  --data '{"order_id":104,"customer":"Kai","total":"5.00"}' \
  http://127.0.0.1:8080/application/orders
Debes obtener saved: true. Consulta origen y réplica por separado:
psql \
  "service=orders-db" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
psql \
  "service=orders-reader" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
Debes obtener el pedido de Kai por 5.00 en ambos. Si aún no aparece en la primera consulta a la réplica, repítela al cabo de un momento: la replicación asíncrona admite retraso. Una réplica sirve para cargas con muchas lecturas, pero la consistencia inmediata puede exigir leer del primario un valor recién escrito.
Lee otra vez la lista de la aplicación:
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Debes obtener cuatro pedidos y read_only: true.
Intenta insertar realmente en la réplica:
psql \
  "service=orders-reader" \
  --set=ON_ERROR_STOP=1 \
  --command "INSERT INTO orders (order_id, customer, total) VALUES (105, 'Lena', 9.00);"
Debes obtener un error indicando que INSERT no se puede ejecutar en una transacción de solo lectura. El modo de recuperación rechaza la escritura incluso con la identidad maestra. Confirma que el pedido intentado no existe en ninguno de los motores:
psql \
  "service=orders-db" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
psql \
  "service=orders-reader" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
Debes obtener 0 de cada uno. Las escrituras corresponden al primario; las consultas pueden usar la réplica cuando sus requisitos de consistencia lo permiten.
Elimina réplica y primario
En este paso eliminarás las dos instancias de práctica.
Elimina primero la réplica y después el origen:
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-reader \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-reader
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-db \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-db
aws rds \
  describe-db-instances \
  --query 'DBInstances[].DBInstanceIdentifier'
Debes obtener [] y ninguna base en AWS View. Conserva la aplicación y los recursos de red preparados.
Resumen
Creaste una réplica PostgreSQL y verificaste su modo real de recuperación en espera. Separaste los endpoints de lectura y escritura, observaste una escritura del primario llegar a la réplica y confirmaste el rechazo de escrituras directas. Finalmente eliminaste ambas instancias.
Una réplica soporta patrones de lectura; su finalidad y comportamiento difieren del servidor en espera de una implementación estándar de instancia Multi-AZ. El desafío final aplica las habilidades de conexión y diagnóstico aprendidas.


