Introducción
La tienda guarda ventas por mes. September ya está catalogado; el archivo nuevo de October está localmente. Súbelo a su prefijo S3 mensual, registra la partición Glue y consulta el mes nuevo y ambos meses con Athena.
Completa primero Query S3 Data with Athena. El entorno independiente incluye sales particionada, datos y partición de September, CSV local nuevo e identidad AWS configurada. No necesitas cuenta personal ni recursos anteriores. Usa comandos S3, Glue y Athena normales en Terminal y compara archivos, ubicaciones registradas y resultados reales en AWS View.
Relación con la certificación
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Explicar cómo los metadatos Glue permiten analizar datos S3 particionados con Athena. |
Añadir el archivo mensual nuevo
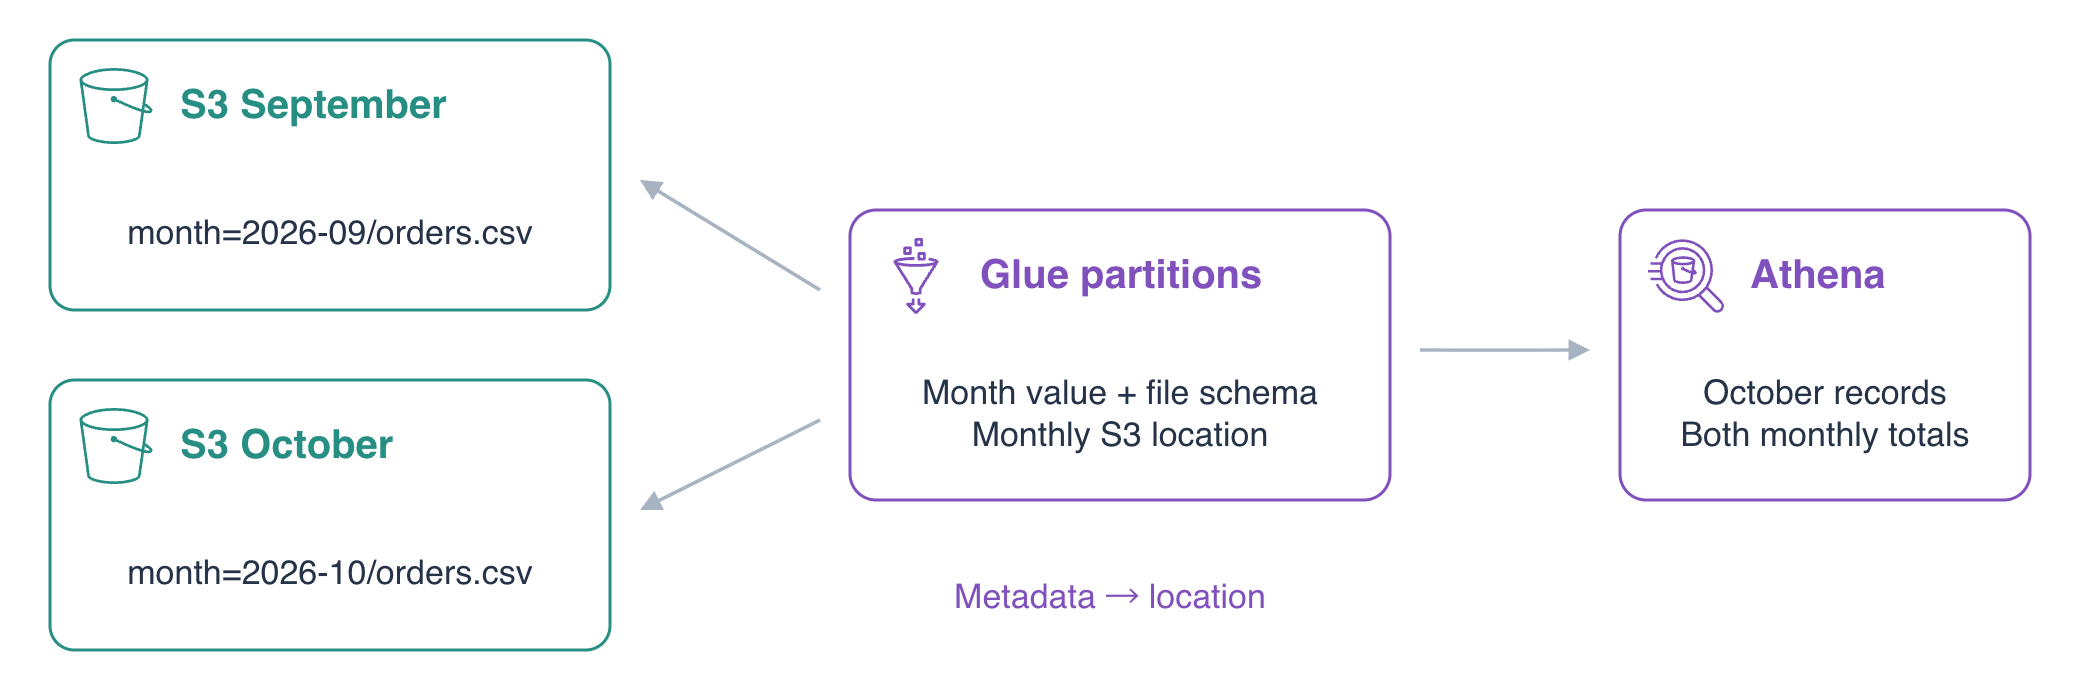
En este paso, sube October sin cambiar September. Una partición agrupa por una clave, como mes. sales/month=2026-09/ contiene September y sales/month=2026-10/ recibirá October. El nombre key=value muestra la agrupación; subir no registra automáticamente el catálogo.
Entra al proyecto y verifica identidad:
cd /home/labex/project
aws sts \
  get-caller-identity
El ARN termina en labex-an03-operator. jq -r extrae texto JSON y $(...) lo guarda en variables:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive incluye objetos bajo prefijos anidados:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
Debe aparecer sales/month=2026-09/orders.csv. September contiene 1000, 2000 y 500 centavos, total 3500. Conserva ese archivo y reference/notes.txt. Inspecciona October:
cat october.csv
O01/east/700, O02/west/900 y O03/east/400 suman 2000 centavos en tres pedidos, con las mismas tres columnas. Sube a su propio prefijo:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
Lee de nuevo el objeto real:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
El - final imprime el contenido. AWS View muestra dos archivos S3, pero solo la partición September en Glue: llegada y registro son distintos.
Registrar October en el catálogo
En este paso, demuestra que subir no basta y añade metadatos. Una partición asocia un valor de clave con ubicación S3 y esquema. La clave de partición month es string. El CSV solo contiene order_id, region y total_cents; month proviene de la definición.
Inspecciona la clave:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
Es month de tipo string. Consulta antes de registrar. COUNT(*) cuenta registros coincidentes; el delimitador heredoc entre comillas conserva SQL:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
Envía con la base y prefijo preparados y muestra el ID:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
Repite para QUEUED o RUNNING, continúa con SUCCEEDED y lee Reason si falla:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lee el resultado:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
El recuento es 0 pese al archivo. Esta tabla lee ubicaciones registradas; el nombre del directorio no crea metadatos.
Reutiliza el descriptor para conservar columnas y formato CSV. > escribe JSON en un archivo:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg pasa la ubicación real como string; .Location = $location sustituye la ubicación por October. Values aporta el valor de la única clave:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
Inspecciona el JSON normal antes de crear:
cat october-partition.json
Confirma 2026-10 en Values, columnas compatibles y final /sales/month=2026-10/. Las llaves de ${SALES_LOCATION} separan el nombre de variable del sufijo. Registra usando file:// para leer JSON local:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
Lista las particiones:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Cada mes apunta a su prefijo y AWS View muestra ambas asociaciones. El registro cambia metadatos, no copia ni reescribe CSV.
Consultar October y los totales de ambos meses
En este paso, prueba que October es consultable y September sigue correcto. WHERE sobre la clave selecciona un mes. Verificas registros reales, no costes de escaneo ni velocidad de producción.
Escribe la consulta October:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
Envía una ejecución nueva: registrar no reescribe el resultado anterior de cero:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
Comprueba estado, repite si está pendiente, continúa tras éxito y revisa fallos:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lee las filas:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Tras la cabecera aparecen O01/700, O02/900 y O03/400. El mismo archivo antes invisible ahora aporta tres registros.
Resume ambos meses: SUM suma centavos y COUNT(*) cuenta pedidos en cada GROUP BY month:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Envía y muestra su ID separado:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
Confirma éxito; repite el estado o revisa la razón cuando corresponda:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lee los grupos:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September tiene 3500 centavos/3 pedidos y October 2000/3. Añadiste October sin cambiar September. Compara ubicaciones Glue, SQL y filas en AWS View.
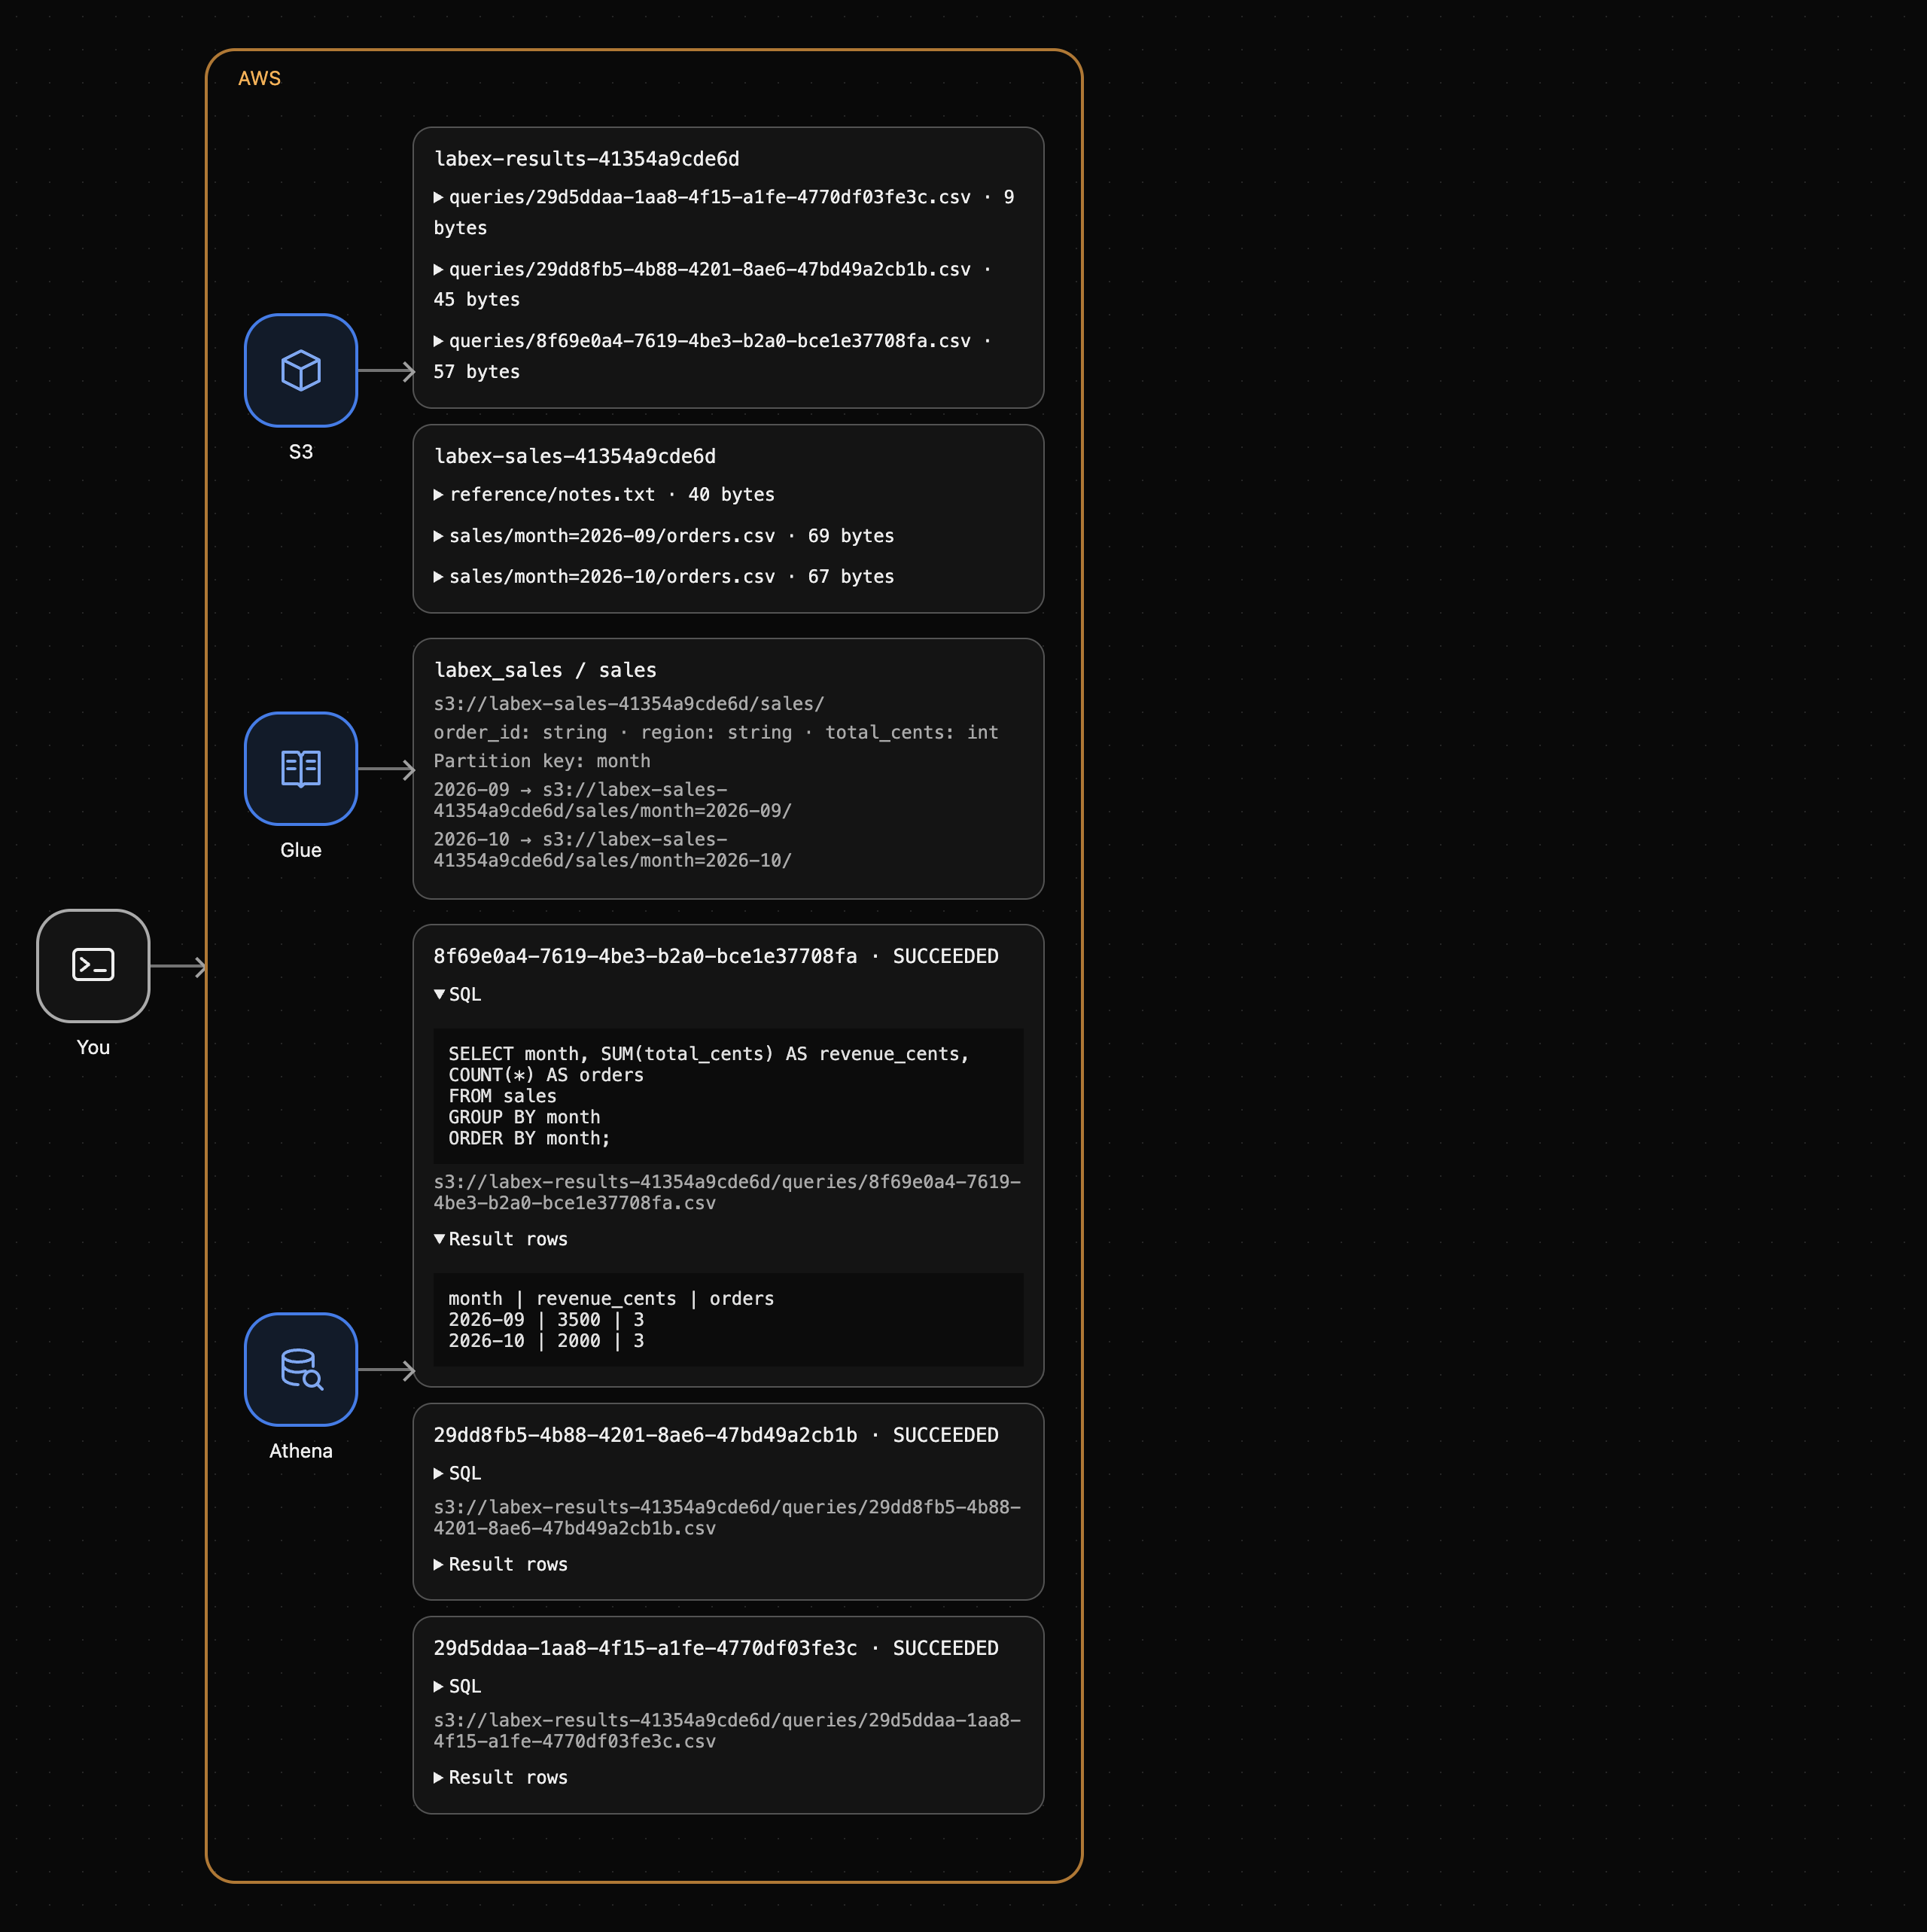
El cero anterior permanece como resultado independiente del estado anterior del catálogo.
Resumen
Subiste un CSV mensual, observaste que sin registro no aportaba filas, registraste ubicación y esquema Glue y comprobaste October y ambos totales. Archivos y metadatos son distintos: esta tabla necesita registrar el prefijo nuevo. El siguiente laboratorio convierte los resultados reales en un archivo reutilizable.
Para ampliar este tema, consulta la referencia de AWS: Claves, ubicaciones y registro de particiones.