



Introducción
Tu aplicación tiene dos servidores detrás de un Application Load Balancer. Un servidor puede fallar aunque su instancia EC2 siga en ejecución. Configurarás chequeos de salud, harás que una aplicación informe un fallo real y verificarás que el servidor saludable siga atendiendo solicitudes. Después recuperarás la aplicación y eliminarás los recursos de balanceo.
Debes conocer listeners ALB, grupos de destino y conexiones SSH EC2. Este entorno nuevo proporciona la red, dos servidores activos, sus registros y un listener ALB. Es independiente del laboratorio anterior y tiene AWS CLI configurado y archivos de conexión preparados.
Relación con certificaciones
Este laboratorio ofrece práctica introductoria para estos temas de examen.
- Solutions Architect – Associate (SAA-C03) · Tarea 2.2: Entender cómo la salud de la aplicación y el balanceo mantienen la disponibilidad durante un fallo de servidor.
- CloudOps Engineer – Associate (SOA-C03) · Tarea 2.2: Configurar chequeos de salud ELB y diagnosticar un destino no saludable.
Configura los chequeos de salud
En este paso inspeccionarás el servicio y configurarás cómo ALB comprueba la disponibilidad de la aplicación.
Entra en el directorio preparado y carga las variables de red:
cd /home/labex/project
source launch.env
Busca el balanceador y el grupo proporcionados por nombre. Guarda sus ARN para los comandos posteriores y el DNS para las solicitudes HTTP:
LB_ARN=$(aws elbv2 \
  describe-load-balancers \
  --names application-alb \
  --query 'LoadBalancers[0].LoadBalancerArn' \
  --output text)

TG_ARN=$(aws elbv2 \
  describe-target-groups \
  --names application-targets \
  --query 'TargetGroups[0].TargetGroupArn' \
  --output text)

LB_DNS=$(aws elbv2 \
  describe-load-balancers \
  --load-balancer-arns "$LB_ARN" \
  --query 'LoadBalancers[0].DNSName' \
  --output text)
Un chequeo de salud consulta cada destino registrado independientemente de las solicitudes de clientes. La ruta debe indicar si la aplicación puede servir tráfico. Inspecciona los ajustes actuales:
aws elbv2 \
  describe-target-groups \
  --target-group-arns "$TG_ARN" \
  --query 'TargetGroups[].{Path:HealthCheckPath,Interval:HealthCheckIntervalSeconds,Timeout:HealthCheckTimeoutSeconds,Healthy:HealthyThresholdCount,Unhealthy:UnhealthyThresholdCount,Matcher:Matcher}'
El grupo consulta /health cada 30 segundos. Para este ejercicio pequeño, configura un intervalo de cinco segundos y un timeout de dos. Exige dos fallos consecutivos para excluir un destino y dos éxitos para readmitir uno no saludable. El matcher considera HTTP 200 un éxito:
aws elbv2 \
  modify-target-group \
  --target-group-arn "$TG_ARN" \
  --health-check-protocol HTTP \
  --health-check-path /health \
  --health-check-interval-seconds 5 \
  --health-check-timeout-seconds 2 \
  --healthy-threshold-count 2 \
  --unhealthy-threshold-count 2 \
  --matcher HttpCode=200 \
  --query 'TargetGroups[].{Path:HealthCheckPath,Interval:HealthCheckIntervalSeconds,Healthy:HealthyThresholdCount,Unhealthy:UnhealthyThresholdCount}'
El intervalo controla la frecuencia y el timeout limita la espera de cada consulta. Los umbrales evitan reaccionar a un fallo breve. En producción deben reflejar el arranque y los fallos de la aplicación; los valores cortos hacen observable este ejercicio.
Espera a que ambos destinos estén saludables e inspecciona sus estados reales:
aws elbv2 \
  wait target-in-service \
  --target-group-arn "$TG_ARN"

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Port:Target.Port,Health:TargetHealth.State}' \
  --output table
Abre AWS View. Confirma dos destinos healthy y pulsa Send request para ver HTTP 200 real. Los estados y la respuesta establecen la condición inicial.
Observa un fallo real de aplicación
En este paso harás fallar el endpoint de salud de app-a mientras su instancia EC2 sigue ejecutándose.
Obtén los IDs por sus etiquetas de nombre y la dirección necesaria para SSH:
APP_A=$(aws ec2 \
  describe-instances \
  --filters Name=tag:Name,Values=app-a \
  --query 'Reservations[0].Instances[0].InstanceId' \
  --output text)

APP_B=$(aws ec2 \
  describe-instances \
  --filters Name=tag:Name,Values=app-b \
  --query 'Reservations[0].Instances[0].InstanceId' \
  --output text)

APP_A_IP=$(aws ec2 \
  describe-instances \
  --instance-ids "$APP_A" \
  --query 'Reservations[0].Instances[0].PublicIpAddress' \
  --output text)
La aplicación lee /etc/report-app/config.json en cada solicitud. healthy controla si /health devuelve 200 o 503. Usa SSH con la clave y los ajustes proporcionados. jq cambia solo ese campo; un archivo temporal evita sobrescribir mientras lees, e install reemplaza el archivo con permisos de lectura:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'sudo jq ".healthy = false" /etc/report-app/config.json > /tmp/report-config.json && sudo install -m 644 /tmp/report-config.json /etc/report-app/config.json'
Comprueba la aplicación desde dentro del servidor. -o /dev/null descarta el cuerpo y -w imprime el estado HTTP:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/health'
Espera 503. Es un fallo de aplicación, no una parada EC2. Deja tiempo para dos chequeos e inspecciona la causa:
sleep 12

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Health:TargetHealth.State,Reason:TargetHealth.Reason}' \
  --output table
APP_A debe estar unhealthy con Target.ResponseCodeMismatch, porque 503 no coincide con 200. APP_B debe seguir healthy. Los chequeos son asíncronos; si la transición está pendiente, espera brevemente y repite la consulta.
Verifica que las instancias EC2 sigan ejecutándose:
aws ec2 \
  describe-instances \
  --instance-ids "$APP_A" "$APP_B" \
  --query 'Reservations[].Instances[].{Instance:InstanceId,State:State.Name}' \
  --output table
Envía seis solicitudes independientes mediante el ALB:
for request in 1 2 3 4 5 6; do
  curl --config client.conf -sS "http://$LB_DNS/health"
  echo
done
Todas las respuestas deben identificar APP_B. En AWS View, confirma un destino no saludable y otro saludable. Pulsa Send request varias veces; las respuestas correctas deben identificar el servidor saludable. ALB excluye el destino fallido mientras exista uno saludable.
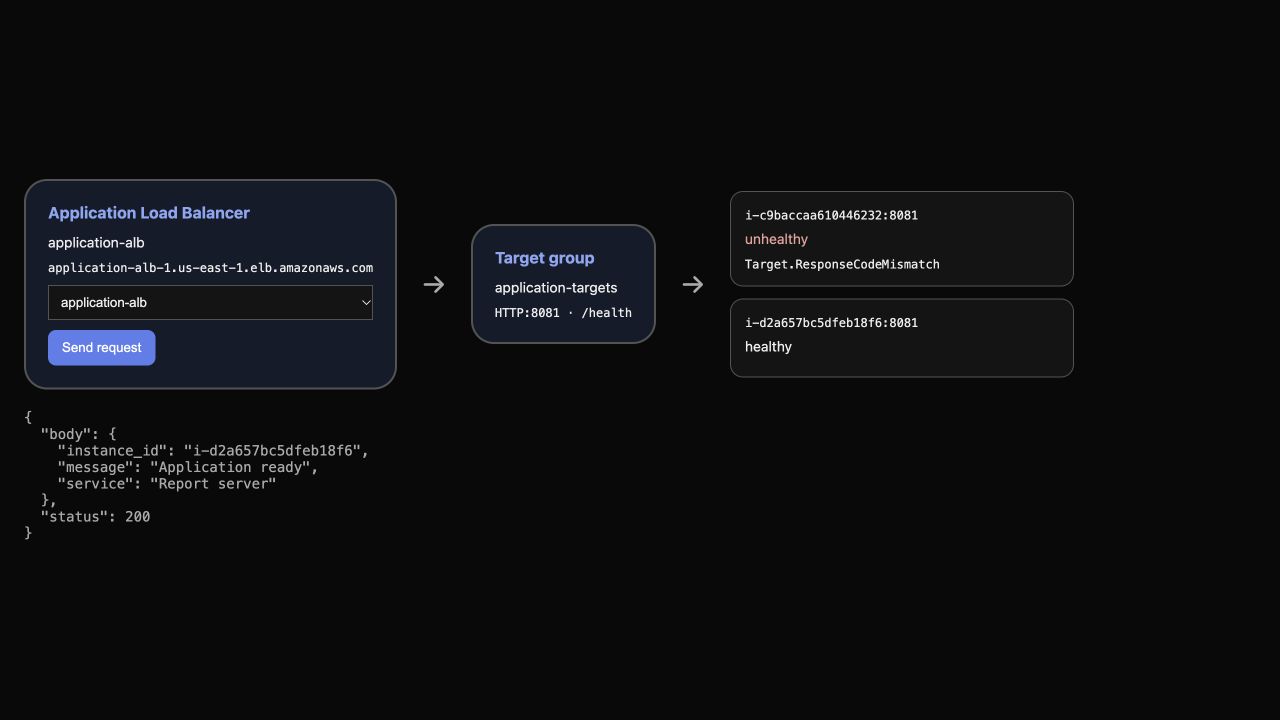
El ejemplo muestra HTTP 200 real desde el destino saludable mientras el otro informa Target.ResponseCodeMismatch. Tus IDs serán distintos; compara la respuesta con tu propio destino saludable.
Si todos los destinos fallan, ALB puede usar fail open y enviar tráfico a destinos no saludables. Mantener app-b saludable es esencial; no interpretes un grupo sin destinos saludables como prueba de que ALB deja de reenviar toda solicitud.
Recupera y readmite el destino
En este paso recuperarás app-a y observarás su regreso al tráfico tras superar los chequeos.
Restaura solo el campo healthy con el mismo reemplazo seguro del archivo:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'sudo jq ".healthy = true" /etc/report-app/config.json > /tmp/report-config.json && sudo install -m 644 /tmp/report-config.json /etc/report-app/config.json'
Confirma que el endpoint directo devuelva ahora 200:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/health'
La aplicación se recuperó, pero ALB todavía debe observar los éxitos consecutivos configurados. Espera el estado saludable e inspecciona ambos destinos:
aws elbv2 \
  wait target-in-service \
  --target-group-arn "$TG_ARN"

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Health:TargetHealth.State}' \
  --output table
Ambos deben estar healthy. Envía seis solicitudes otra vez:
for request in 1 2 3 4 5 6; do
  curl --config client.conf -sS "http://$LB_DNS/health"
  echo
done
Busca ambos IDs. En AWS View, confirma las dos tarjetas saludables y usa Send request para observar ambos servidores. Reparaste la aplicación y permitiste chequeos correctos; no reemplazaste ni eliminaste el registro de la instancia.
Elimina los recursos de balanceo
En este paso quitarás la configuración de balanceo proporcionada y conservarás los servidores recuperados y la red.
Obtén el ARN del listener, elimina primero el listener y después el ALB y su grupo:
LISTENER_ARN=$(aws elbv2 \
  describe-listeners \
  --load-balancer-arn "$LB_ARN" \
  --query 'Listeners[0].ListenerArn' \
  --output text)

aws elbv2 \
  delete-listener \
  --listener-arn "$LISTENER_ARN"

aws elbv2 \
  delete-load-balancer \
  --load-balancer-arn "$LB_ARN"

aws elbv2 \
  delete-target-group \
  --target-group-arn "$TG_ARN"
Confirma que ambas listas estén vacías:
aws elbv2 \
  describe-load-balancers \
  --query 'LoadBalancers[].LoadBalancerName'

aws elbv2 \
  describe-target-groups \
  --query 'TargetGroups[].TargetGroupName'
Espera [] en ambas consultas y áreas de balanceo vacías en AWS View. Conserva los servidores EC2 y la red proporcionados.
Resumen
Configuraste chequeos ALB, provocaste un fallo real y lo distinguiste de una instancia EC2 detenida. Observaste tráfico en el servidor saludable, recuperaste la aplicación y confirmaste solicitudes en ambos servidores. Finalmente, eliminaste el balanceo y conservaste los servidores y la red.
El siguiente laboratorio utiliza un grupo Auto Scaling para reemplazar instancias fallidas en lugar de reparar manualmente un servidor.


