



Introducción
Un trabajo de pedido no válido falla cada vez que el procesador lo procesa. Limitarás sus intentos, lo conservarás en una cola separada para investigarlo y confirmarás que los pedidos válidos siguen completándose.
Completa primero Gestionar el tiempo de espera de visibilidad y las nuevas entregas y sus requisitos previos guiados. Esta VM independiente proporciona un procesador y una tabla de pedidos vacía; las colas, los mensajes y la conexión del consumidor son tu trabajo.
Relación con las certificaciones
Este laboratorio ofrece práctica para los siguientes temas de examen.
- Solutions Architect – Associate (SAA-C03) · Tarea 2.1: Procesamiento limitado de mensajes y aislamiento del trabajo fallido.
- Developer – Associate (DVA-C02) · Tarea 1.1: Procesamiento limitado de mensajes y aislamiento del trabajo fallido.
- DevOps Engineer – Professional (DOP-C02) · Tarea 5.1: Práctica de fundamentos: Procesamiento limitado de mensajes y aislamiento del trabajo fallido.
- Solutions Architect – Professional (SAP-C02) · Tarea 2.4: Práctica de fundamentos: Procesamiento limitado de mensajes y aislamiento del trabajo fallido.
Conectar una cola de origen a una cola de mensajes fallidos
En este paso, crea dos colas Standard vacías y configura una redirección con límite en la cola de origen.
Una cola de mensajes fallidos (DLQ) conserva trabajos que superan el límite de recepciones de una cola de origen. Usa AWS View junto a Terminal para comparar ambas colas, los intentos reales y los pedidos almacenados; conserva los datos de referencia.
cd /home/labex/project
Crea el destino para trabajos fallidos y guarda su dirección de cola:
DEAD_URL=$(aws sqs create-queue --queue-name labex-q03-dead --query QueueUrl --output text)
La política de redirección referencia el ARN del destino, su identificador de recurso del servicio, en lugar de su URL de cola. Selecciona ese ARN:
DEAD_ARN=$(aws sqs get-queue-attributes --queue-url "$DEAD_URL" --attribute-names QueueArn --query Attributes.QueueArn --output text)
Escribe una pequeña política JSON. El shell inserta tu ARN de destino en $DEAD_ARN; maxReceiveCount permite dos intentos de entrega antes de que una recepción posterior mueva el mensaje a la DLQ.
cat > redrive-policy.json <<EOF
{
  "deadLetterTargetArn": "$DEAD_ARN",
  "maxReceiveCount": 2
}
EOF
Los atributos de cola SQS representan la política de redirección como una cadena JSON dentro de otro documento JSON. --rawfile lee el archivo de política como esa cadena; > escribe el archivo de atributos.
jq -n --rawfile policy redrive-policy.json '{VisibilityTimeout:"30",RedrivePolicy:$policy}' > queue-attributes.json
Crea la cola de origen con esos atributos:
QUEUE_URL=$(aws sqs create-queue --queue-name labex-q03-jobs --attributes file://queue-attributes.json --query QueueUrl --output text)
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names QueueArn VisibilityTimeout RedrivePolicy
Espera el tiempo de espera de visibilidad 30, una política que apunte a labex-q03-dead y el límite de recepciones 2. Guarda el ARN de origen para conectar el consumidor:
QUEUE_ARN=$(aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names QueueArn --query Attributes.QueueArn --output text)
AWS View muestra ambas colas vacías, sin ejecución del procesador ni pedido. Una política de redirección no procesa los mensajes por sí misma; la recepción debe realizarse mediante un consumidor.
Conectar el consumidor y demostrar el procesamiento correcto
En este paso, conecta una asignación de origen de eventos de Lambda y verifica el procesamiento real de un trabajo válido.
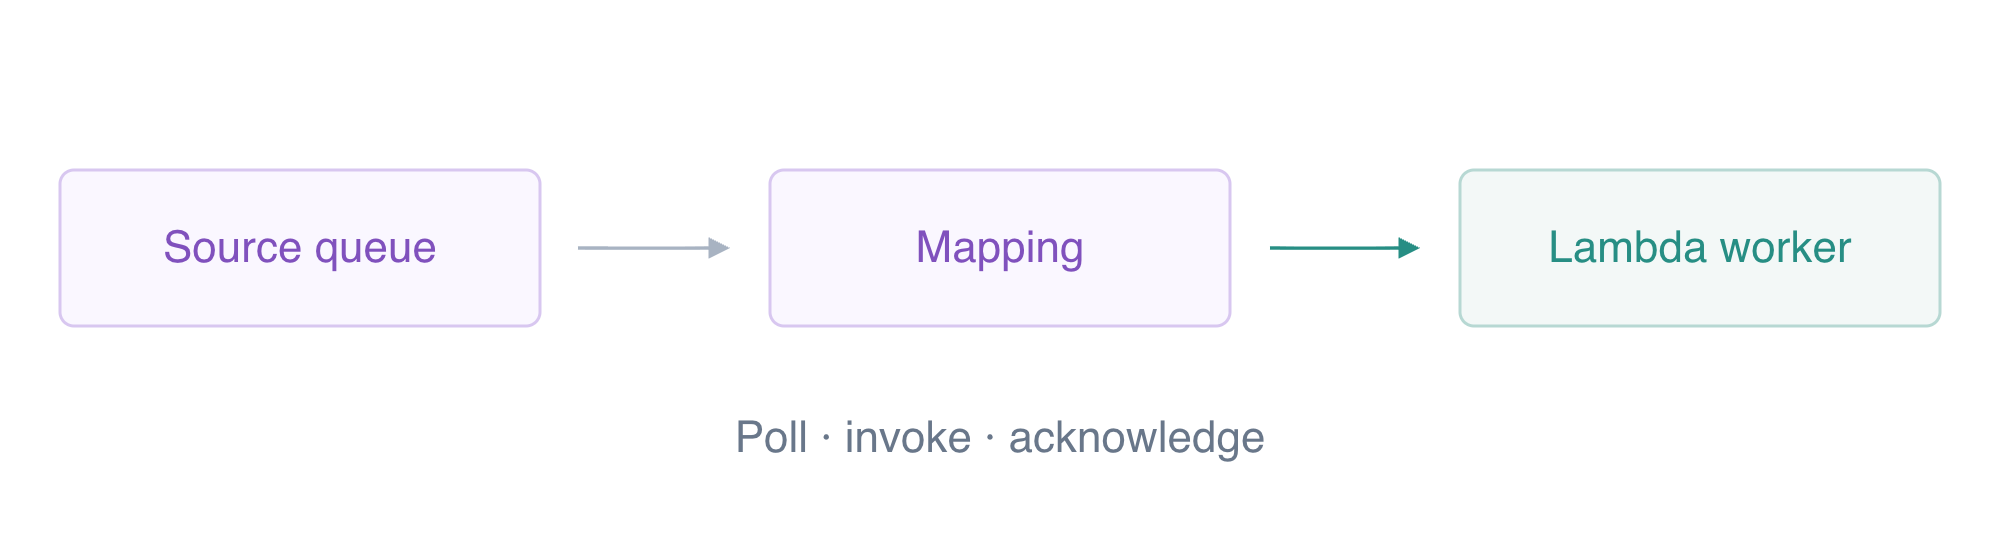
La asignación sondea la cola e invoca el procesador; el procesamiento correcto le permite confirmar el mensaje.
Una asignación de origen de eventos conecta la cola de origen a un consumidor Lambda. Sondea los mensajes, los pasa como un evento SQS Records y elimina los mensajes procesados correctamente. El rol de ejecución proporcionado solo tiene permisos de recepción y eliminación de la cola de origen, escritura en la tabla de pedidos y registro. El procesador rechaza cantidades fuera de 1–10. Su código y sus permisos son recursos preparados; tu tarea es conectar la cola y aislar los fallos.
Crea una asignación con un tamaño de lote de uno para que cada intento tenga un trabajo que inspeccionar:
MAPPING_ID=$(aws lambda create-event-source-mapping --function-name labex-q03-worker --event-source-arn "$QUEUE_ARN" --batch-size 1 --enabled --query UUID --output text)
Lee la conexión:
aws lambda get-event-source-mapping --uuid "$MAPPING_ID" --query '{Source:EventSourceArn,Function:FunctionArn,Batch:BatchSize,State:State}'
Espera el ARN de origen de labex-q03-jobs, la función labex-q03-worker, el tamaño de lote 1 y el estado Enabled. La existencia de la asignación demuestra la configuración; un pedido real almacenado demostrará el procesamiento.
Envía un trabajo válido:
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"good-order","quantity":2}'
Observa AWS View hasta que el procesador devuelva un resultado y la tabla de pedidos muestre good-order. El procesamiento es asíncrono; deja un breve intervalo para el consumidor en lugar de recibir este mensaje manualmente. Después lee el pedido:
aws dynamodb get-item --table-name labex-q03-orders --key '{"id":{"S":"good-order"}}' --consistent-read --query Item
Espera la cantidad 2 y el total 600. Comprueba ambas colas:
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
aws sqs get-queue-attributes --queue-url "$DEAD_URL" --attribute-names ApproximateNumberOfMessages
Ambas colas deben estar vacías: el procesador completó la escritura de negocio y el consumidor confirmó el trabajo correcto. Un mensaje válido no debe estar en la DLQ.
Observar los reintentos limitados y el aislamiento de fallos
En este paso, envía un trabajo no válido y observa intentos reales de procesamiento fallidos antes de que la redirección nativa lo coloque en la DLQ.
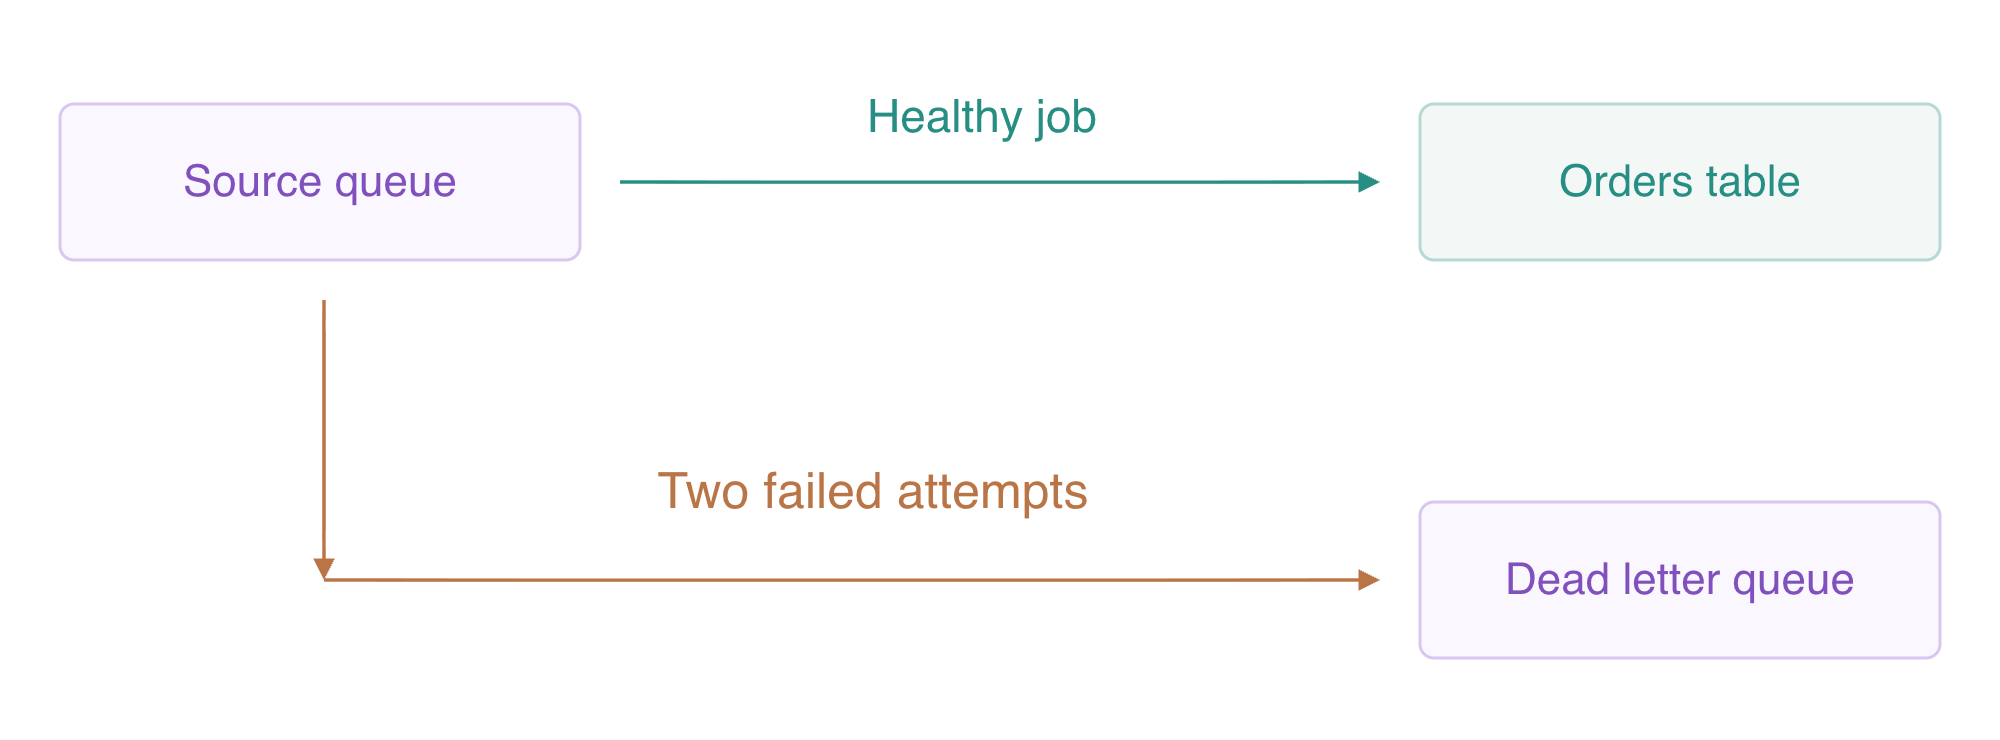
Con el límite de dos recepciones de este laboratorio, una recepción posterior mueve el trabajo fallido a la DLQ en lugar de invocar el procesador una tercera vez.
Un mensaje problemático, o poison message, falla repetidamente debido a sus datos o a la lógica que lo procesa. Envía una cantidad sintética no válida de cero:
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"poison-order","quantity":0}'
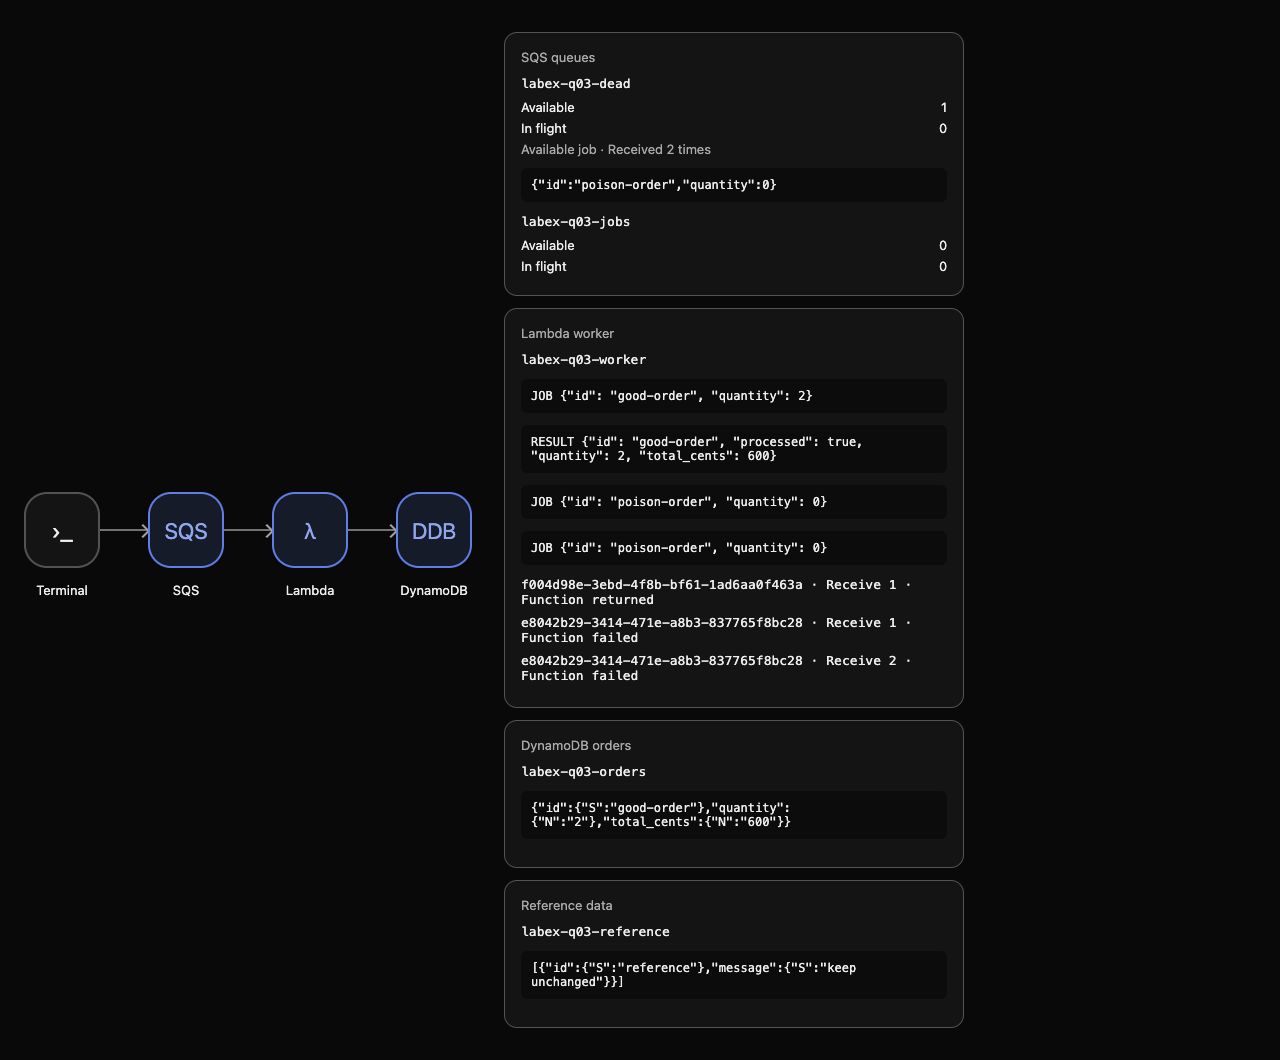
AWS View muestra el intento fallido del procesador. El mensaje permanece en curso hasta que vence su visibilidad; después, el consumidor puede recibirlo de nuevo. Observa los intentos y los recuentos de cola hasta que la DLQ tenga un trabajo disponible. Con esta ventana de 30 segundos y dos intentos, permite aproximadamente un minuto más el tiempo de procesamiento. No recibas ni elimines manualmente el trabajo mientras el consumidor está en ejecución; eso cambiaría los recuentos de recepción y el experimento.
Los dos intentos fallidos tienen el mismo ID de mensaje y los recuentos de recepciones 1 y 2. No aparece ningún pedido almacenado para poison-order. Después de alcanzar el límite de recepciones, una recepción nativa posterior saca el mensaje de la cola de origen en lugar de invocar la función una tercera vez.
Confirma el estado de las colas mediante CLI:
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
aws sqs get-queue-attributes --queue-url "$DEAD_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
Espera que la cola de origen tenga cero trabajos disponibles y cero en curso, con un trabajo disponible en la DLQ. AWS View muestra su cuerpo original. Inspecciona los registros reales del procesador para observar la cantidad no válida y el fallo:
aws logs filter-log-events --log-group-name /aws/lambda/labex-q03-worker --query 'events[].message'
Lee todos los elementos de pedidos:
aws dynamodb scan --table-name labex-q03-orders --query Items
Solo permanece good-order/2/600. El fallo se aisló sin descartar su mensaje ni escribir un pedido no válido. Mover un mensaje a una DLQ no es una reparación ni un resultado de negocio correcto; la recuperación y la eliminación de duplicados de trabajos se enseñan en unidades posteriores y en el reto del proyecto.
Eliminar la conexión y los recursos propios
En este paso, detén la conexión de tu consumidor antes de eliminar las colas y los resultados.
Elimina primero la asignación de origen de eventos:
aws lambda delete-event-source-mapping --uuid "$MAPPING_ID" --query UUID --output text
Elimina las dos colas desechables. Esto también descarta el trabajo problemático sintético conservado en la DLQ:
aws sqs delete-queue --queue-url "$QUEUE_URL"
aws sqs delete-queue --queue-url "$DEAD_URL"
Elimina el pedido válido y los registros de ejecución de este laboratorio:
aws dynamodb delete-item --table-name labex-q03-orders --key '{"id":{"S":"good-order"}}'
aws logs delete-log-group --log-group-name /aws/lambda/labex-q03-worker
Comprueba la ausencia y la conservación de la referencia mediante respuestas correctas de las API:
aws lambda list-event-source-mappings --function-name labex-q03-worker --query EventSourceMappings
aws sqs list-queues
aws dynamodb scan --table-name labex-q03-orders --query Items
aws dynamodb scan --table-name labex-q03-reference --query Items
Las listas de asignaciones y pedidos están vacías, no queda ninguna URL de cola y el elemento de referencia todavía indica keep unchanged. Permanecen el procesador proporcionado y las estructuras de tablas. AWS View muestra el mismo estado de los recursos. Un fallo de autenticación o de red no puede demostrar la eliminación.
Elimina los archivos locales ordinarios de políticas:
rm -f redrive-policy.json queue-attributes.json
Ejecuta la comprobación de limpieza antes de finalizar el entorno.
Resumen
Conectaste una cola de origen SQS a una DLQ con un límite de recepciones, asociaste un consumidor Lambda y verificaste un pedido válido almacenado. Observaste cómo un trabajo no válido fallaba dos veces y pasaba a la DLQ sin una escritura de negocio, y después eliminaste tu asignación, tus colas, tu resultado y tus registros, conservando los recursos proporcionados.


