Introducción
Un equipo de soporte necesita un borrador de respuesta a un cargo duplicado comunicado por un cliente. Enviarás el ticket a Bedrock Runtime, refinarás las instrucciones, inspeccionarás la respuesta generada y compararás el uso de tokens con un límite de salida. AWS CLI ya está configurada en tu nueva VM de LabEx; utiliza solo el ticket sintético proporcionado aquí.
Debes saber ejecutar un comando y leer un archivo de texto. La tarea consiste en generar y revisar un borrador, no en enviar un mensaje al cliente ni cambiar registros de facturación.
Relación con la certificación
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| AI Practitioner (AIF-C01) | Tareas 3.1, 3.2 | Ajustar la longitud de salida, proporcionar instrucciones explícitas y revisar el texto generado. |
Redacta una respuesta de soporte
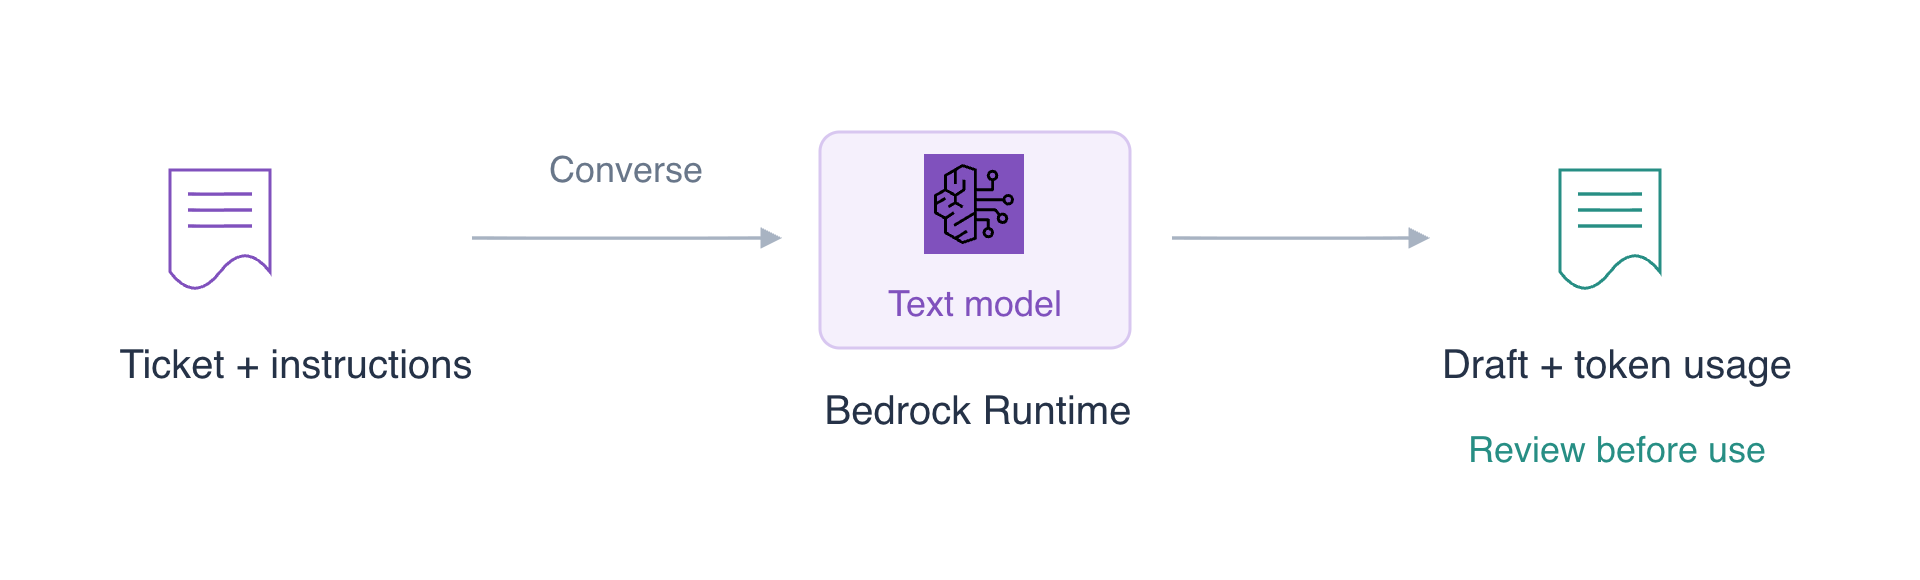
En este paso seleccionarás un modelo de texto disponible y enviarás un ticket de soporte a Bedrock Runtime.
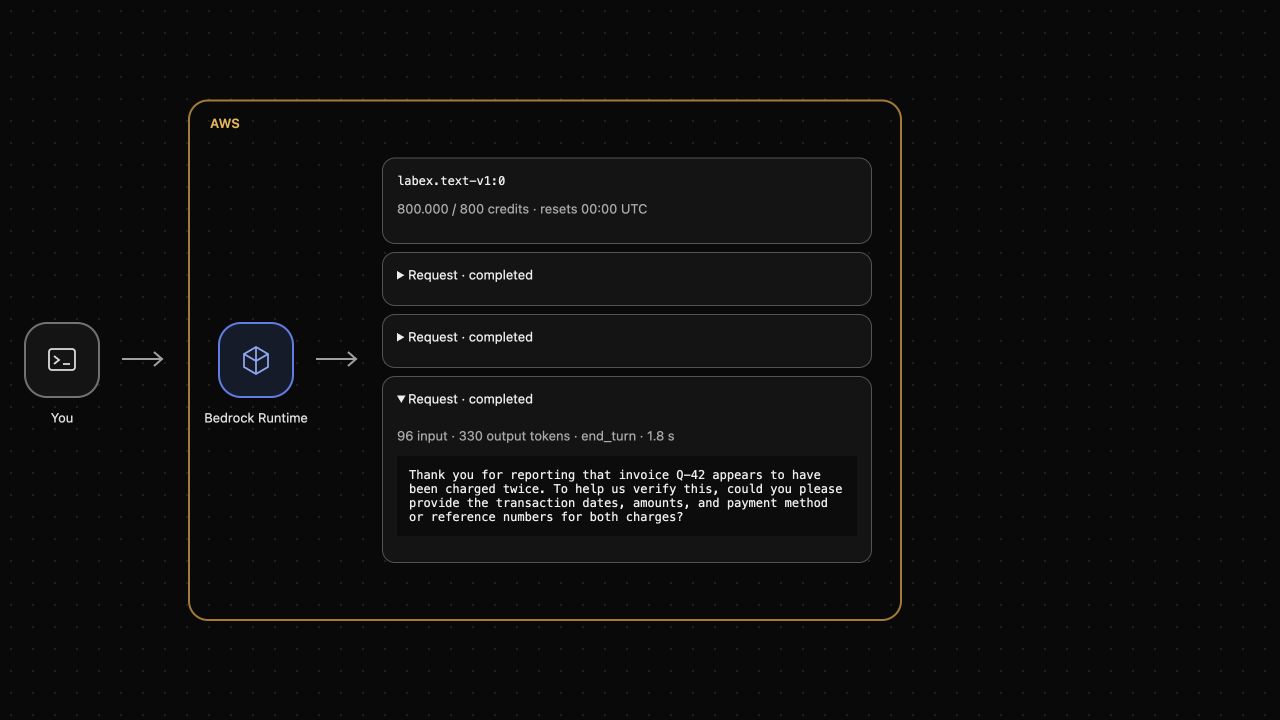
La parte superior, AWS View, muestra el modelo y los resultados reales de las solicitudes. Introduce los comandos en Terminal, debajo. Antes de enviar una solicitud, la vista no contiene respuestas. Mostrará una solicitud pendiente y después su respuesta, uso y cuota restante.
Bedrock proporciona acceso a modelos fundacionales, capaces de generar texto para muchas tareas. Un identificador selecciona el modelo; Converse es un formato común de solicitud para modelos conversacionales compatibles. Aquí trabajarás con el modelo de texto disponible en este espacio.
Comienza en el directorio del ejercicio. cd cambia el directorio actual de Terminal:
cd /home/labex/project
Lista los modelos que producen texto. --by-output-modality TEXT filtra el catálogo. --query selecciona el identificador y el nombre legible; --output table muestra esos campos como tabla:
aws bedrock list-foundation-models \
  --by-output-modality TEXT \
  --query 'modelSummaries[].[modelId,modelName]' \
  --output table
La tabla incluye labex.text-v1:0, que usarás a continuación. Una entrada del catálogo describe un modelo; no significa que ya se haya ejecutado una solicitud de inferencia.
Una solicitud Converse contiene un modelId, una lista de messages y ajustes de inferencia opcionales. Cada mensaje tiene un role y bloques de contenido. Un mensaje user contiene la pregunta o tarea; un bloque textual utiliza el campo text. maxTokens limita la salida generada y temperature controla la variación del muestreo. Una temperatura baja puede reducir la variación, pero no garantiza respuestas exactas ni idénticas.
Crea la solicitud como JSON. cat > request.json escribe un archivo; <<'EOF' inicia una entrada literal de varias líneas y el último EOF la termina. Solo se reemplaza el archivo del ejercicio indicado:
cat > request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. Draft an English support reply in two sentences."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Envía la solicitud con bedrock-runtime converse. --cli-input-json file://request.json lee los campos de ese archivo. El último > reply.json guarda la respuesta JSON en vez de imprimirla:
aws bedrock-runtime converse \
  --cli-input-json file://request.json \
  > reply.json
Espera a que vuelva el prompt de Terminal. Generar texto suele tardar varios segundos. No ejecutes otra solicitud mientras la primera esté pendiente.
Lee la respuesta:
cat reply.json
Busca output.message.role: "assistant" y un bloque text no vacío. usage informa de los tokens procesados y metrics.latencyMs del tiempo de respuesta en milisegundos. Encima de Terminal, expande la solicitud completada en AWS View y compara la respuesta con el archivo.
Lee el borrador con atención. ¿Afirma que se ha iniciado una investigación, emitido un reembolso o confirmado un cargo? El ticket no aporta ninguno de esos hechos. Una respuesta fluida puede inventar detalles; a continuación precisarás las instrucciones. No interpretes una frase generada como una acción de facturación ya realizada.
Refina las instrucciones de redacción
En este paso añadirás instrucciones explícitas y generarás otro borrador con los mismos hechos comunicados.
El campo system da instrucciones sobre la tarea y el estilo. Conserva el ticket en el mensaje de usuario y coloca las restricciones de redacción en el mensaje del sistema. Instrucciones más específicas pueden reducir detalles no deseados, pero sigue siendo necesario revisar la respuesta.
Crea una solicitud separada para conservar el borrador original y compararlo:
cat > revised-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Genera el borrador revisado:
aws bedrock-runtime converse \
  --cli-input-json file://revised-request.json \
  > revised-reply.json
Inspecciona la respuesta guardada con el formateador JSON estándar de Python, que comprueba la validez del archivo y lo presenta de forma legible:
python3 -m json.tool revised-reply.json
En AWS View, arriba, expande la nueva solicitud completada. Compara ambos borradores con el ticket proporcionado. La solicitud revisada debe aclarar tus expectativas; determinar si esta respuesta las cumple todavía exige criterio humano. Si inventa una acción, no uses esa frase en una respuesta al cliente.
Las solicitudes son independientes. Reutilizar el modelo no envía automáticamente la respuesta anterior como historial. Una conversación posterior necesitaría incluir explícitamente sus mensajes previos de usuario y asistente en messages.
Inspecciona el uso de tokens y los límites de salida
En este paso enviarás la misma tarea con un límite de salida menor e inspeccionarás el uso real.
Un token es una unidad de texto procesada por un modelo; no equivale necesariamente a una palabra. Los tokens de entrada incluyen la tarea, las instrucciones del sistema y el historial proporcionado. Los de salida incluyen los tokens generados que informa el modelo, que pueden abarcar razonamiento interno. El totalTokens devuelto suma entrada y salida.
maxTokens es un máximo, no una petición de producir exactamente esa cantidad. El modelo puede terminar antes. Crea la solicitud limitada a 384 tokens en lugar de 512:
cat > bounded-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 384, "temperature": 0}
}
EOF
Envíala y guarda la respuesta:
aws bedrock-runtime converse \
  --cli-input-json file://bounded-request.json \
  > bounded-reply.json
Inspecciona el resultado:
python3 -m json.tool bounded-reply.json
Compara usage.outputTokens con el máximo de 384. stopReason: "end_turn" indica un final normal; "max_tokens" indica que se alcanzó el límite, por lo que el texto puede estar incompleto. Nunca supongas que una respuesta parcial es un documento terminado.
AWS View muestra el mismo uso y los créditos restantes. Los créditos reflejan consumo de entrada y salida específico del modelo; contar tokens no establece un precio universal entre modelos. Una solicitud repetida puede usar un resultado del modelo en caché: puede haber uso de tokens sin reducción de créditos. El límite acota una solicitud, pero uno menor no garantiza que esta respuesta breve consuma menos tokens que todas las anteriores.
Si una solicitud falla o su uso es incierto, inspecciona el error antes de reintentar. Una solicitud incierta puede conservar cuota reservada y otra solicitud puede consumir más. Más adelante aprenderás a tratar estos casos en la aplicación.
Limpia los archivos del ejercicio
En este paso eliminarás los archivos locales de solicitud y respuesta después de revisar los borradores.
Converse envía una solicitud de inferencia; no crea un servidor o una base de datos que debas borrar. Los seis archivos JSON son resultados locales del ejercicio. Eliminarlos no revierte el uso de tokens ni devuelve créditos consumidos.
rm elimina los archivos nombrados. Utiliza los nombres exactos siguientes y conserva los demás archivos del proyecto:
rm request.json reply.json revised-request.json revised-reply.json bounded-request.json bounded-reply.json
Lista las entradas visibles que quedan en el espacio de trabajo:
ls
Los seis archivos deben haber desaparecido. AWS View conserva los resultados reales de solicitudes completadas de esta VM, incluido su uso. Borrar un archivo local no convierte una solicitud fallida en exitosa ni elimina su consumo.
Resumen
Enviaste solicitudes reales de texto con Bedrock Converse, refinaste instrucciones del sistema, inspeccionaste respuestas y uso de tokens, limitaste la salida y eliminaste los archivos locales. También distinguiste un borrador plausible de un hecho empresarial verificado: toda respuesta debe revisarse antes de utilizarse.
Para ampliar este tema, consulta la referencia de AWS: Mensajes, instrucciones y ajustes de inferencia de Converse; Contenido, motivos de parada y uso de la respuesta Converse.