Introducción
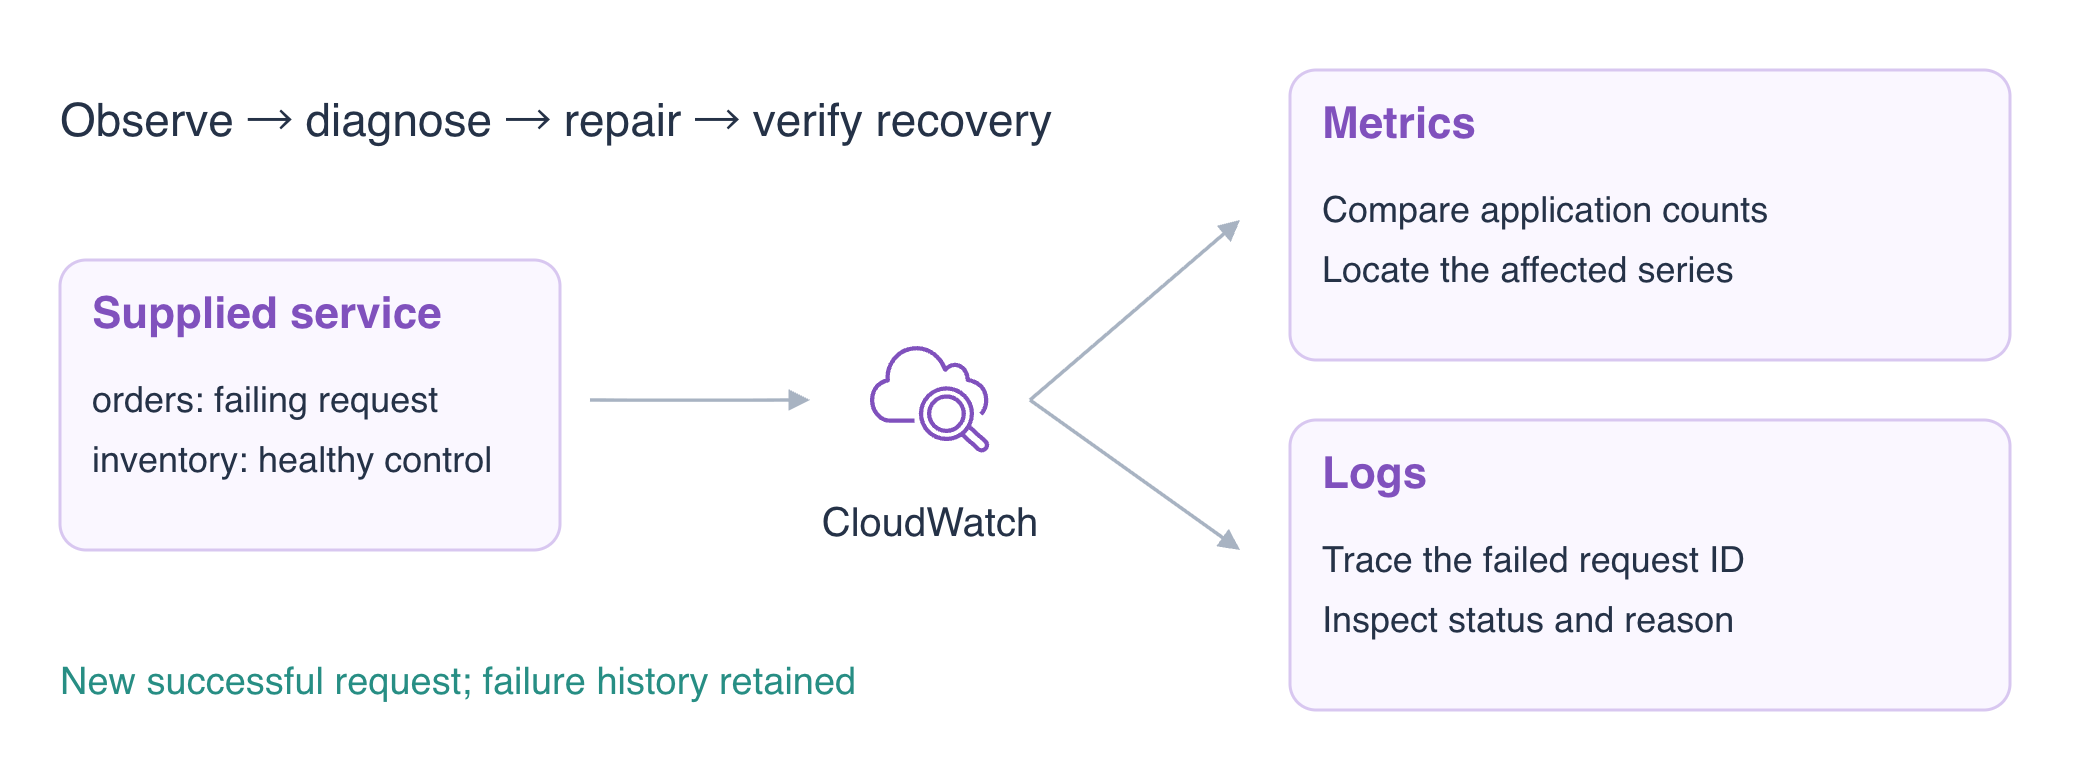
Los pedidos válidos fallan mientras una solicitud de inventario tiene éxito. Compararás métricas de aplicación, rastrearás una solicitud fallida en los registros, corregirás un pequeño fallo de configuración y confirmarás la recuperación sin borrar el historial de fallos.
Completa primero Encontrar una solicitud fallida en CloudWatch Logs y Medir la salud de una aplicación con métricas de CloudWatch. Este laboratorio proporciona su propia aplicación e incidente.
Relación con las certificaciones
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Tarea 1.2 | Diagnóstico de fallos de aplicación mediante registros y métricas. |
| Developer – Associate (DVA-C02) | Tarea 4.1 | Diagnóstico de fallos de aplicación mediante registros y métricas. |
| DevOps Engineer – Professional (DOP-C02) | Tarea 5.3 | Práctica de fundamentos: Diagnóstico de fallos de aplicación mediante registros y métricas. |
| Solutions Architect – Professional (SAP-C02) | Tarea 3.1 | Práctica de fundamentos: Diagnóstico de fallos de aplicación mediante registros y métricas. |
| Data Engineer – Associate (DEA-C01) | Tarea 3.3 | Práctica de fundamentos: Diagnóstico de fallos de aplicación mediante registros y métricas. |
Vista general del laboratorio
Reproducir el incidente y comparar un control
En este paso, reproducirás una solicitud de pedido válida que falla inesperadamente. El servicio preparado de forma independiente tiene un fallo de configuración ordinario. Sus registros y métricas comienzan vacíos, por lo que las observaciones proceden de tus propias solicitudes.
cd /home/labex/project
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-failure-1' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-failure-2' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-control' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/inventory
Espera dos respuestas de orders HTTP 503 stock_unavailable y una respuesta de inventory HTTP 200 accepted para la misma solicitud sintética válida de apple. El control sugiere un problema específico de orders; no demuestra que todo el sistema esté sano.
Usa una ventana UTC reciente y dimensiones Application exactas para comparar recuentos de errores del servidor. Una métrica resume la frecuencia, mientras que los registros individuales pueden explicar una respuesta específica.
START=$(date -u -d '15 minutes ago' +%Y-%m-%dT%H:%M:%SZ)
echo "$START"
Guarda la hora de fin de la consulta en UTC:
END=$(date -u -d '1 minute' +%Y-%m-%dT%H:%M:%SZ)
echo "$END"
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=inventory \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
Espera Sum 2 para orders y Sum 0 para inventory al sumar los intervalos devueltos. Mantén /labex/o05-reference sin cambios.
Relacionar el recuento de errores con los registros de solicitudes
En este paso, relacionarás el síntoma resumido con solicitudes fallidas concretas. Consulta primero ERROR y después el ID exacto de solicitud. Una frase entre comillas coincide con el token request_id completo; evita mezclar solicitudes de nombres similares.
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern ERROR \
  --query 'events[].{Time:timestamp,Message:message}'
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern '"request_id=o05-failure-1"' \
  --query 'events[].message'
Ambos fallos identifican application=orders, status 503 y reason stock_unavailable. Las métricas y los registros abarcan las mismas solicitudes en la ventana reciente. Inspecciona la configuración de la aplicación para localizar la discrepancia con la solicitud válida de apple.
cat app.json
accepted_sku es pear para orders. Inventory utiliza de forma independiente la configuración esperada apple. Es un pequeño fallo de configuración; sustituir el servicio o deshabilitar la observación ocultaría el síntoma sin corregirlo.
La solicitud fallida pedía apple, mientras que la configuración de orders acepta pear. Esa diferencia es una explicación comprobable de stock_unavailable; la solicitud correcta a inventory ayuda a acotar el problema. El siguiente paso comprueba esta explicación cambiando la configuración de orders y repitiendo una solicitud válida. La recuperación requiere una respuesta correcta y su nuevo registro correspondiente, no solo editar la configuración.
Corregir la configuración y comprobar la recuperación
En este paso, cambiarás el SKU aceptado y demostrarás que la respuesta de negocio se recupera mientras la telemetría sigue habilitada. Sustituye la configuración ordinaria por la opción corregida.
cat > app.json <<'JSON'
{"logging": {"enabled": true, "group": "/labex/o05-application", "stream": "requests"}, "metrics": {"enabled": true, "namespace": "LabEx/O05"}, "accepted_sku": "apple"}
JSON
curl -i -H 'Content-Type: application/json' -H 'X-Request-ID: o05-recovered' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
aws logs filter-log-events \
  --log-group-name /labex/o05-application \
  --filter-pattern '"request_id=o05-recovered"' \
  --query 'events[].message'
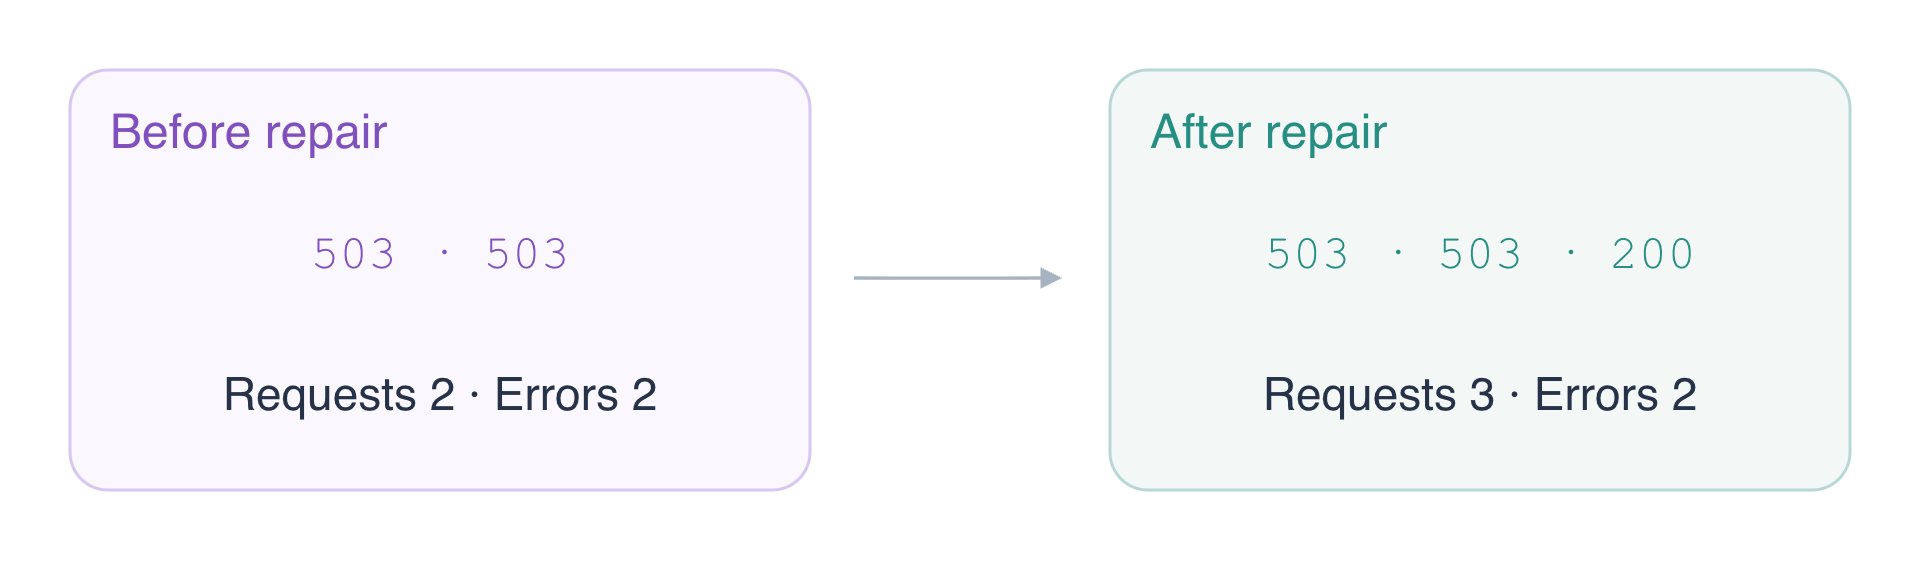
Espera HTTP 200 accepted y un registro INFO para el mismo ID de solicitud recuperada. Los fallos históricos permanecen en la ventana. Una solicitud correcta publica Errors=0, por lo que el Sum acumulado de errores sigue siendo 2 mientras Requests aumenta a 3.
START=$(date -u -d '15 minutes ago' +%Y-%m-%dT%H:%M:%SZ)
echo "$START"
Guarda la hora de fin de la consulta en UTC:
END=$(date -u -d '1 minute' +%Y-%m-%dT%H:%M:%SZ)
echo "$END"
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
aws cloudwatch get-metric-statistics \
  --namespace LabEx/O05 \
  --metric-name Requests \
  --dimensions Name=Application,Value=orders \
  --start-time "$START" \
  --end-time "$END" \
  --period 60 \
  --statistics Sum
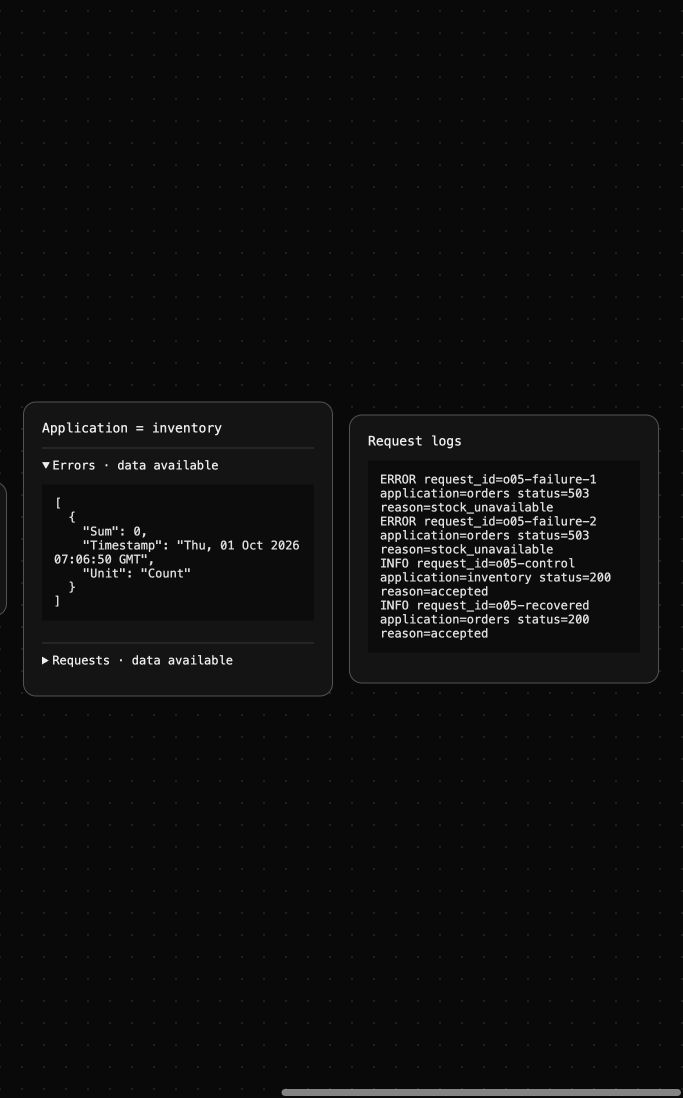
AWS View muestra las series reales de aplicación y los registros de solicitudes. Usa el ID de la solicitud recuperada para distinguir la nueva respuesta correcta del historial de fallos conservado.
Detener la telemetría y limpiar el grupo de registros del laboratorio
En este paso, detendrás la instrumentación y eliminarás únicamente el grupo de registros del incidente. Las métricas existentes permanecen según la retención; no existe una API para eliminar métricas individuales.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o05-application", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O05"}, "accepted_sku": "apple"}
JSON
aws logs delete-log-group --log-group-name /labex/o05-application
aws logs describe-log-groups --query 'logGroups[].logGroupName'
aws logs get-log-events \
  --log-group-name /labex/o05-reference \
  --log-stream-name platform \
  --query 'events[].message'
Espera únicamente /labex/o05-reference y su mensaje original INFO platform reference keep unchanged. El inventario correcto verifica la eliminación específica; las consultas fallidas no demostrarían la limpieza.
Resumen
Reprodujiste un incidente con un control, relacionaste los recuentos de métricas con los registros de solicitudes, corregiste una configuración de la aplicación, verificaste una nueva respuesta correcta y conservaste la evidencia histórica hasta la limpieza específica.
Para ampliar este tema, consulta la referencia de AWS: Identidad de métricas, dimensiones y estadísticas; Filtrar eventos de registro por términos y frases exactas.