Introducción
Crea una alarma de errores reales, publica un perfil inválido y restaura el sitio y el estado OK.
Completa antes los laboratorios anteriores del portafolio. Este laboratorio proporciona sus propios recursos y las capacidades de las etapas previas. Conserva conocimientos, no servidores, archivos ni credenciales anteriores.
Relación con la certificación
| Certificación | Tareas | Práctica |
|---|---|---|
| AWS Certified Cloud Practitioner (CLF-C02) | Task 3.8 | Observar fallos y recuperación mediante métricas, alarmas y logs. |
Vista general
Configura una alarma de errores
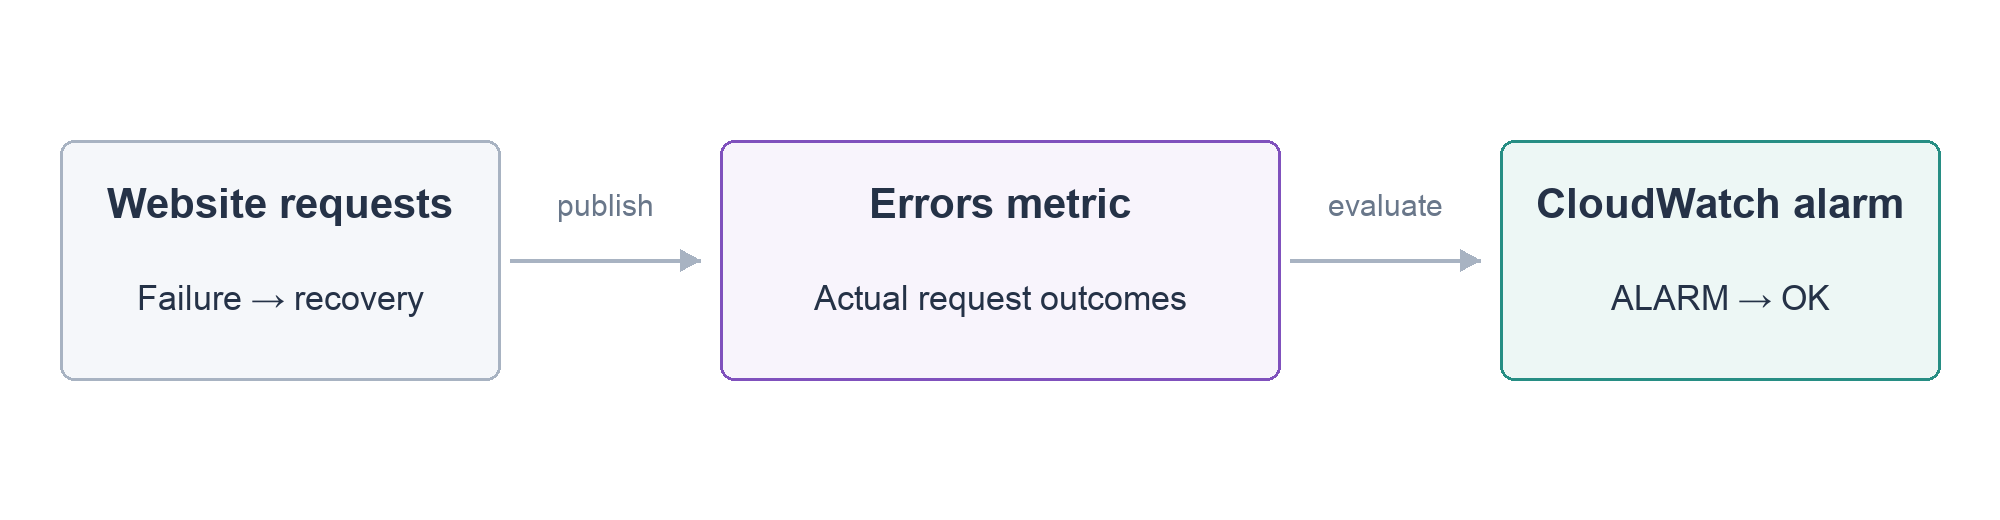
En este paso, crearás una alarma sobre datos de solicitudes reales. Primero abre el sitio sano. Una métrica mide valores en el tiempo; namespace agrupa métricas y dimensions identifican la aplicación. Errors en LabEx/Portfolio, Application=portfolio, recibe 1 por fallo y 0 por éxito. La alarma compara valores con un umbral; no repara el sitio. La métrica Errors de este ejercicio cuenta solo solicitudes de la página /website. Las solicitudes de imágenes y otros archivos son eventos separados en los logs.
Entra en el proyecto.
cd /home/labex/project
Carga y muestra el ID del servidor.
source website.env
echo "$INSTANCE_ID"
Lee la configuración: Sum suma errores, Period=10 evalúa diez segundos, EvaluationPeriods=1 usa un periodo y GreaterThanThreshold con 0 detecta errores. TreatMissingData=missing no considera sano el tráfico ausente. La integración publica datos de alta resolución de un segundo; no se configuran notificaciones.
cat website-alarm.json
Crea la alarma desde el archivo preparado.
aws cloudwatch put-metric-alarm --cli-input-json file://website-alarm.json
Lee su estado.
aws cloudwatch describe-alarms --alarm-names portfolio-errors
INSUFFICIENT_DATA puede ser inicial: aún faltan datos evaluados. AWS View muestra el mismo estado. No lo cambies manualmente.
Observa una publicación fallida
En este paso, reproducirás un perfil inválido y su efecto real, conservando servidor, red y permisos.
Lee profile-broken.json: contiene JSON inválido que la aplicación no puede interpretar.
cat profile-broken.json
Publica por SCP en la misma ruta del perfil.
scp -F ssh_config profile-broken.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
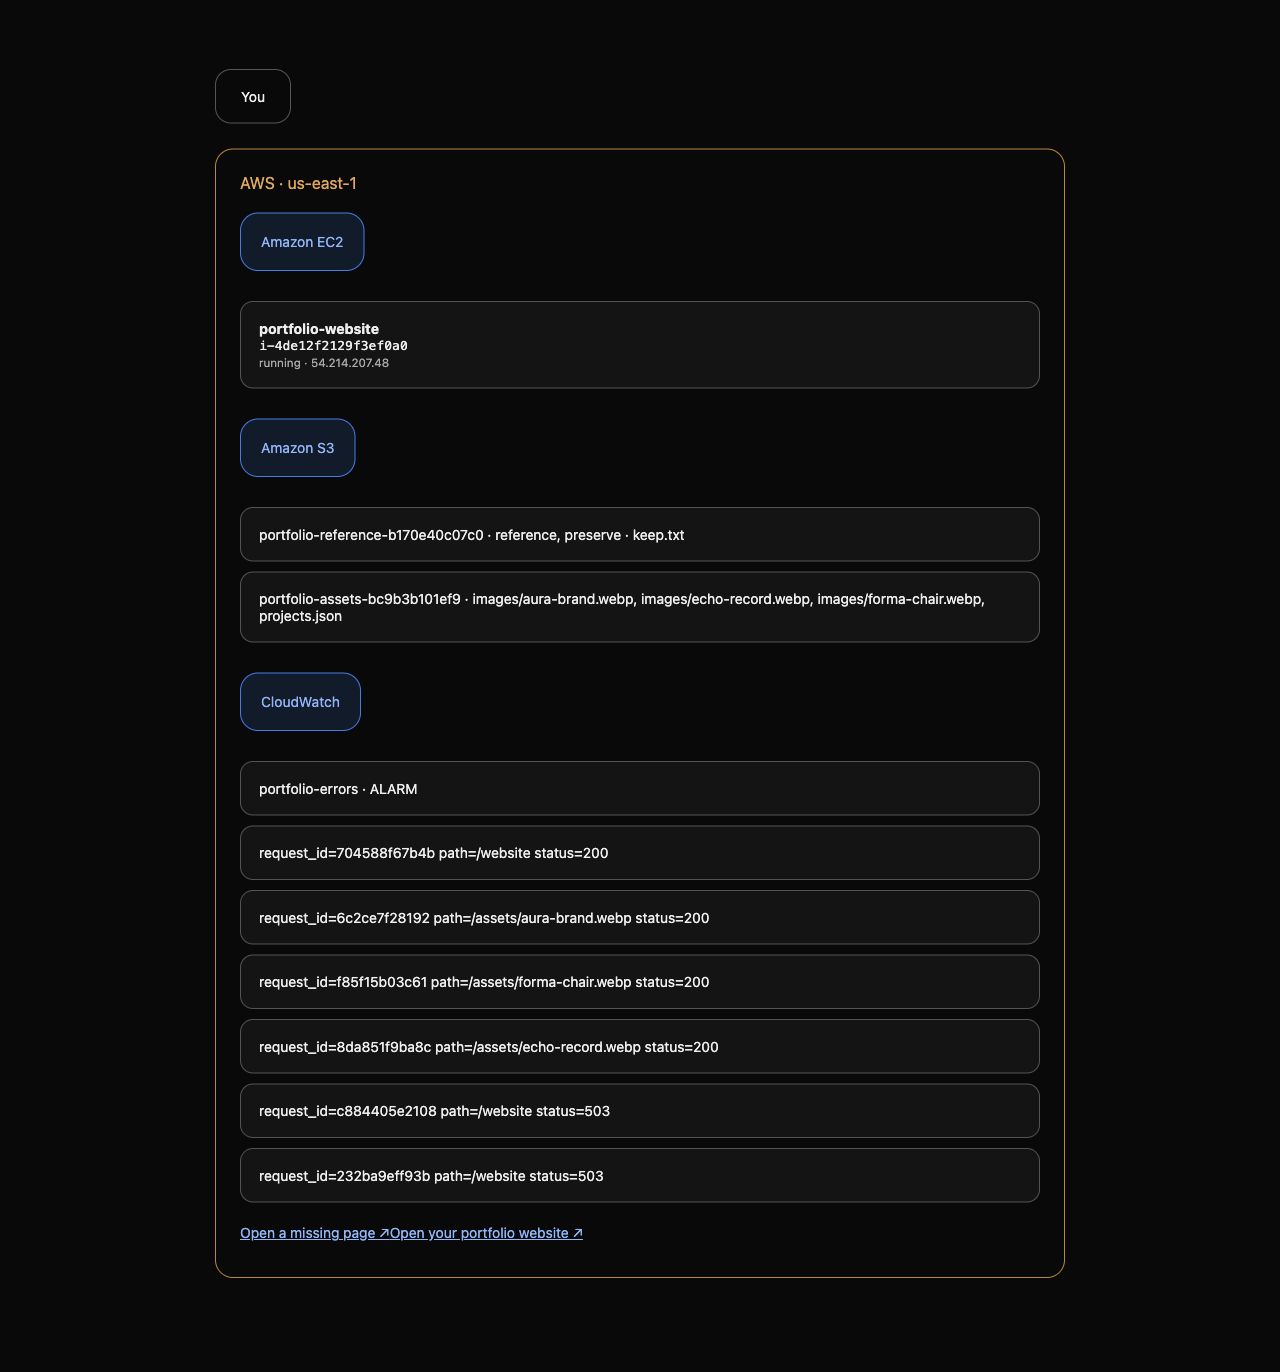
Recarga el sitio: Website unavailable, mientras EC2 sigue running. Filtra 503 y encuentra path=/website status=503; correlaciónalo con la publicación reciente. El patrón es una frase exacta: las comillas simples exteriores conservan las comillas dobles interiores.
aws logs filter-log-events --log-group-name "$LOG_GROUP" --filter-pattern '"status=503"'
Espera un periodo de diez segundos y vuelve a solicitar la página fallida si hace falta; después lee la alarma.
aws cloudwatch describe-alarms --alarm-names portfolio-errors
Confirma ALARM. Si falta información, genera otra solicitud real y permite evaluación. Un log antiguo no es un dato métrico reciente.
Restaura el sitio y comprueba recuperación
En este paso, publicarás un perfil válido y verificarás respuesta y alarma, no solo transferencia de archivo.
Lee el perfil conocido con tres campos válidos.
cat profile-working.json
Publícalo en la misma ruta.
scp -F ssh_config profile-working.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
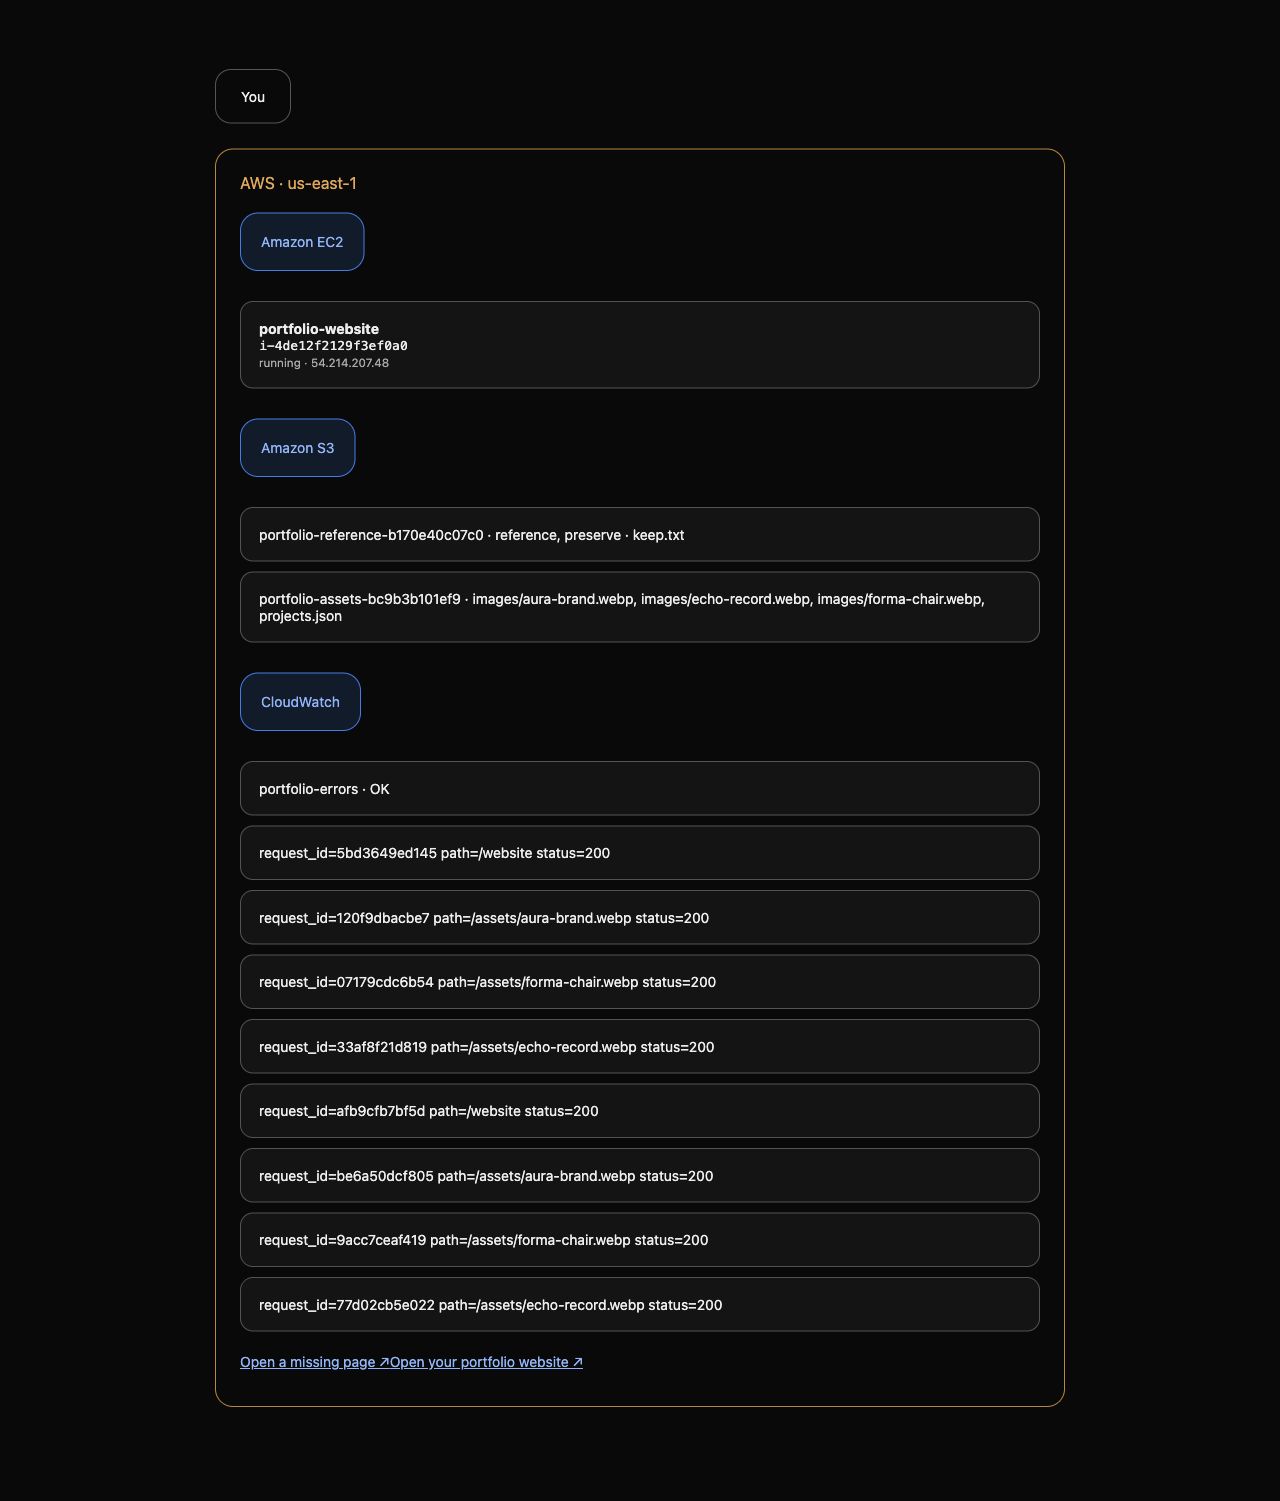
Recarga y confirma Alex Morgan y la imagen S3; encuentra un evento reciente path=/website status=200. El patrón es una frase exacta: las comillas simples exteriores conservan las comillas dobles interiores.
aws logs filter-log-events --log-group-name "$LOG_GROUP" --filter-pattern '"status=200"'
Da al tráfico sano un nuevo periodo, repite la página si hace falta y consulta la alarma.
aws cloudwatch describe-alarms --alarm-names portfolio-errors
Confirma OK. Los eventos 503 antiguos permanecen. Sin solicitudes, missing puede devolver INSUFFICIENT_DATA, distinto de tráfico sano comprobado; mantén solicitudes correctas recientes durante la comprobación.
Elimina los recursos de monitorización
En este paso, limpiarás después de confirmar la recuperación.
Termina el servidor.
aws ec2 terminate-instances --instance-ids "$INSTANCE_ID"
Espera terminated.
aws ec2 wait instance-terminated --instance-ids "$INSTANCE_ID"
Elimina solo portfolio-errors.
aws cloudwatch delete-alarms --alarm-names portfolio-errors
Elimina el grupo de logs del ejercicio.
aws logs delete-log-group --log-group-name "$LOG_GROUP"
Conserva S3, rol, red y eventos de referencia. Borrar una alarma no borra métricas; el servidor terminado deja de producir muestras nuevas. Continúa con AWS Resource Management for Beginners.
Resumen
Configuraste la alarma, observaste solicitudes 503 y ALARM, restauraste el perfil y confirmaste solicitudes 200 y OK.
Referencias oficiales: CloudWatch alarms, high-resolution custom metrics.