Introducción
La tienda necesita un resumen mensual compartible como CSV. Calcula con Athena, recupera la salida real S3 y corrige una venta para producir otro resumen. Compara ambos para entender la relación con la entrada al ejecutar.
Completa Query Partitioned Sales Data. El entorno independiente proporciona dos archivos S3, ambas particiones Glue, identidad AWS y un September corregido local. No necesitas cuenta personal ni recursos anteriores. Usa la CLI oficial en Terminal e inspecciona archivos, catálogo y resultados en AWS View.
Relación con la certificación
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Analizar S3 con Athena y Glue y recuperar resultados calculados. |
Calcular el resumen mensual
En este paso, calcula sobre los archivos actuales. Glue registra esquema y ubicaciones; Athena lee y agrupa por mes. Cada ejecución tiene ID y archivo propios.
Entra al proyecto y verifica identidad:
cd /home/labex/project
aws sts \
  get-caller-identity
El ARN termina en labex-an04-operator. jq -r extrae cadenas JSON y $(...) guarda salidas en variables:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
Comprueba las ubicaciones registradas:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Ambos meses están registrados. Sumar centavos enteros en total_cents evita redondeos monetarios. COUNT(*) cuenta pedidos, GROUP BY month agrupa y ORDER BY month facilita comparar. El heredoc citado escribe SQL literal:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Envía con base y prefijo S3. file:// lee SQL local; --query y --output text de la CLI extraen el ID:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
Repite para QUEUED o RUNNING, continúa en SUCCEEDED y revisa Reason con FAILED:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
La proyección anidada [*] mantiene las columnas de cada fila:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
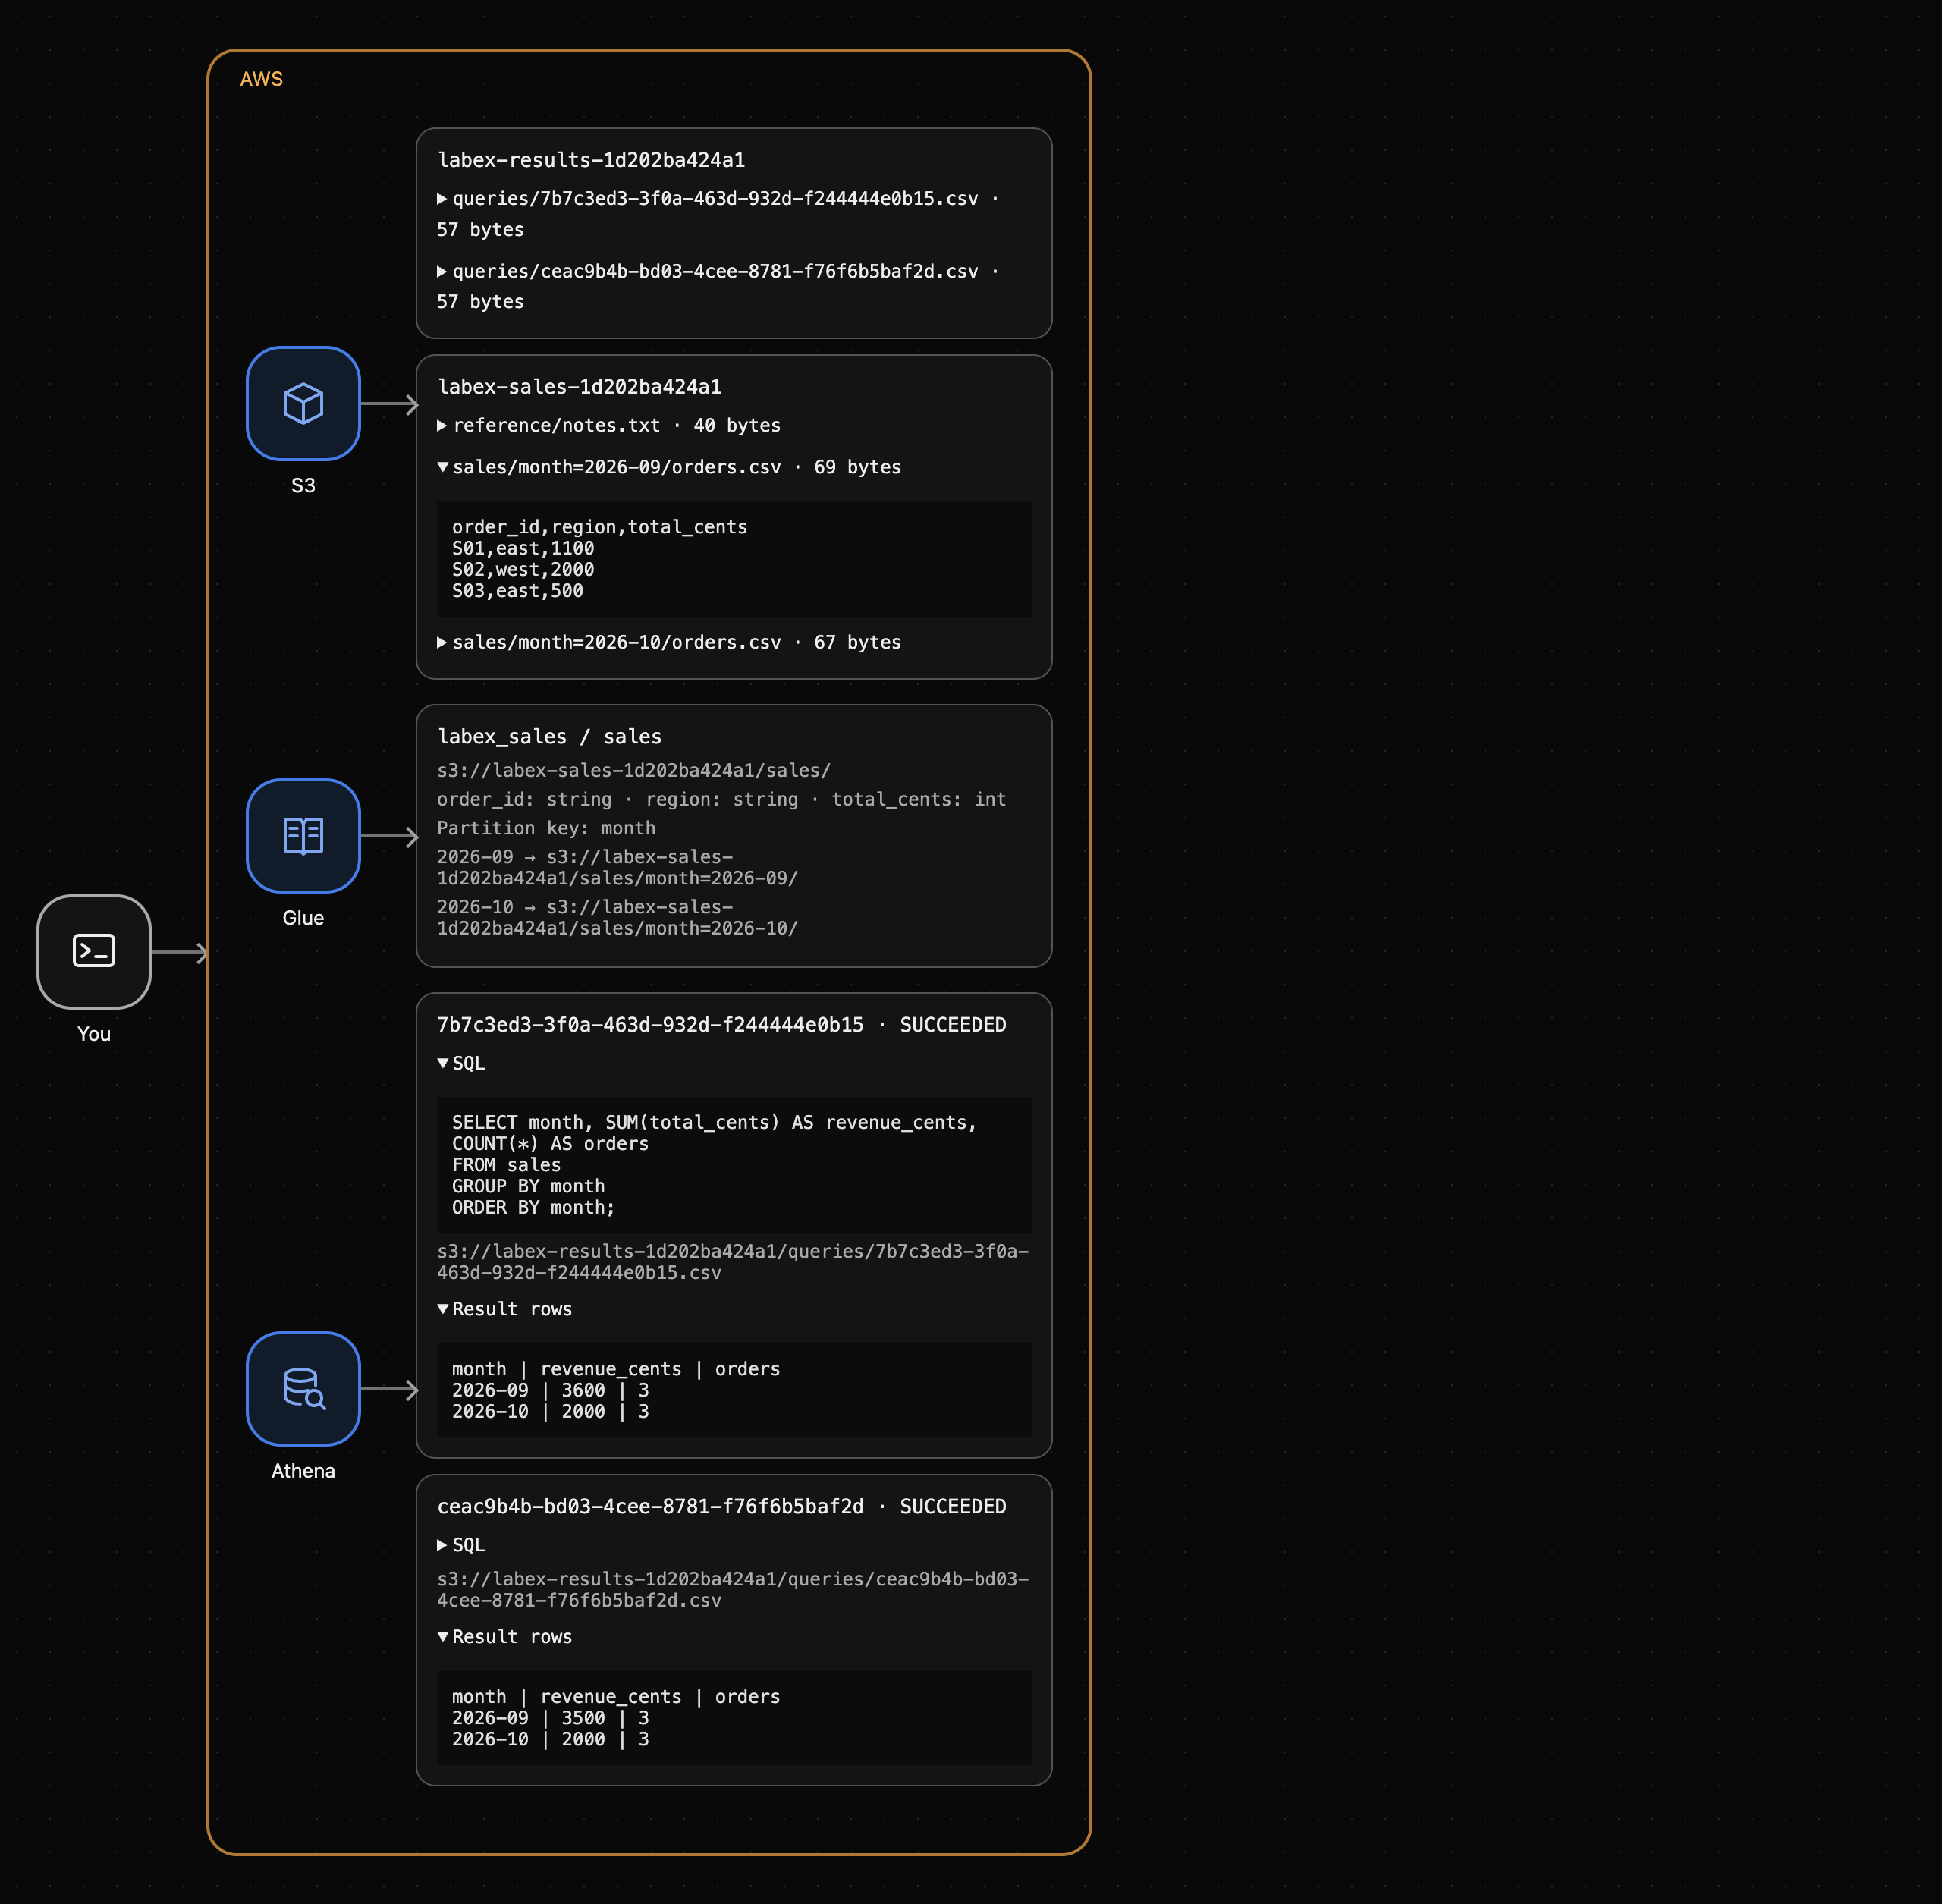
September tiene 3500 centavos/3 pedidos y October 2000/3. Expande SQL y filas en AWS View y compara con las ubicaciones mensuales.
Descargar el resultado S3 real
En este paso, recupera el CSV de esta ejecución. La API muestra filas; los metadatos dan el destino S3 exacto. Léelo sin adivinar bucket ni ID.
Extrae y muestra el URI:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
Termina en /queries/<your-execution-id>.csv. El ID vincula archivo y consulta. Descarga a summary.csv:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
Inspecciona el contenido:
cat summary.csv
Cabecera y dos registros:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
Coinciden con la API. Es un archivo real descargado, no un informe escrito a mano. Conserva summary.csv y la salida S3 original para comparar.
Recalcular tras corregir la entrada
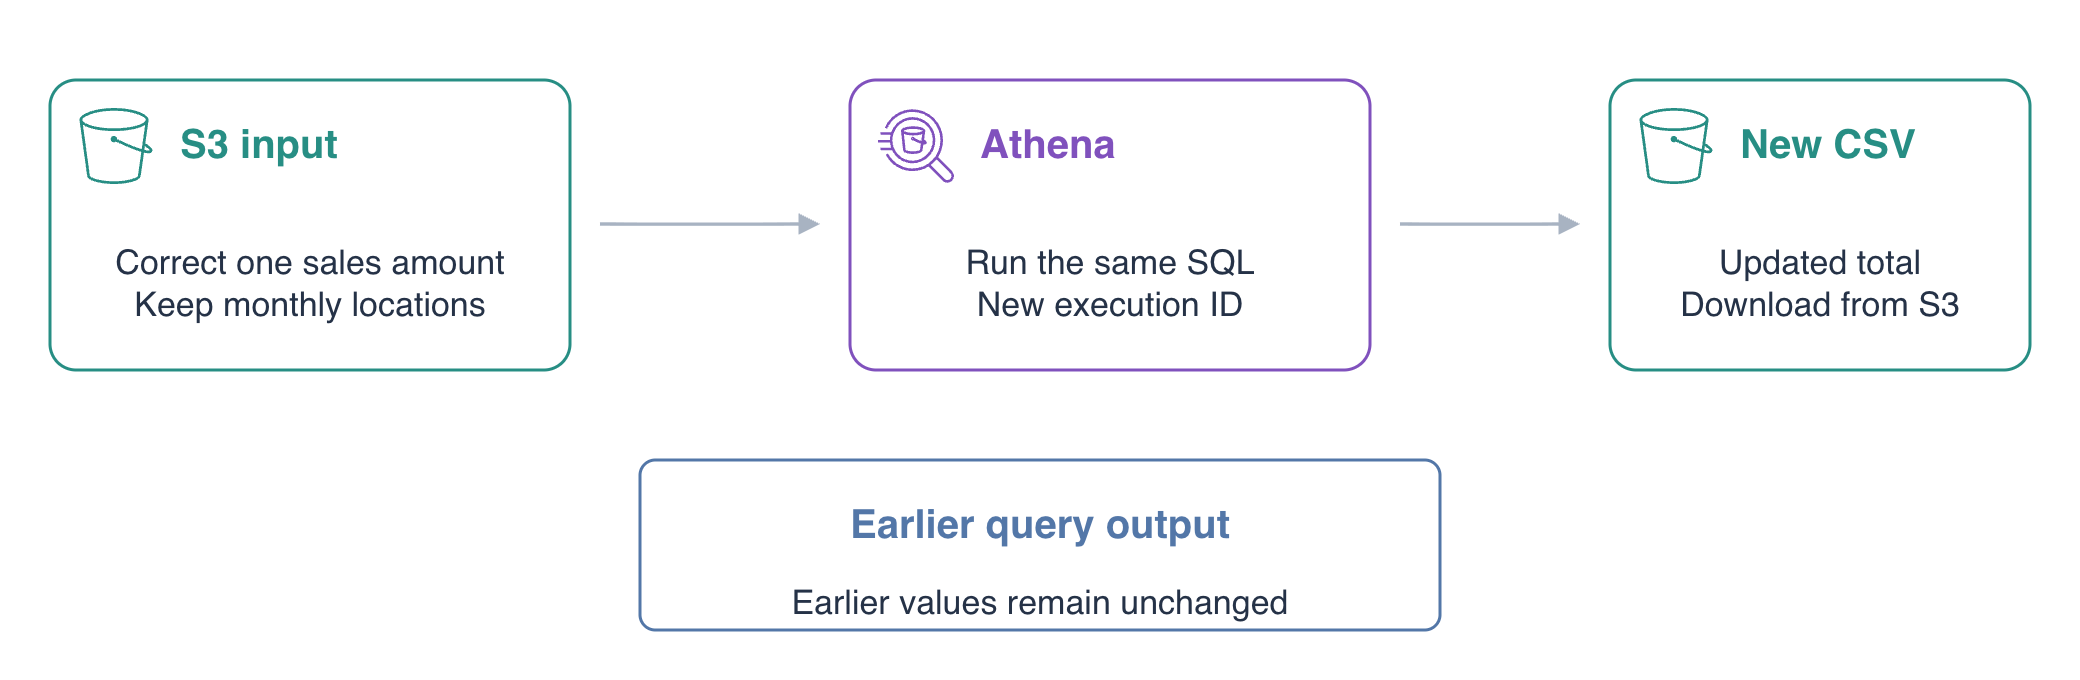
En este paso, corrige una cantidad de September y ejecuta el mismo SQL. Un resultado anterior no se actualiza automáticamente; otra ejecución debe leer la entrada actual.
Inspecciona la corrección:
cat september-revised.csv
S01 pasa de 1000 a 1100 centavos, el resto sigue igual: total esperado 3600. Sustituye el objeto September conservando October y reference/notes.txt:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
Lee de nuevo para comprobar:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
El - final imprime el objeto. Lugar y esquema no cambian, por lo que Glue sigue válido. Ejecuta el mismo SQL con un ID nuevo:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
Confirma éxito, repite si está pendiente y examina fallos:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Recupera filas:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September ahora es 3600/3, October sigue 2000/3. La corrección cambió el cálculo.
Lee la salida propia de esta ejecución:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
Descarga sin sobrescribir el resumen local original:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
Inspecciona el nuevo CSV:
cat summary-revised.csv
Compara con la salida original S3:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
La anterior mantiene September=3500. Dos ID apuntan a archivos separados de la entrada antigua y corregida. AWS View muestra origen actual y ambas filas reales. Compruebas corrección, no costes ni rendimiento de producción.
Resumen
Calculaste totales, descargaste el CSV exacto, corregiste la entrada y recalculaste. September cambió de 3500 a 3600 centavos y October siguió 2000. Las salidas anteriores conservan sus valores: vuelve a ejecutar al cambiar la entrada.
Para ampliar este tema, consulta la referencia de AWS: Localizar archivos de salida por ejecución de consulta; Filtros, grupos y ordenación de SELECT.