Introducción
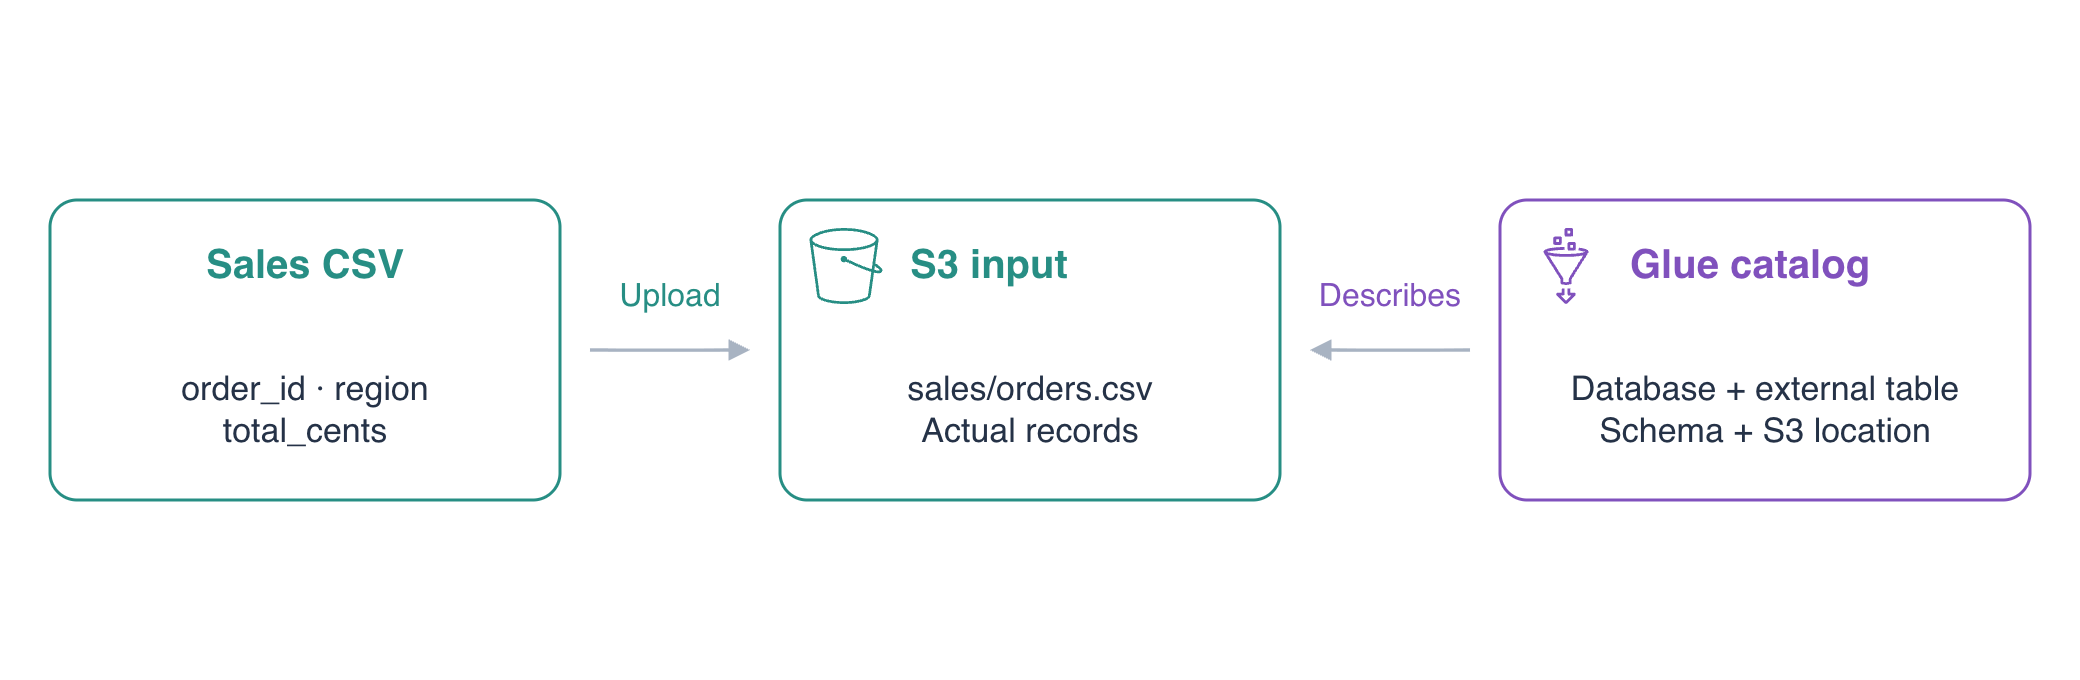
Una tienda exporta sus ventas a CSV. Un analista necesita consultar esos archivos sin copiarlos a un servidor de bases de datos. Guarda el archivo en Amazon S3 y descríbelo en AWS Glue Data Catalog, un directorio de metadatos que indica a los servicios de consulta dónde están los datos y cómo leerlos.
Completa AWS Foundations for Beginners, operaciones básicas de S3 e identidad IAM. Este entorno independiente proporciona buckets vacíos, CSV y una identidad AWS CLI configurada; no requiere cuenta personal ni recursos de otro laboratorio. Usa Terminal para comandos y AWS View para observar objetos y catálogo reales. El catálogo describe archivos: no copia, transforma ni consulta su contenido. Athena se usa en el siguiente laboratorio.
Relación con la certificación
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Distinguir el catálogo de Glue para análisis de archivos del almacenamiento de datos en S3. |
Subir el archivo de ventas
En este paso, revisa los datos suministrados y súbelos a S3. Un CSV representa un registro por línea, con campos separados por comas. La primera línea contiene los nombres. Un esquema define nombres, orden y tipos para interpretar correctamente los registros.
Entra en el directorio del proyecto y comprueba la identidad configurada:
cd /home/labex/project
aws sts \
  get-caller-identity
El ARN termina en labex-an01-operator. Usarás los recursos S3 y Glue de esa identidad. Examina September:
cat september.csv
Los tres registros tienen order_id, region y total_cents. Los dos primeros son cadenas; el importe es un entero en céntimos. 1000, 2000 y 500 suman 3500. El archivo usa valores sin comillas y una línea de cabecera.
El entorno nuevo proporciona un bucket de entrada único. jq -r extrae un campo JSON como texto y $(...) guarda la salida en una variable. Guarda y muestra el nombre:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
Sube a sales/orders.csv. El prefijo sales/ agrupa los datos que leerá la tabla:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
Lee directamente el objeto subido:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
El - final imprime el objeto S3. Cabecera y tres registros deben coincidir con september.csv. Abre AWS View, expande el objeto y compara el contenido. Conserva reference/notes.txt, que está fuera de sales/.
Crear una base de datos del catálogo
En este paso, crea el espacio de nombres de la definición de tabla. Una base de datos Glue agrupa tablas del catálogo y almacena metadatos, sin ejecutar un servidor de bases de datos. Crearla no mueve el archivo S3.
Lee el nombre del inventario:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input acepta la definición JSON normal del nombre y la descripción:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
La creación correcta no imprime cuerpo. Consulta la base de datos para comprobar que existe:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
El nombre es labex_sales y la descripción es la indicada. AWS View muestra la base de datos todavía sin tabla. El archivo S3 sigue en su ubicación original.
Describir el archivo con una tabla externa
En este paso, asigna cada campo CSV a un nombre y tipo, y apunta al prefijo S3 real. Una tabla externa describe datos fuera del catálogo; borrar su definición no elimina por sí mismo los objetos S3.
El descriptor de almacenamiento contiene columnas, ubicación y configuración de lectura. Un SerDe es un serializador/deserializador que interpreta registros como campos. LazySimpleSerDe lee aquí valores sin comillas separados por comas. La cabecera no es una venta: skip.header.line.count omite la primera línea.
Guarda y muestra el prefijo de ubicación:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF escribe el texto hasta el EOF final. El delimitador sin comillas expande $SALES_LOCATION a tu prefijo real:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys está vacío: esta primera tabla lee un único prefijo sin particiones. Las particiones mensuales se introducen después. Las dos clases de formato describen entrada de texto y salida compatible con Hive; no necesitas instalarlas ni ejecutarlas.
Crea la tabla desde JSON. file:// lee la entrada CLI desde un archivo local:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
Lee la definición desde Glue:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
Comprueba el orden de columnas, total_cents de tipo int, la ubicación terminada en /sales/ y cabecera 1. AWS View muestra el objeto S3 junto a la definición Glue.
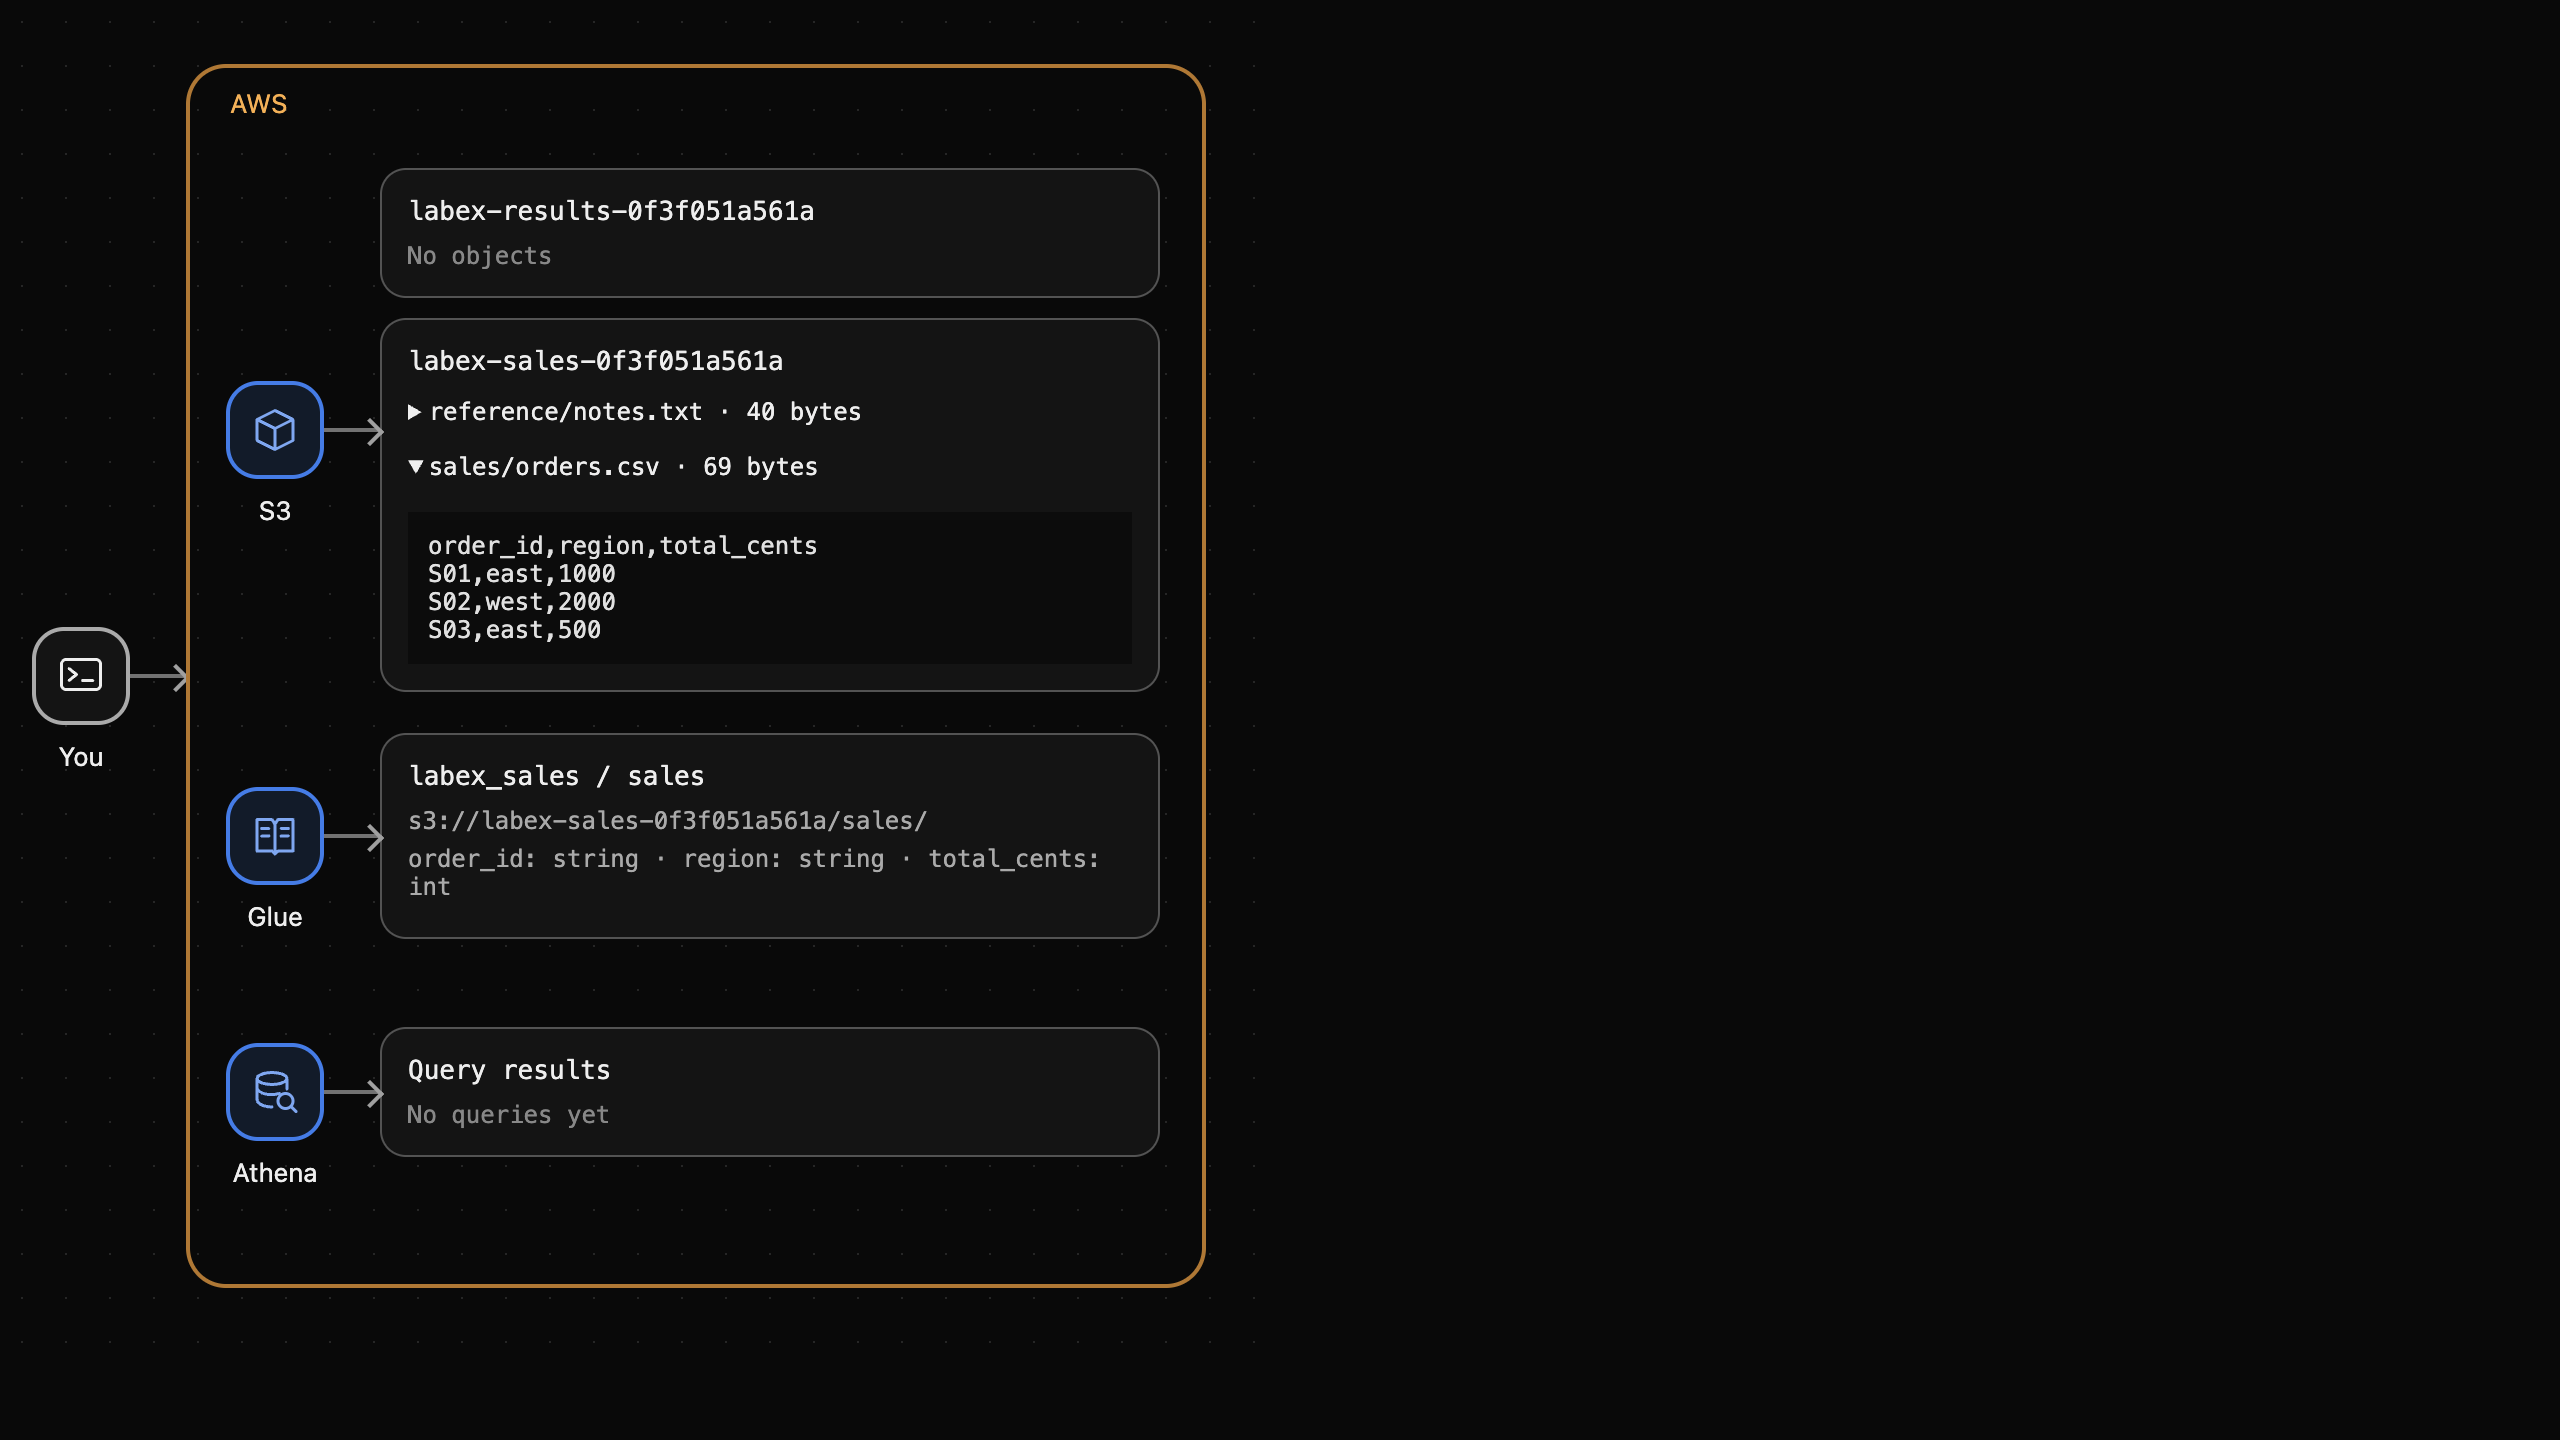
Crear el catálogo no cambia el CSV ni produce un resultado Athena. Un esquema o ubicación incorrectos harían fallar las consultas o leer registros equivocados; los metadatos correctos preparan la siguiente consulta.
Resumen
Subiste ventas reales a S3, creaste una base de datos Glue y definiste una tabla externa con columnas, formato CSV y ubicación coincidentes. S3 guarda datos; Glue, metadatos. El siguiente laboratorio consulta con Athena datos preparados de forma independiente usando este modelo.
Para ampliar este tema, consulta la referencia de AWS: Definir manualmente los metadatos del catálogo; Campos CSV sin comillas y tratamiento del encabezado.