Introducción
Un equipo de operaciones necesita una señal de error que se active cuando fallen las solicitudes y se recupere después de recibir tráfico correcto. Configurarás una alarma de métricas, observarás ambas transiciones a partir de solicitudes reales, compararás el cero con los datos ausentes y eliminarás tus alarmas.
Completa primero Medir la salud de una aplicación con métricas de CloudWatch, incluidas las dimensiones de métricas y Sum. Este laboratorio proporciona una aplicación y series de métricas nuevas.
Relación con las certificaciones
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Tarea 1.1 | Evaluación de alarmas CloudWatch, recuperación y datos ausentes. |
| DevOps Engineer – Professional (DOP-C02) | Tarea 4.2 | Práctica de fundamentos: Evaluación de alarmas CloudWatch, recuperación y datos ausentes. |
| Solutions Architect – Professional (SAP-C02) | Tarea 3.1 | Práctica de fundamentos: Evaluación de alarmas CloudWatch, recuperación y datos ausentes. |
Vista general del laboratorio
Configurar una alarma de métricas
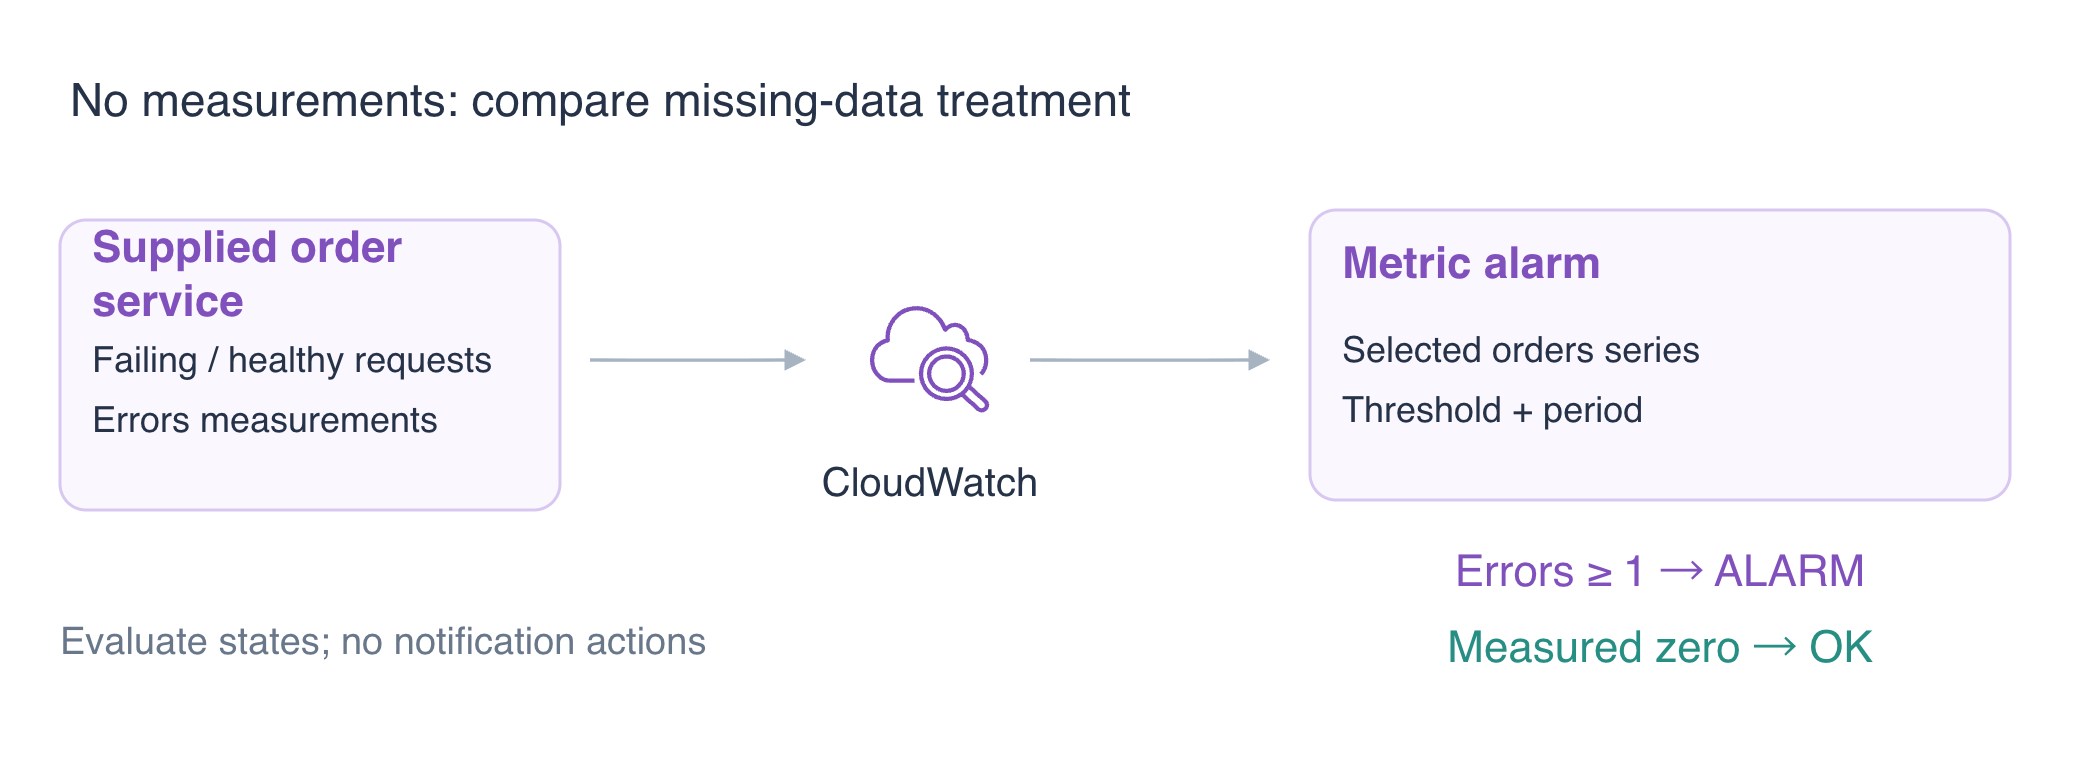
En este paso, vigilarás el recuento de errores del servidor de la aplicación orders. Una alarma evalúa una métrica frente a un umbral e indica OK, ALARM o INSUFFICIENT_DATA. No envía una notificación a menos que se configure una acción; este ejercicio se centra en la evaluación.
La aplicación preparada de forma independiente publica métricas de solicitudes reales. Su métrica Errors vale uno para HTTP 5xx y cero para una solicitud correcta. La publicación de alta resolución permite un periodo de 10 segundos para observar varios periodos rápidamente. Los periodos y umbrales de producción dependen de la carga de trabajo y del coste.
cd /home/labex/project
Crea una alarma de una sola métrica. El espacio de nombres, el nombre y las dimensiones seleccionan la serie; Sum cuenta los errores de cada periodo completo.
La alarma evalúa un periodo completo de 10 segundos (--period 10, --evaluation-periods 1). Un Sum de al menos 1 alcanza el umbral; GreaterThanOrEqualToThreshold significa «mayor o igual». notBreaching considera que un periodo sin mediciones no supera el umbral. Esto mantiene los periodos sin actividad en OK, pero no demuestra la salud de la aplicación.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
Lee la alarma a continuación. Si la evaluación sigue pendiente, espera unos segundos y repite este comando de lectura hasta que indique OK.
El OK inicial se debe al tratamiento de datos ausentes, no a una comprobación de salud correcta. Inspecciona el motivo evaluado:
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
Mantén /labex/o03-reference sin cambios. Cada laboratorio comienza de forma independiente; no se necesitan datos de métricas anteriores.
Activar la alarma con fallos reales
En este paso, generarás solicitudes fallidas reales y esperarás la evaluación automática. Un periodo completo excluye los puntos del periodo actual incompleto; observar la respuesta HTTP y el estado de la alarma son observaciones distintas.
pear no está disponible en el servicio suministrado. El bucle envía nueve solicitudes separadas por dos segundos para abarcar varios periodos de 10 segundos. for repite los comandos; sleep 2 hace una pausa entre solicitudes. curl sin -f devuelve el cuerpo de la respuesta incluso para HTTP 503, lo que permite observar el fallo.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Lee el estado evaluado. Si todavía no ha llegado a ALARM, espera unos segundos y repite este comando. StateReasonData es JSON almacenado como una cadena, por lo que sus comillas aparecen escapadas en la respuesta; recentDatapoints enumera las sumas de los periodos evaluados.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
Espera ALARM y un valor de recentDatapoints de al menos 1 en StateReasonData. Si la evaluación sigue mostrando el periodo anterior, espera unos segundos y repite el comando de lectura. El estado sigue los puntos de datos derivados de solicitudes reales; no establezcas manualmente el estado de la alarma. La alarma vigila únicamente orders, por lo que la serie de otra aplicación no entra en esta evaluación.
Para el equipo de pedidos, ALARM indica si el período seleccionado contiene fallos del servidor. No explica qué solicitud falló ni por qué no había existencias. La respuesta HTTP demuestra el fallo de negocio, el punto de datos evaluado demuestra la transición de la alarma y los registros aportan detalles para el diagnóstico. Distingue estas observaciones al decidir qué investigar.
Observar la recuperación y los datos ausentes
En este paso, distinguirás un cero real de la telemetría ausente. Envía solicitudes correctas de apple para que los periodos completos contengan Errors=0 medido. Repetirlas a lo largo de varios periodos evita confundir el intervalo actual incompleto con la recuperación.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Lee el estado evaluado. Si todavía no ha llegado a OK, espera unos segundos y repite este comando.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
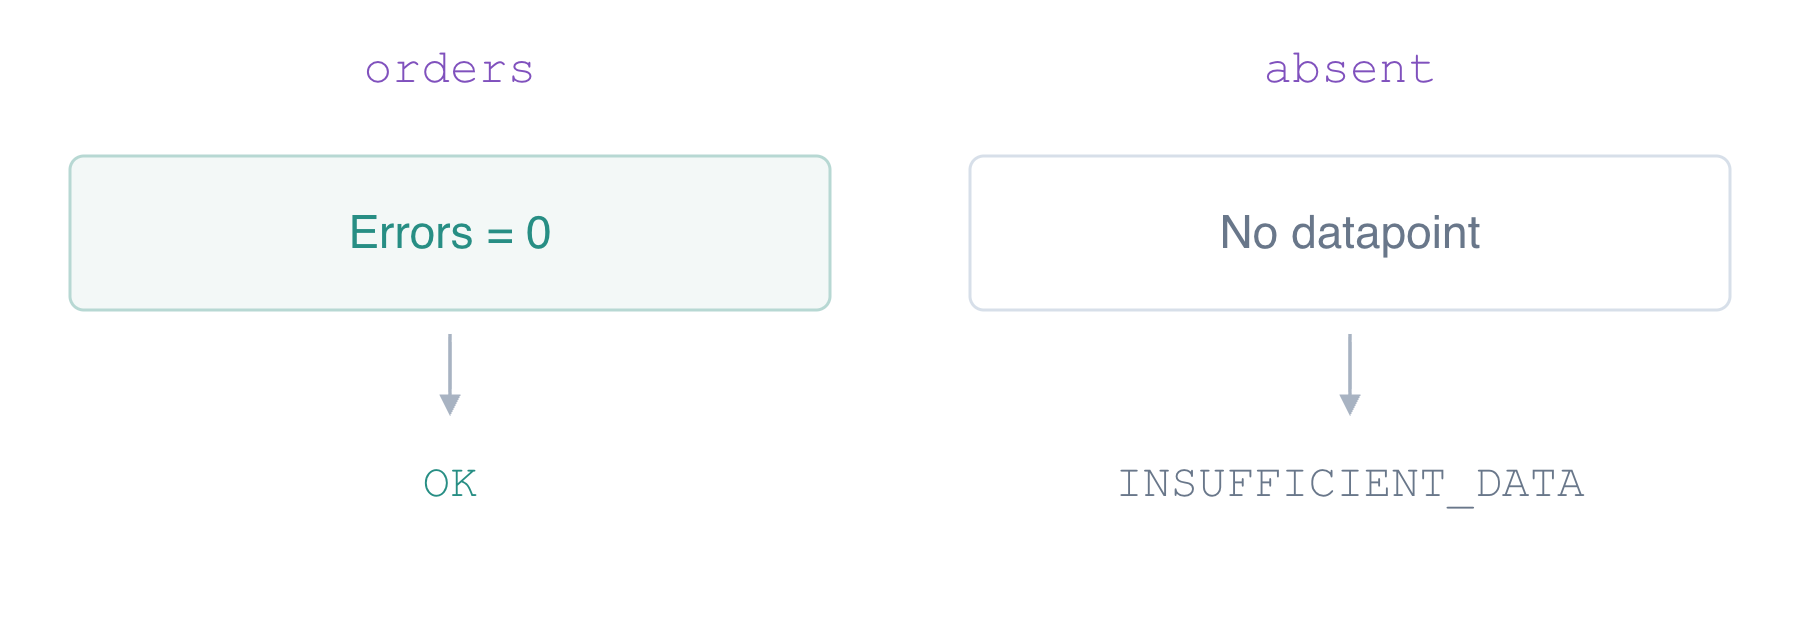
Espera OK con recentDatapoints: [0]. Una lista vacía significa telemetría ausente, así que confirma el cero medido antes de continuar.
Crea una alarma independiente para Application=absent, una serie que la aplicación nunca publica. Trata los datos ausentes como ausentes en lugar de considerarlos saludables.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
La alarma nueva debe permanecer en INSUFFICIENT_DATA porque su serie seleccionada no tiene mediciones.
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
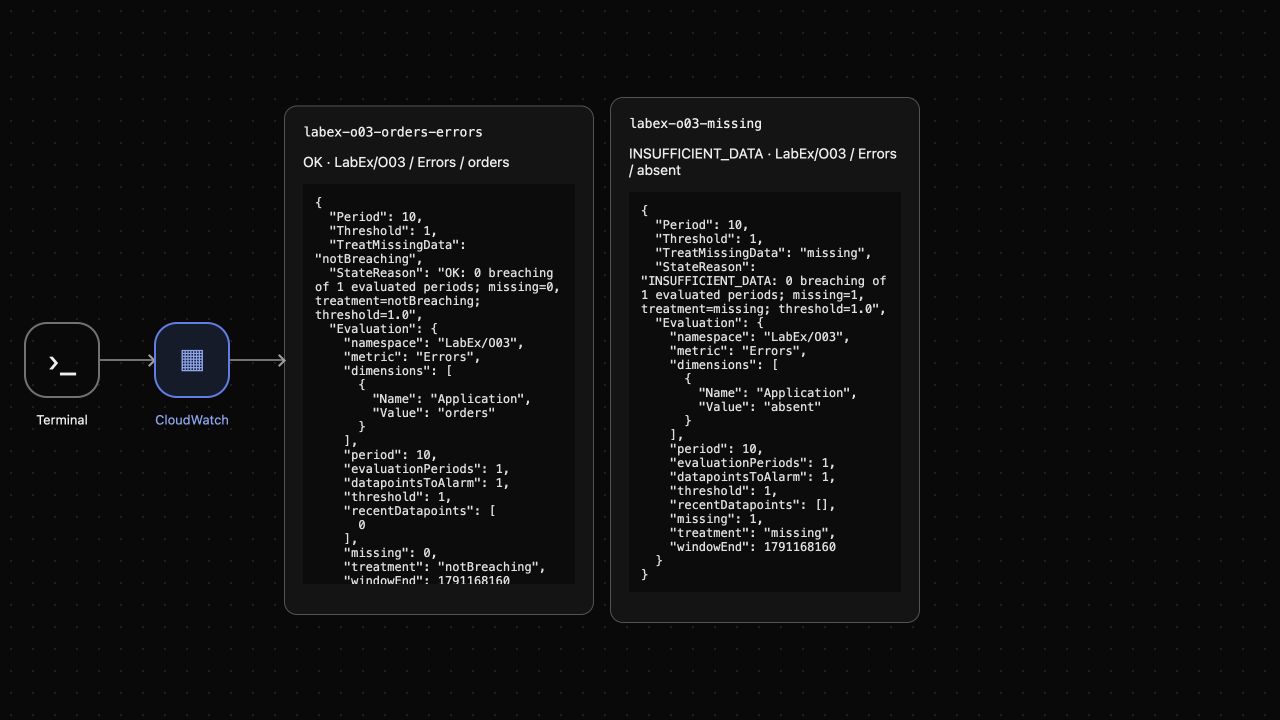
Espera orders en OK por el cero medido y absent en INSUFFICIENT_DATA. Usa el motivo evaluado para distinguir el cero medido de la telemetría ausente.
AWS View muestra el estado real del servicio y los puntos de datos evaluados. Compara los motivos en lugar de considerar cada OK como prueba de la salud de la aplicación.
Eliminar las alarmas del laboratorio y detener la publicación
En este paso, eliminarás únicamente las alarmas de este laboratorio y conservarás los datos ajenos. Deshabilita la instrumentación antes de la limpieza para que la aplicación deje de publicar puntos nuevos.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
Espera un inventario vacío de alarmas e INFO platform reference keep unchanged. Los puntos de métricas existentes se conservan; CloudWatch no tiene una API explícita para eliminar una métrica individual. La limpieza del autor o de la plataforma elimina después este entorno desechable.
Resumen
Configuraste una alarma de errores, observaste su activación y recuperación automáticas a partir de solicitudes reales, distinguiste el cero medido de los datos ausentes y eliminaste las alarmas del laboratorio conservando los registros de referencia.
Para ampliar este tema, consulta la referencia de AWS: Alarmas de métricas y acciones; Evaluación de alarmas con datos ausentes.