



Introducción
Un comando de resumen documental necesita límites predecibles para su dependencia de IA. Añadirás un cliente Bedrock con límites a una aplicación proporcionada, rechazarás entradas demasiado largas antes de la inferencia y tratarás fallos del servicio o respuestas lentas sin mostrar excepciones completas.
Debes conocer Python introductorio y la validación estructurada del laboratorio anterior. Se proporcionan la interfaz del comando y el analizador de respuestas para que te centres en los límites de la solicitud. Esta VM nueva tiene su propio documento, identidad configurada y cuota de inferencia.
Relación con la certificación
| Certificación | Tarea del examen | Práctica |
|---|---|---|
| AI Practitioner (AIF-C01) | Tareas 3.1, 3.2 | Limitar la salida de inferencia y gestionar respuestas generadas dentro de una aplicación. |
Conecta un cliente Bedrock con límites
En este paso implementarás el cliente del comando proporcionado y generarás un resumen estructurado real.
Comienza en el espacio de trabajo:
cd /home/labex/project
Lee el documento y las opciones del comando:
cat incident.txt
/opt/labex/aws/venv/bin/python application.py --help
El incidente es INC-204. application.py lee un documento e imprime JSON. Llama a client.request_summary; el response_parser.py proporcionado comprueba el motivo de finalización y los tres campos de cadena ya practicados. El client.py inicial informa de trabajo pendiente y no envía solicitudes.
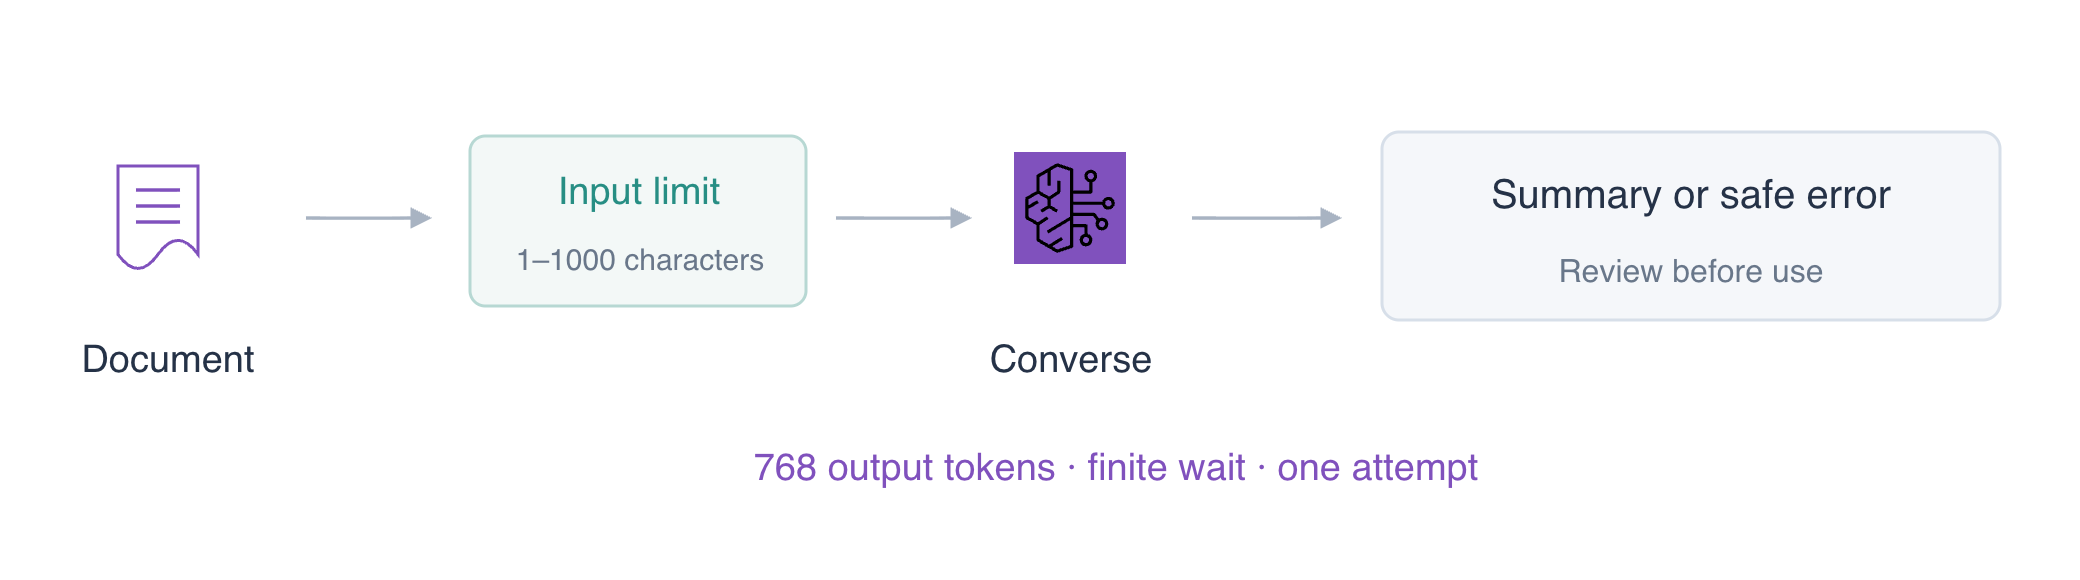
Un límite de entrada protege la aplicación antes de gastar cuota. Este ejemplo acepta entre 1 y 1000 caracteres no vacíos, fija la salida en un máximo de 768 tokens y configura tiempos límite explícitos de conexión y lectura. total_max_attempts: 1 significa una solicitud inicial sin reintentos automáticos. El tiempo de lectura limita la espera en la conexión; no garantiza que toda acción de la aplicación termine exactamente en ese instante.
Reemplaza el cliente inicial por esta implementación. ClientError representa una respuesta de error del servicio y ReadTimeoutError una espera de lectura agotada. Ambos se convierten en pequeños resultados JSON de diagnóstico. El resultado nunca incluye excepciones completas, cabeceras de solicitud ni credenciales:
cat > client.py <<'EOF'
import boto3
from botocore.config import Config
from botocore.exceptions import BotoCoreError, ClientError, ReadTimeoutError
from response_parser import summarize_response


def request_summary(document, endpoint_url, read_timeout):
    if not document.strip() or len(document) > 1000:
        return {'status': 'rejected', 'reason': 'input_limit'}
    client = boto3.client('bedrock-runtime', endpoint_url=endpoint_url,
        config=Config(proxies={}, connect_timeout=3, read_timeout=read_timeout,
                      retries={'total_max_attempts': 1}))
    try:
        response = client.converse(
            modelId='labex.text-v1:0',
            system=[{'text': 'Summarize only facts supplied in the incident document. Return exactly one JSON object with string fields incident_id, impact and next_action. No Markdown fences, extra keys or surrounding prose. Do not turn planned work into completed work.'}],
            messages=[{'role': 'user', 'content': [{'text': document}]}],
            inferenceConfig={'maxTokens': 768, 'temperature': 0})
    except ReadTimeoutError:
        return {'status': 'unavailable', 'reason': 'read_timeout'}
    except ClientError as error:
        code = error.response.get('Error', {}).get('Code')
        reason = 'busy' if code == 'ThrottlingException' else 'service_unavailable'
        return {'status': 'unavailable', 'reason': reason}
    except BotoCoreError:
        return {'status': 'unavailable', 'reason': 'connection_failed'}
    return summarize_response(response)
EOF
Ejecuta la aplicación contra su endpoint Bedrock normal configurado. > accepted.json guarda la salida impresa:
/opt/labex/aws/venv/bin/python application.py > accepted.json
Léela:
cat accepted.json
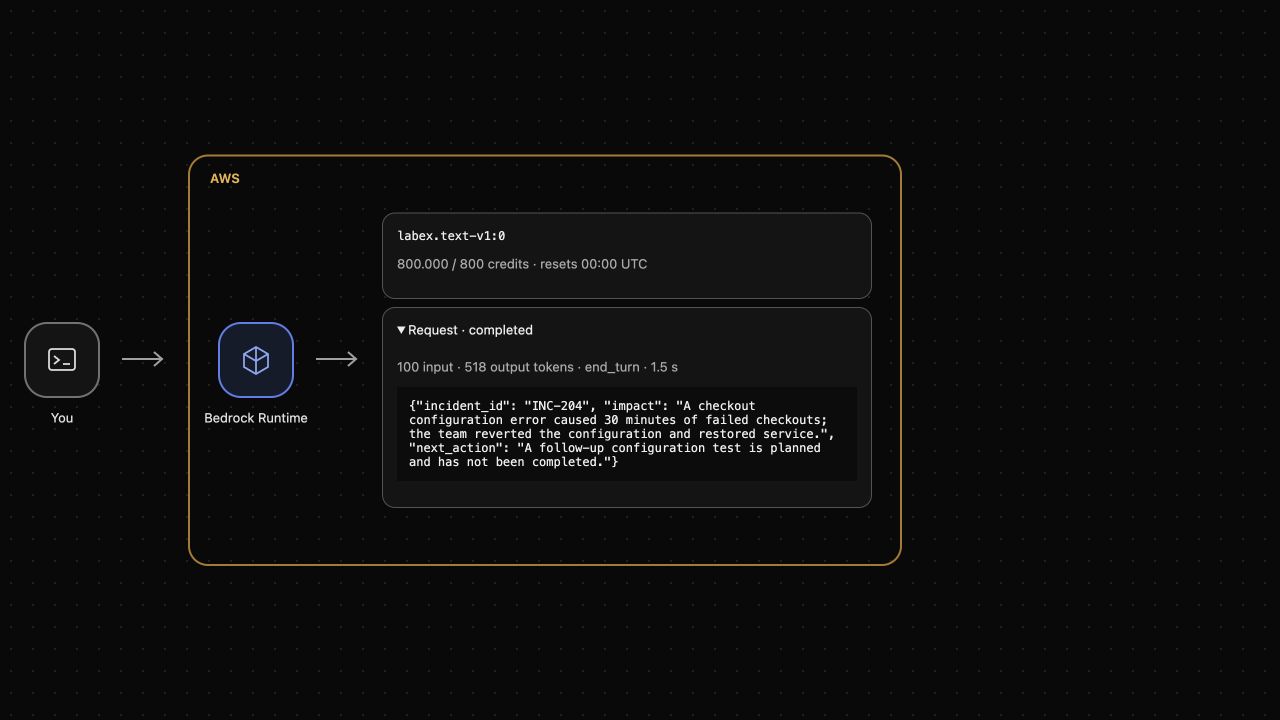
Espera status: ok con los tres campos del resumen. Revisa su significado con el documento. En AWS View, expande la solicitud real completada y compara su texto. El máximo de salida limita tokens generados; la longitud de entrada es una política independiente. Una respuesta en caché puede reutilizar salida real del modelo sin otro cargo de créditos.
Rechaza entradas demasiado largas antes de la inferencia
En este paso confirmarás que el cliente rechaza un documento que excede su presupuesto de entrada.
El oversized.txt proporcionado contiene más de 1000 caracteres. wc -m cuenta caracteres:
wc -m oversized.txt
Procesa ese archivo con la misma aplicación:
/opt/labex/aws/venv/bin/python application.py --document oversized.txt > too-long.json
Este rechazo intencionado termina con código 2. echo $? imprime el código del comando anterior:
echo $?
Lee el resultado seguro:
cat too-long.json
Espera status: rejected y reason: input_limit. El cliente verifica la entrada antes de construir una solicitud de inferencia, de modo que AWS View debe seguir mostrando solo la solicitud anterior. Rechazar la entrada evita nuevo consumo; borrar un archivo de resultado no revierte un cargo previo.
Gestiona fallos del servicio y tiempos de lectura agotados
En este paso probarás los límites de error con dos servicios locales de prueba de transporte explícitos.
Los endpoints siguientes devuelven deliberadamente un error o retrasan una respuesta. No envían solicitudes al modelo ni consumen créditos. Son dependencias de prueba, no proveedores alternativos de inferencia exitosa.
Utiliza el servicio de prueba no disponible en el puerto 5001:
/opt/labex/aws/venv/bin/python application.py --endpoint-url http://127.0.0.1:5001 > unavailable.json
Este fallo esperado termina con código 3. Inspecciona su diagnóstico:
cat unavailable.json
Espera status: unavailable y reason: service_unavailable, sin traza de pila, texto de excepción del SDK ni credenciales.
El servicio del puerto 5002 espera tres segundos. Cambia el tiempo de lectura a un segundo para esta prueba:
/opt/labex/aws/venv/bin/python application.py --endpoint-url http://127.0.0.1:5002 --read-timeout 1 > timed-out.json
Lee el resultado:
cat timed-out.json
Espera status: unavailable y reason: read_timeout. El SDK realiza un intento. Un timeout no demuestra que una solicitud upstream al modelo se canceló o fue gratuita: el upstream real puede finalizar después de que el cliente deje de esperar. Inspecciona solicitudes pendientes o fallidas y cuota antes de reintentar; no añadas un bucle incondicional de reintentos.
AWS View debe seguir mostrando solo la solicitud genuina del paso 1. Los 150 segundos del comando normal son una elección finita para este ejercicio; una aplicación real debe elegir tiempos límite, política de reintentos y mensajes al usuario según su presupuesto de latencia. La referencia oficial de Config explica los controles separados de conexión, lectura e intentos.
Elimina salidas de prueba y conserva la aplicación funcional
En este paso limpiarás cuatro archivos de resultado locales conservando el cliente funcional y la aplicación proporcionada.
Las comprobaciones de funcionamiento y fallo deben pasar antes de limpiar. Elimina solo las salidas indicadas:
rm accepted.json too-long.json unavailable.json timed-out.json
Lista los archivos restantes:
ls
Conserva application.py, client.py, response_parser.py, el documento y los casos de prueba. Converse no creó una carga persistente; borrar resultados locales no devuelve créditos. El código permanece para seguir practicando hasta que termine esta VM.
Resumen
Conectaste una solicitud Bedrock real al comando de resumen, limitaste entrada y salida, desactivaste reintentos automáticos y configuraste esperas finitas de conexión y lectura. Probaste errores y timeout sin sustituir la inferencia por un éxito ficticio, devolviste diagnósticos seguros y eliminaste solo resultados locales.


