介绍
AI 端点依赖的不只是 JavaScript。学习者可能发送无效输入,所选模型可能拒绝请求,账户可能达到配额或速率限制,服务容量可能暂时不可用,也可能是应用自身代码发生故障。这些情况需要不同的处理方式。如果把它们全部视为「AI 失败」,应用就会难以运维,还可能导致无意义的重试。
在本实验中,你将构建 POST /draft-reply。一个由 Cloudflare 托管的 Llama 模型会生成一条简短的支持回复。Worker 会在推理前拒绝无效输入,识别已记录的模型错误和限制错误,对暂时性故障最多重试一次,验证模型响应,并单独报告应用缺陷。「有界重试」表示额外尝试次数会预先固定,不能一直循环到耗尽账户的免费额度。
你将使用确定性测试夹具验证大多数故障路径。夹具是受控的替代实现,会返回指定的结果或错误,因此可以在不主动消耗配额或制造真实故障的情况下测试配额和服务中断行为。只有一次简短的本地请求和一次部署后的请求会使用真实模型。
这是本课程中的第六个引导式实验。如果你是直接进入本实验,请先完成将 LabEx 连接到 Cloudflare 账户,以了解如何使用 VM 终端、授权 Wrangler、确认学习账户并配置账户 ID。
所选的 @cf/meta/llama-3.3-70b-instruct-fp8-fast 模型可以使用标准 Workers AI 配额。Workers Free 当前每天包含 10,000 Neurons。本实验在免费配额仍可用时不需要 Workers Paid。可见练习和独立检查会分别在本地和部署后发起一次简短的正常请求。本地推理仍会访问 Cloudflare 并消耗账户用量,因此不要反复重试真实故障。
初始化过程会在 /home/labex/project/resilient-ai-reply 中安装 Node.js 22.22.0 和项目本地的 Wrangler 4.132.0,同时提供确定性测试夹具和独立检查。初始化不会授权 Wrangler、创建 Worker 源代码、调用模型、部署或创建云资源。
授权 VM 并配置具有故障恢复能力的 Worker
在本步骤中,你将授权这个全新的 VM,并配置一个临时 Worker。在 Cloudflare 中完成浏览器登录,不会自动授权新 LabEx VM 中的 Wrangler。
进入准备好的项目目录并确认固定版本的 CLI:
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
运行设备授权流程:
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
在浏览器中打开显示的授权 URL,确认目标学习账户,并批准列出的访问权限。此 Wrangler 版本在删除 Worker 时需要 KV 兼容性权限;本实验不会创建或修改 KV 数据。
使用结构化输出确认授权状态:
npx wrangler whoami --json
确认输出中的 "loggedIn": true,核对账户名称,然后将该账户的真实 ID 复制到下一步配置中。生成唯一名称并创建 wrangler.jsonc:
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
AI 绑定会为 Worker 代码提供由账户支持的 env.AI 接口。remote: true 还表示本地 Wrangler 请求会使用真实的 Workers AI 服务,并计入共享配额。
区分故障类别
在本步骤中,你将在编写恢复代码前,先将几种完全不同的故障原因转换为一个简洁的公共契约。
HTTP 状态码应告诉客户端发生了哪类结果,但不应暴露原始服务提供商消息、账户详细信息或堆栈跟踪。本实验使用以下五个边界:
400 invalid_request:学习者的输入缺失或超出允许大小,因此不会开始推理。502 model_incompatible或incompatible_model_response:所选模型或返回的数据结构不符合应用契约。重复相同请求无法修复兼容性问题。503 model_quota_exhausted或model_rate_limited:账户或模型限制要求停止。立即自动重试会消耗另一个请求并增加负载。503 model_temporarily_unavailable:超时或暂时容量不足导致两次请求都失败。响应包含Retry-After,客户端可以等待后再发起请求。500 application_failure:模型推理返回了可用数据,但应用自身的格式化步骤失败。
Cloudflare 将内部代码 3036 用于每日免费配额耗尽,3040 用于暂时容量不足,3007 用于超时,5035 用于需要 Workers Paid 的模型。应用会将已知信号映射为稳定的公共错误,并且只记录类别、尝试次数和跟踪 ID。
生成 TypeScript 声明并检查 AI 绑定:
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
生成的声明证明 env.AI 可供 Worker 使用,但不能证明模型调用一定成功;授权、配额、模型兼容性和服务健康状态都属于运行时条件。
构建有界恢复机制
在本步骤中,你将实现故障分类、单次重试限制,并分别处理模型响应和应用边界。
创建 Worker 入口文件:
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
重试循环允许总共尝试两次:首次调用,以及仅在已知暂时性类别下进行的一次额外调用。配额、速率限制和兼容性故障会立即停止。还要注意,模型调用、响应验证和应用格式化彼此分离,因此运维人员可以区分服务提供商问题和应用缺陷。
公共响应不会包含原始异常。日志会省略支持消息和生成的回复,只保留调查故障类别所需的生命周期元数据。
不消耗配额,验证故障矩阵
在本步骤中,你将先使用受控测试夹具验证每个故障类别,然后再发起真实模型请求。
运行确定性测试套件:
node --test test/worker.test.mjs
这九个测试用例使用测试夹具,而不是实时推理。确认无效输入不会调用模型,配额和速率限制错误各只调用一次,暂时容量不足最多调用两次,格式错误的输出会变成兼容性故障,格式化缺陷会变成应用故障。
现在打包准确的 Worker:
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
试运行会检查 Wrangler 能否打包该模块,并且应列出 AI 绑定。它不会部署 Worker,也不会调用模型。
执行正常推理并检查证据
在本步骤中,你将分别发起一次本地正常请求和一次部署后的正常请求,然后将结果与 Cloudflare 只读 Dashboard 中的证据对应起来。
在后台启动本地 Wrangler,并等待非 AI 的健康检查路由。这个有界循环可以避免无限等待:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
响应应包含非空的 reply、准确的模型名称、跟踪 ID,以及在通常正常的情况下等于 1 的 attempts。如果值为 2,表示一次暂时性故障已在限定次数内恢复。
运行独立的本地检查,停止保存的进程,然后部署:
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
从部署输出中复制准确的 workers.dev URL,然后测试公共端点:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
空消息应在推理前返回 HTTP 400。这证明了输入保护,同时不会额外消耗一次模型请求。
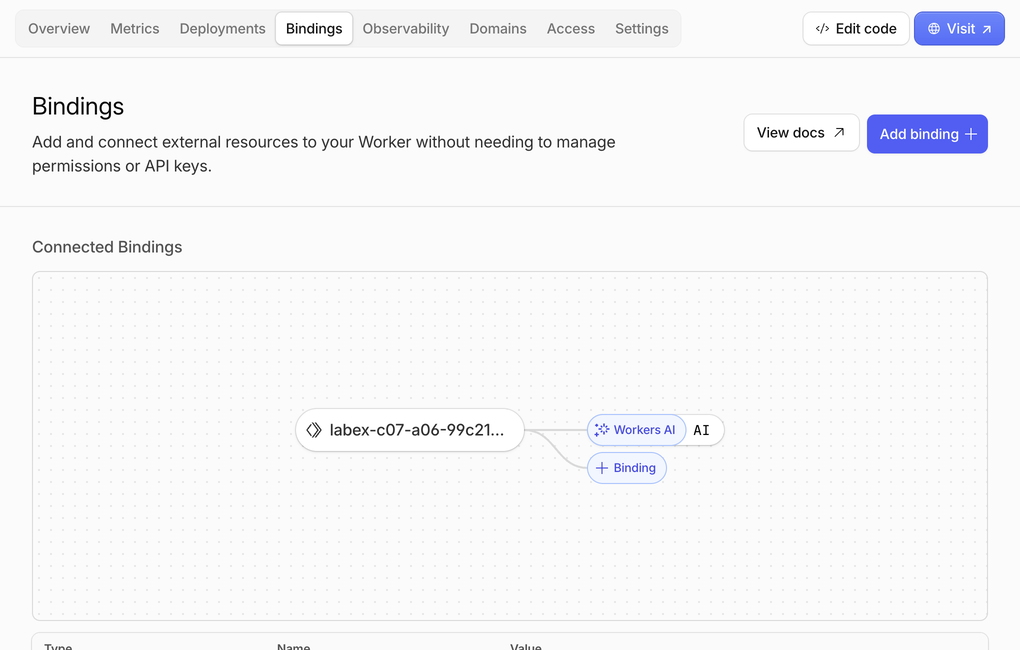
打开 Workers & Pages,选择准确的 Worker 名称,然后查看 Bindings。绑定是一个命名连接,使 Worker 代码无需保存 API 密钥即可访问其他 Cloudflare 服务。确认存在一个名为 AI 的 Workers AI 连接;下面示例中的 Worker 名称属于测试运行结果,你的名称会包含不同的随机后缀。
接着打开 Observability。示例运行产生了六个成功事件和零个错误。计数可能不同,因为一次请求可能同时创建调用记录和应用日志,并且保存的日志可能会在响应之后到达。
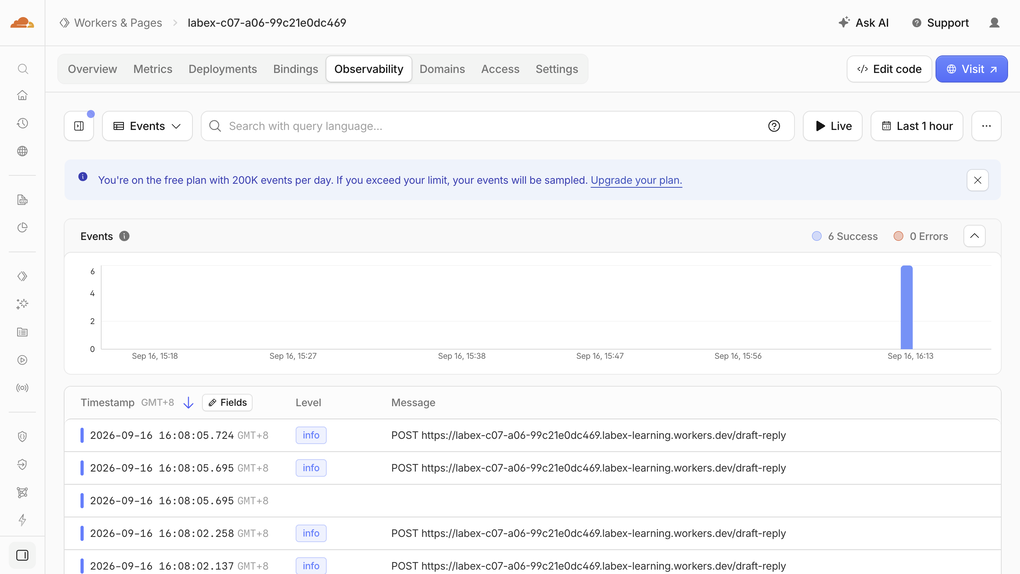
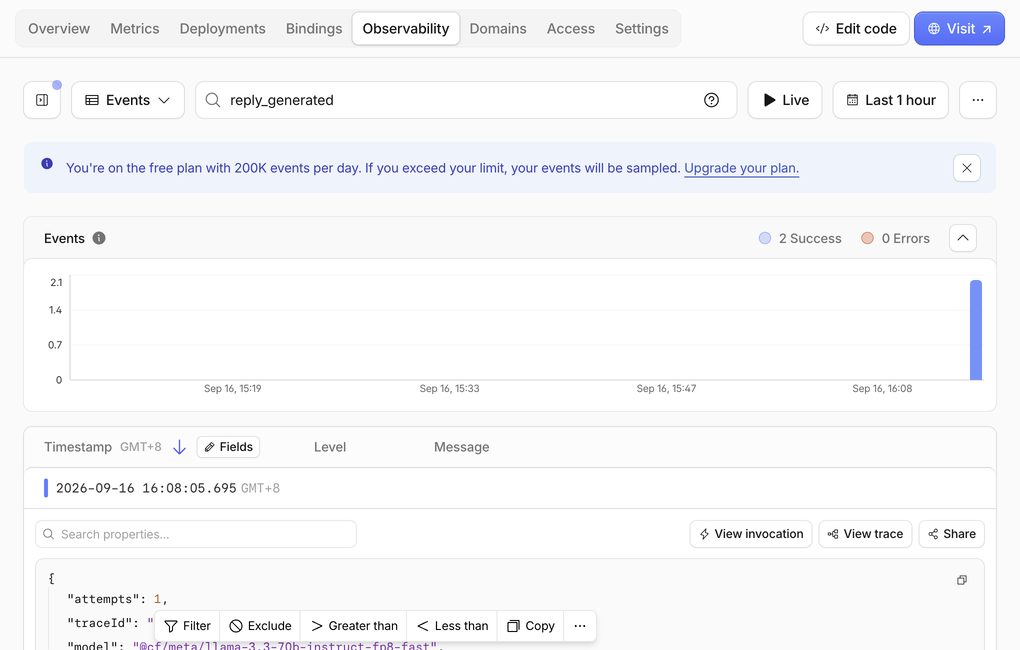
这里的蓝色免费计划提示说明的是 Workers Logs 事件配额,不是 AI 推理用量。搜索 reply_generated 并展开一条结果。重点示例显示了两个成功匹配项,以及应用有意限制的字段:一次尝试、一个跟踪 ID 和准确的模型名称。完整事件还包含 event: "reply_generated",但应用不会记录支持消息、生成的回复或服务提供商原始错误。
最后,打开 AI > Workers AI,并保持选中的标签页为 Neurons。Neuron 是 Cloudflare 用于表示 AI 计算量的单位。共享示例账户显示当天使用了 428.59/10k Neurons,其中 427.82 归因于 Llama 模型,0.77 归因于之前的嵌入实验。这些总量包含课程中的其他练习,并且可能会延迟更新;它们不是一次请求的成本。
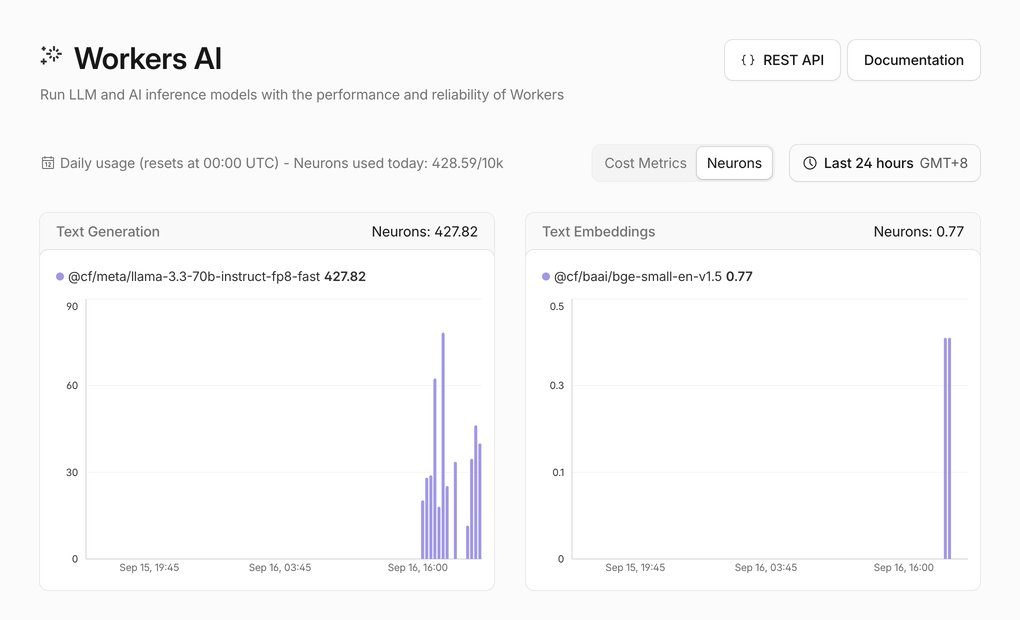
只需确认用量仍处于当天可用配额内。Dashboard 视图有助于将配置、流量和用量与命令行结果联系起来,但运行时响应和独立检查仍然是最终依据。不要仅为了让图表发生变化而重复推理。
删除 Worker 并退出登录
在本步骤中,你将在授权仍然有效时删除临时端点,然后从 VM 中移除该授权。
只删除 wrangler.jsonc 中记录名称的临时 Worker:
npx wrangler delete --force
在 Wrangler 仍处于授权状态时,确认资源已不存在:
./.labex/verify.py deleted
现在删除此 VM 中保存的授权信息:
npx wrangler logout
npx wrangler whoami --json
确认输出中的 "loggedIn": false,然后运行最终检查:
./.labex/verify.py logout
删除 Worker 会移除云资源;退出登录会移除该 VM 中的授权。这是两个独立的清理操作。
总结
你构建了一个 Workers AI 端点,能够:
- 在推理前拒绝无效输入;
- 区分兼容性、配额、速率限制、暂时性故障和应用故障;
- 对已知的暂时性故障最多重试一次;
- 在应用格式化之前验证模型输出;
- 返回稳定的公共错误,同时避免泄露服务提供商的原始详细信息;
- 记录受隐私限制的生命周期元数据;
- 使用确定性测试夹具验证故障行为,避免浪费配额;
- 在 Workers Free 上确认本地和部署后的正常推理;以及
- 删除临时 Worker 并退出 VM 登录状态。
重要的运维习惯不是「重试每一个 AI 错误」,而是识别故障边界,只在确实属于暂时性的情况下并且在固定限制内重试,同时向客户端返回可采取行动的响应。