简介
当 AI 请求失败时,调用方只能看到最终的 HTTP 响应。这个响应能说明请求出了问题,但不一定能说明具体原因:请求格式错误、被网关拒绝,还是被上游模型提供商拒绝。可观测性意味着收集足够的证据,在请求离开调用方后继续追踪它,并说明请求经过了哪个边界、由哪个边界处理。
对于到达网关的请求,AI Gateway 会记录一条日志。日志可以显示提供商、模型、HTTP 状态、耗时和令牌用量。你还可以附加少量自定义元数据,也就是帮助你之后找到请求的小型标签。元数据不是私密保险库。本实验只使用随机追踪 ID、合成案例名称和布尔标志,绝不会使用凭据、提示词、电子邮件地址或账户 ID。
你将创建一个一次性使用的认证网关,然后发送一个带有安全追踪标签、故意格式错误的 Workers AI 请求。接着找到对应的失败日志,比较网关认证失败和上游认证失败,修复输入,并确认同一个追踪 ID 现在对应成功的请求。这样,故障排查将建立在证据上,而不是猜测上。
如果你是直接进入本课程的,请先完成将 LabEx 连接到你的 Cloudflare 账户。该实验会介绍 LabEx VM 终端、Wrangler 设备授权、学习账户确认以及显式账户 ID。还要先完成通过网关进行路由推断,因为本实验会沿用其中两个彼此独立的授权标头。
本实验使用 Cloudflare 托管的 @cf/meta/llama-3.3-70b-instruct-fp8-fast 模型,并采用 Standard Workers AI 计费方式。不需要 Workers Paid、Unified Billing 或外部提供商账户。请求内容很小,且使用合成数据。如果共享的每日 Workers AI 配额不可用,请停止操作,不要反复重试。
安装过程会在 /home/labex/project/ai-gateway-trace 中安装 Node.js 22.22.0 和项目本地的 Wrangler 4.132.0。安装过程会准备独立的只读评估,但不会授权 Wrangler、创建云资源或发送模型流量。实验结束时,LabEx 会销毁临时 VM;不过你仍然需要在退出前删除网关和令牌,因为仅销毁 VM 无法删除云资源。
授权 VM 并创建安全的追踪 ID
在此步骤中,你会将新的 VM 连接到学习账户,并为一个一次性使用的网关和一个合成追踪创建名称。
追踪 ID 是关联观测结果共用的标签。它应该能够标识请求,但不能暴露用户说了什么或用户是谁。本实验会生成一个随机值,并将其与资源名称一起保存,而不会与凭据放在一起。
进入准备好的项目,确认固定版本的 CLI,并为此 VM 授权:
cd /home/labex/project/ai-gateway-trace
npx wrangler --version
npx wrangler login --device --browser=false --scopes account:read user:read ai:write
打开显示的链接,输入代码,并授权目标学习账户。确认结构化身份信息:
npx wrangler whoami --json
预期 Wrangler 版本为 4.132.0,且 loggedIn: true。将下面的 YOUR_ACCOUNT_ID 替换为目标账户显示的实际 32 位 ID:
GATEWAY_ID="labex-c09-g02-$(openssl rand -hex 6)"
TOKEN_NAME="$GATEWAY_ID-token"
TRACE_ID="trace-$(openssl rand -hex 8)"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "tokenName": "$TOKEN_NAME",
  "traceId": "$TRACE_ID"
}
JSON
cat .labex/state.json
追踪 ID 是安全的合成数据。账户 ID 和资源名称会保存在本地状态文件中,后续清理时只会操作本实验创建的资源。
创建可观测的认证网关
在此步骤中,你会创建一个网关。请求通过调用方认证边界后,网关会记录这些请求。
打开 Cloudflare Dashboard,选择 AI → AI Gateway → Create gateway → Custom gateway。使用已保存的 gatewayId 作为网关名称。保持请求日志记录和网关认证开启。关闭缓存、速率限制、支出限制和重试,并将 Workers AI 计费方式保持为 Standard。
创建完成后,确认面包屑导航中显示的唯一网关 ID,然后打开 Settings。日志会生成本实验所需的证据;认证则确保未知调用方无法创建大量日志或消耗模型用量。
选择 Create an AI Gateway authentication token。使用已保存的 tokenName,仅包含目标学习账户,并准确设置以下权限:
- AI Gateway — Run:用于进入经过认证的网关;
- AI Gateway — Edit:用于读取日志和删除这个一次性使用的网关。
不要添加 Workers AI 权限。Wrangler 会提供单独的短期上游凭据。确认账户和权限后创建令牌,然后保存一次性显示的值,但不要回显它:
bash -c '
while :; do
  read -rsp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
通过经过认证的管理 API 验证准确的资源:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s),g=b.result||{};console.log(JSON.stringify({success:b.success,id:g.id,collect_logs:g.collect_logs,authentication:g.authentication},null,2))})'
unset GATEWAY_TOKEN
预期结果是显示已保存的 ID,且包含 collect_logs: true 和 authentication: true。
使用无效输入发送带标签的请求
在此步骤中,你会创建一个可控的输入失败场景。网关凭据和上游凭据保持有效,只有模型输入的格式不正确。
自定义元数据最多接受五个扁平的字符串、数字或布尔值。以 cf. 开头的键由 Cloudflare 保留。本次请求使用三个安全值:随机追踪 ID、案例名称 bad-input 以及 synthetic: true。
选定的模型需要提示词。故意省略提示词,同时保存响应和 HTTP 状态:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
TRACE_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).traceId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
METADATA=$(node -e 'process.stdout.write(JSON.stringify({trace_id:process.argv[1],case:"bad-input",synthetic:true}))' "$TRACE_ID")
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(npx wrangler auth token --json | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))')
STATUS=$(curl --http1.1 -sS -D .labex/bad-input-headers.txt \
  -o .labex/bad-input-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"max_tokens":16}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/bad-input-status.txt
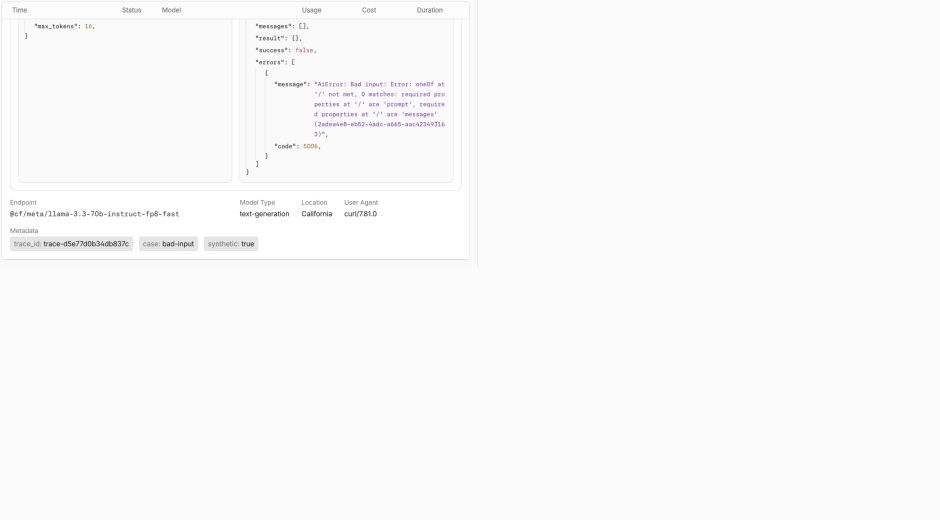
预期 HTTP 状态为 400 或 422。这是客户端输入失败,并不能证明存在授权问题。响应正文会保存下来,便于进行范围受控的故障排查,但不会自动打印。
将失败请求与网关日志关联起来
在此步骤中,你会使用追踪 ID 查找请求记录,而不是仅根据时间搜索。
日志可能需要短时间才会出现。通过管理 API 读取现有日志清单,解析每个扁平元数据对象,并只打印解释失败所需的字段:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
TRACE_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).traceId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID/logs?per_page=50" \
  > .labex/logs-after-input.json
unset GATEWAY_TOKEN
node - <<'NODE'
const body = require('./.labex/logs-after-input.json')
const trace = require('./.labex/state.json').traceId
const meta = row => {
  try { return typeof row.metadata === 'string' ? JSON.parse(row.metadata) : (row.metadata || {}) }
  catch { return {} }
}
const matches = (body.result || []).filter(row => meta(row).trace_id === trace && meta(row).case === 'bad-input')
console.log(matches.map(row => ({
  id: row.id,
  provider: row.provider,
  model: row.model,
  success: row.success,
  status_code: row.status_code,
  duration: row.duration,
  tokens_in: row.tokens_in,
  tokens_out: row.tokens_out,
  metadata: meta(row)
})))
if (!matches.some(row => row.success === false)) process.exit(2)
NODE
预期看到已保存的追踪 ID、case: "bad-input"、Workers AI 提供商以及失败状态。由于无效输入可能在开始生成前就失败,令牌计数可能为空。如果暂时看不到该记录,请等待约 20 秒,然后重新运行这段只读代码。
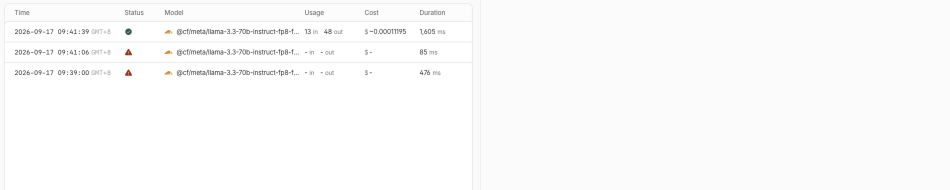
打开 Dashboard 中网关的 Logs 视图。使用元数据筛选器或显示的时间戳找到失败行,然后打开其详细信息面板。确认模型、失败状态和自定义元数据描述的是同一个合成请求。
区分网关授权失败和上游授权失败
在此步骤中,你会每次只修改一个凭据。两项测试都可能返回 401 或 403,因此仅凭状态码无法判断原因;日志所在的位置会提供缺失的上下文。
首先保持上游凭据有效,但使用无效的网关凭据。经过认证的网关会在请求进入网关并创建带标签的提供商日志之前拒绝该请求:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
TRACE_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).traceId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
METADATA=$(node -e 'process.stdout.write(JSON.stringify({trace_id:process.argv[1],case:"bad-gateway-auth",synthetic:true}))' "$TRACE_ID")
UPSTREAM_TOKEN=$(npx wrangler auth token --json | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))')
STATUS=$(curl --http1.1 -sS -o .labex/bad-gateway-auth-response.json -w '%{http_code}' \
  -H 'cf-aig-authorization: Bearer deliberately-invalid-gateway' \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"This request must not reach Workers AI.","max_tokens":8}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/bad-gateway-auth-status.txt
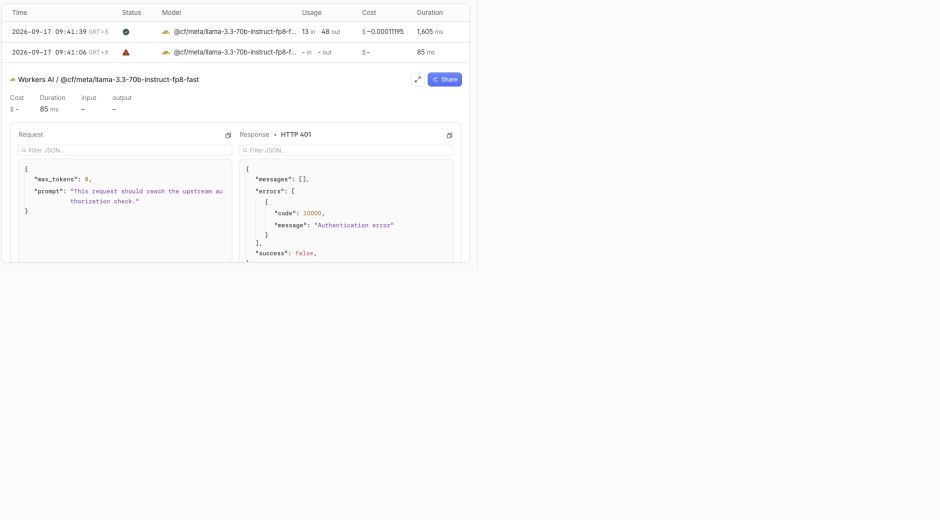
现在保持网关凭据有效,只替换上游 Workers AI 凭据。该请求会进入网关,并可能留下失败的提供商记录:
METADATA=$(node -e 'process.stdout.write(JSON.stringify({trace_id:process.argv[1],case:"bad-upstream-auth",synthetic:true}))' "$TRACE_ID")
GATEWAY_TOKEN=$(cat .labex/gateway-token)
STATUS=$(curl --http1.1 -sS -o .labex/bad-upstream-auth-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H 'Authorization: Bearer deliberately-invalid-upstream' \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"This request should reach the upstream authorization check.","max_tokens":8}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/bad-upstream-auth-status.txt
两次请求都预期返回 401 或 403。短暂等待后,读取日志,而不是重新生成请求,并比较两个标签:
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID/logs?per_page=50" \
  > .labex/logs-after-auth.json
unset GATEWAY_TOKEN
node - <<'NODE'
const rows = require('./.labex/logs-after-auth.json').result || []
const trace = require('./.labex/state.json').traceId
const meta = row => { try { return typeof row.metadata === 'string' ? JSON.parse(row.metadata) : (row.metadata || {}) } catch { return {} } }
for (const name of ['bad-gateway-auth', 'bad-upstream-auth']) {
  const found = rows.filter(row => meta(row).trace_id === trace && meta(row).case === name)
  console.log(name, found.map(row => ({status_code: row.status_code, success: row.success, provider: row.provider})))
}
NODE
gateway-auth 标签不应有提供商日志;upstream-auth 标签应显示失败的 Workers AI 日志行。这说明,与单独查看 HTTP 状态相比,边界图和关联日志能提供更多信息。
修复请求并确认成功
在此步骤中,你会恢复两个有效凭据,并提供必需的提示词。只有当运行时输出和可观测性结果一致时,修复才算完成。
使用同一个追踪 ID,但将案例名称改为 repaired:
METADATA=$(node -e 'process.stdout.write(JSON.stringify({trace_id:process.argv[1],case:"repaired",synthetic:true}))' "$TRACE_ID")
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(npx wrangler auth token --json | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))')
STATUS=$(curl --http1.1 -sS -o .labex/repaired-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
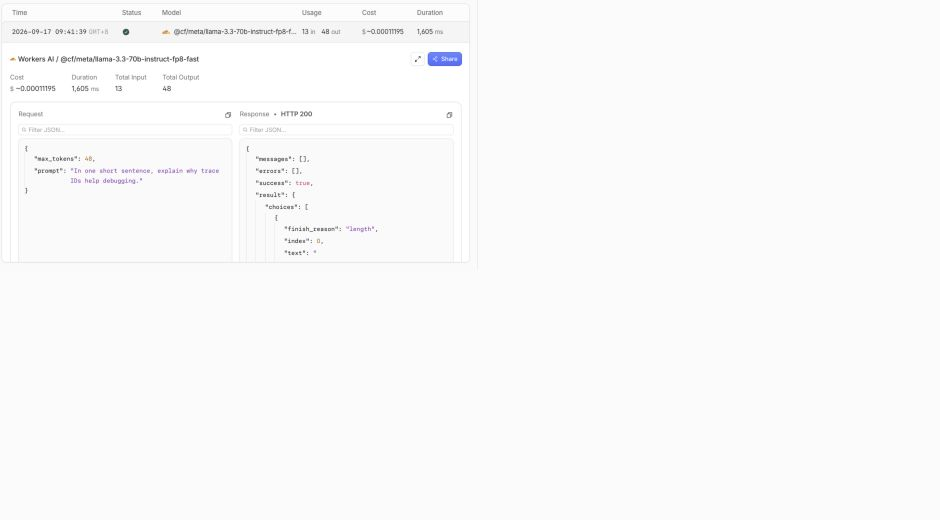
  --data '{"prompt":"In one short sentence, explain why trace IDs help debugging.","max_tokens":48}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/repaired-status.txt
node -e 'const b=require("./.labex/repaired-response.json"); console.log(b.result?.response ?? b.result)'
预期 HTTP 状态为 200,并且生成的文本非空。如有需要,等待日志出现,然后重新运行上一步中的只读日志清单命令。在 Dashboard 中按追踪 ID 筛选,并比较 bad-input、bad-upstream-auth 和 repaired。修复后的日志行应显示成功、200 状态和令牌用量。
删除一次性使用的网关
在此步骤中,你会删除云资源,同时使用管理凭据确认资源确实不存在。
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s);if(!b.success)process.exit(1);console.log("gateway deletion accepted")})'
unset GATEWAY_TOKEN

GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
node -e 'const b=require("./.labex/gateways-after-delete.json"),id=process.argv[1],found=(b.result||[]).some(g=>g.id===id);console.log("gateway absent:",!found);if(found)process.exit(1)' "$GATEWAY_ID"
预期看到 gateway absent: true。经过认证的资源清单可以将真实删除与因退出登录或网络故障导致的页面缺失区分开来。
删除令牌并退出登录
在此步骤中,你会撤销剩余的云凭据,并断开 VM 的连接。
在 Cloudflare Dashboard 中打开 My Profile → API Tokens。找到准确的已保存 tokenName,打开 Actions,选择 Delete,查看确认信息,然后只删除该令牌。由于网关删除已经得到确认,现在可以安全地撤销此令牌。
删除 VM 中的副本,并结束 Wrangler 的单独授权:
shred -u .labex/gateway-token
npx wrangler logout
npx wrangler whoami --json || true
test ! -e .labex/gateway-token && echo "local gateway token removed"
预期看到 loggedIn: false 和 local gateway token removed。Dashboard 会话是独立的,仍会保持登录状态。实验结束时,LabEx 会销毁这个临时 VM,而不会保存它。
总结
你使用安全的自定义元数据,将格式错误的 Workers AI 请求与其 AI Gateway 日志关联起来。你了解到,HTTP 状态需要结合边界上下文来分析:无效的网关认证会在生成提供商日志之前被拒绝,而无效的上游授权会显示为失败的 Workers AI 记录。随后,你修复了输入,确认生成了文本和成功的关联日志,并删除了所有一次性使用的凭据和资源。
下一项实验将使用同样的证据优先方法学习缓存。你会重复发送一次有界的公共请求,区分缓存命中和新的模型调用,并在需要新鲜输出时绕过缓存。