简介
AI 模型可能暂时不可用、负载过高,或者无法理解输入内容。回退机制会为应用预先规划一个替代方案,而不是立即返回错误。实用的回退机制必须有边界:包含一个简短且有顺序的模型列表,并明确何时停止。它不能无限重试,也不能在第一个模型成功后继续调用其他所有模型。
你将部署一个包含两条路径的 Cloudflare Worker。回退路径会故意向嵌入模型发送聊天格式的输入,捕获这个可预期的不兼容错误,然后调用一个聊天模型。健康路径会调用兼容的主聊天模型并立即停止。所有请求都会经过同一个 AI Gateway,因此日志可以说明哪个模型失败,以及哪个模型完成了请求。
如果你是直接进入本课程的,请先完成 将 LabEx 连接到 Cloudflare 账户。该实验会介绍 LabEx 终端、Wrangler 设备授权、账户选择和账户 ID。还请先完成 通过网关路由推理请求,因为本实验会使用其中的网关和 Workers AI 概念。
本实验使用 Cloudflare 托管的 Workers AI 模型和 Workers AI 绑定。不需要 Workers Paid、外部提供商密钥或已弃用的 Universal Endpoint。受控的失败请求会在推理前被拒绝,每条成功路径只会生成简短回复。如果共享的每日 Workers AI 配额不可用,请停止操作,不要反复重试。
Setup 会在 /home/labex/project/ai-gateway-fallback 中安装 Node.js 22.22.0 和项目本地的 Wrangler 4.132.0,并准备独立检查所需的文件。但它不会授权 Wrangler、创建云资源、部署 Worker 或发送模型请求。实验结束后,LabEx 会销毁虚拟机;你仍然需要删除远程 Worker、网关和 API 令牌,因为销毁虚拟机不会删除云资源。
授权虚拟机并命名恢复路径
每个实验都会从一台全新的虚拟机开始。在本步骤中,你将授权 Wrangler 使用学习账户,并为一个网关、一个 Worker 和一个临时令牌保存唯一名称。
cd /home/labex/project/ai-gateway-fallback
npx wrangler --version
npx wrangler login --device --browser=false
打开终端显示的链接,输入代码,然后授权目标学习账户。Wrangler 会请求本实验后续部署 Worker 和使用 Workers AI 所需的权限;批准前请检查显示的账户是否正确。然后查看结构化身份信息:
npx wrangler whoami --json
预期会看到 Wrangler 4.132.0 和 loggedIn: true。将 YOUR_ACCOUNT_ID 替换为目标账户显示的实际 32 位 ID:
GATEWAY_ID="labex-c09-g05-$(openssl rand -hex 6)"
WORKER_NAME="${GATEWAY_ID/g05/g05-worker}"
TOKEN_NAME="$GATEWAY_ID-token"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "workerName": "$WORKER_NAME",
  "tokenName": "$TOKEN_NAME"
}
JSON
cat .labex/state.json
这些标识符不是秘密信息。记录它们后,后续验证和清理操作就只会针对本实验创建的资源。
创建可观测的 AI Gateway
在本步骤中,你将创建一个共享检查点,用于记录两条模型路由。
AI Gateway 是位于应用和模型请求之间的命名检查点。即使应用切换了模型,它也能为多次尝试提供统一的日志和元数据位置。
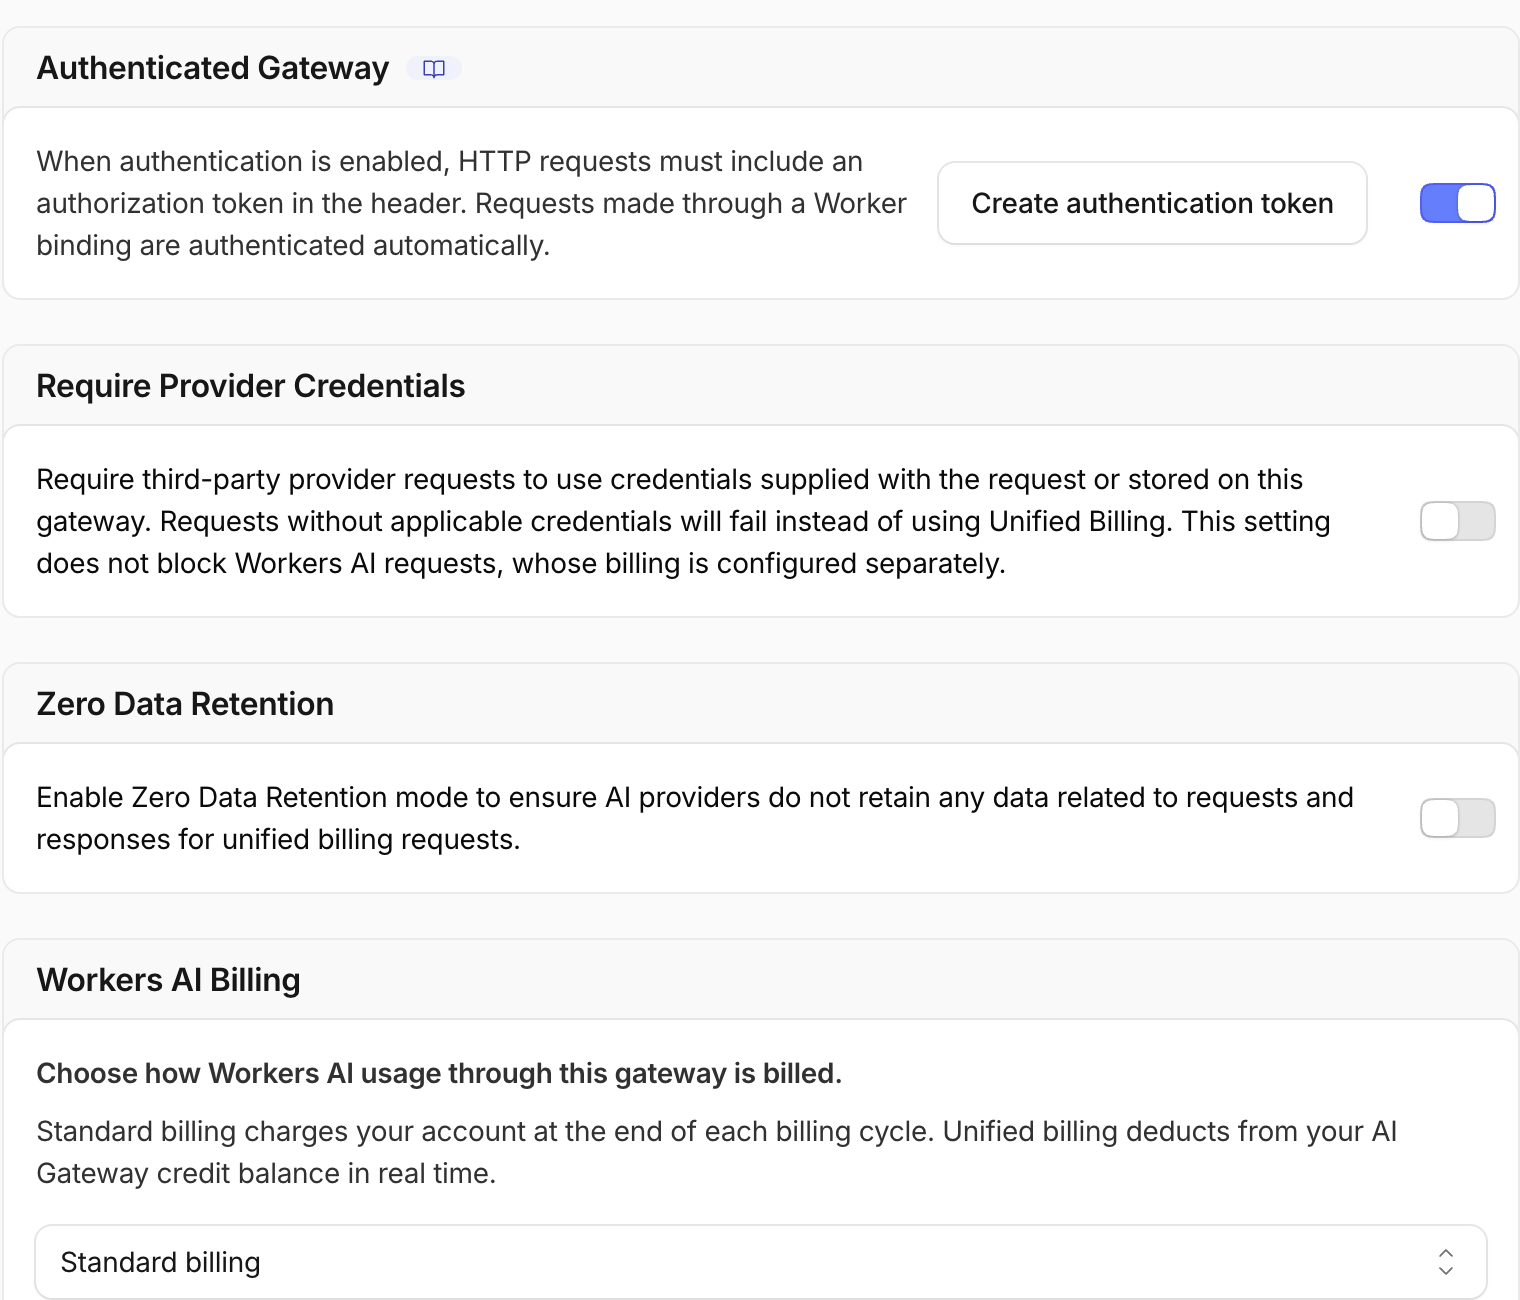
打开 Cloudflare Dashboard,选择 AI → AI Gateway → Create a custom gateway。使用已保存的 gatewayId。保持 Collect Logs 和 Authenticated Gateway 启用。关闭缓存、速率限制、重试和支出限制,并将 Workers AI 计费保持为 Standard。然后创建网关。
打开 My Profile → API Tokens,选择 Create Token → Create Custom Token,并使用已保存的 tokenName。添加账户权限 AI Gateway — Edit 和 AI Gateway — Run,并将权限限制在目标学习账户。这个临时令牌只允许本实验读取和随后删除自己的网关;部署的 Worker 不会将该令牌嵌入其中。
创建令牌后,从 Cloudflare 提供的一次性验证命令中只复制 Bearer 后面的值,并通过隐藏输入保存:
bash -c '
while :; do
  read -ersp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
只读取重要的非秘密设置:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  > .labex/gateway.json
unset GATEWAY_TOKEN
node -e 'const g=require("./.labex/gateway.json").result; console.log({id:g.id,collect_logs:g.collect_logs,authentication:g.authentication})'
预期会看到已保存的网关 ID,并且两个值都为 true。
定义两次尝试的 Worker
在本步骤中,你将使用普通的 Worker 代码编写恢复策略。该策略包含两次明确的调用,而不是使用循环,因此最大成本和延迟都很容易确认。
回退路径的第一次调用使用嵌入模型。嵌入模型会将文本转换为数字向量,不接受聊天 messages。提供聊天格式的输入会在推理前产生安全且确定性的不兼容错误。catch 代码块会记录这个错误,然后调用一个兼容的聊天模型。
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
WORKER_NAME=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).workerName')
cat > wrangler.jsonc <<JSON
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-09-17",
  "ai": { "binding": "AI" }
}
JSON
cat > src/index.js <<JS
export default {
  async fetch(request, env) {
    const healthy = new URL(request.url).pathname === "/healthy";
    const attempts = [];
    const gateway = {
      gateway: {
        id: "$GATEWAY_ID",
        metadata: {
          lab: "g05-fallback",
          mode: healthy ? "healthy" : "fallback",
          synthetic: true
        }
      }
    };

    if (!healthy) {
      try {
        await env.AI.run(
          "@cf/baai/bge-small-en-v1.5",
          { messages: [{ role: "user", content: "Reply with ROUTE OK" }] },
          gateway
        );
        attempts.push({ model: "@cf/baai/bge-small-en-v1.5", status: "unexpected-success" });
      } catch (error) {
        attempts.push({
          model: "@cf/baai/bge-small-en-v1.5",
          status: "failed",
          reason: String(error).slice(0, 180)
        });
      }
    }

    const selectedModel = healthy
      ? "@cf/meta/llama-3.3-70b-instruct-fp8-fast"
      : "@cf/meta/llama-3.2-3b-instruct";
    const result = await env.AI.run(
      selectedModel,
      { prompt: "Reply with exactly: ROUTE OK", max_tokens: 12 },
      gateway
    );
    attempts.push({ model: selectedModel, status: "succeeded" });

    return Response.json({
      mode: healthy ? "healthy-primary" : "fallback-recovery",
      usedFallback: !healthy,
      selectedModel,
      attempts,
      response: result.response
    });
  }
};
JS
npx wrangler deploy --dry-run
AI 绑定让 Worker 可以直接访问 Workers AI。gateway 选项会将每次调用路由到已保存的网关,并仅附加合成元数据,不会附加提示词、凭据或人员标识符。
部署并运行回退路径
在本步骤中,你将部署 Worker,并触发一次受控的恢复场景。
部署 Worker,并保存 Wrangler 的输出,使测试使用分配给你账户的确切 URL:
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
WORKER_URL=$(grep -Eo 'https://[^ ]+\.workers\.dev' .labex/deploy-output.txt | tail -1)
printf '%s\n' "$WORKER_URL" | tee .labex/worker-url.txt
成功部署后,workers.dev 路由可能需要几秒钟才能完成传播。在不发送额外模型请求的情况下轮询该 URL:404 只表示边缘路由尚未就绪,循环会在第一次收到 200 响应时停止。
WORKER_URL=$(cat .labex/worker-url.txt)
for attempt in $(seq 1 12); do
  STATUS=$(curl --http1.1 -sS -o .labex/fallback-response.json -w '%{http_code}' "$WORKER_URL/fallback")
  printf 'attempt %s: HTTP %s\n' "$attempt" "$STATUS"
  [ "$STATUS" = 200 ] && break
  [ "$attempt" -eq 12 ] && exit 1
  sleep 5
done
python3 -m json.tool < .labex/fallback-response.json
预期会看到 usedFallback: true,共两次尝试;嵌入模型标记为 failed,而 @cf/meta/llama-3.2-3b-instruct 标记为 succeeded。不会严格检查生成文本的措辞,检查的是路由决策。
证明健康的主模型会提前停止
在本步骤中,你将证明主模型成功后不会进行不必要的回退调用。
只有当主路径正常工作时,回退机制才应保持不介入。/healthy 路径从兼容的聊天模型开始,因此应只产生一次尝试,然后停止。
WORKER_URL=$(cat .labex/worker-url.txt)
curl --http1.1 -fsS "$WORKER_URL/healthy" \
  | tee .labex/healthy-response.json \
  | python3 -m json.tool
预期会看到 usedFallback: false,selectedModel 为 @cf/meta/llama-3.3-70b-instruct-fp8-fast,并且只有一次成功的尝试。这就是短路行为:成功会立即结束路由。
从网关日志读取路由
在本步骤中,你将把 Worker 的 JSON 结果与独立的 AI Gateway 证据对应起来。
Worker 响应描述的是应用行为。AI Gateway 日志提供独立的提供商侧证据。日志可能需要几秒钟才会出现,因此请稍等片刻,然后只打印与路由相关的字段:
sleep 8
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID/logs?per_page=50" \
  > .labex/logs.json
unset GATEWAY_TOKEN
node - <<'NODE'
const rows=require('./.labex/logs.json').result||[];
const meta=row=>{try{return typeof row.metadata==='string'?JSON.parse(row.metadata):(row.metadata||{})}catch{return {}}};
console.table(rows.filter(row=>meta(row).lab==='g05-fallback').map(row=>({
  mode:meta(row).mode, model:row.model, success:row.success, status:row.status_code
})));
NODE
打开 Dashboard 中该网关的 Logs 页面。回退组应包含一条失败的嵌入模型记录和一条成功的回退模型记录。健康组应只包含成功的主聊天模型记录。
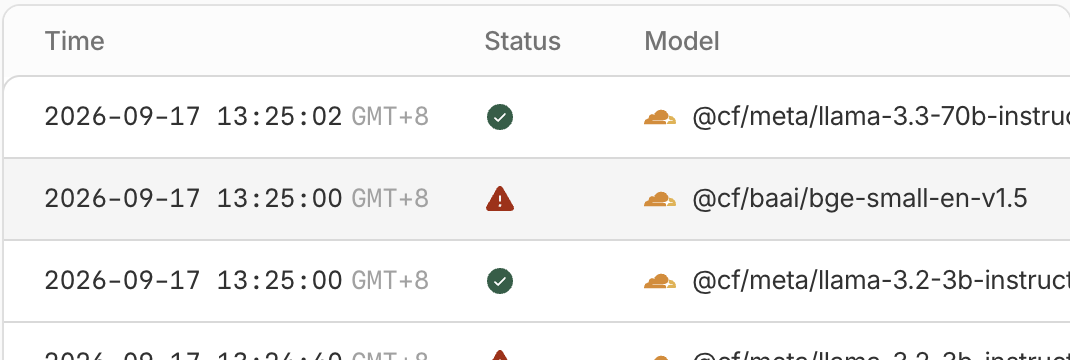
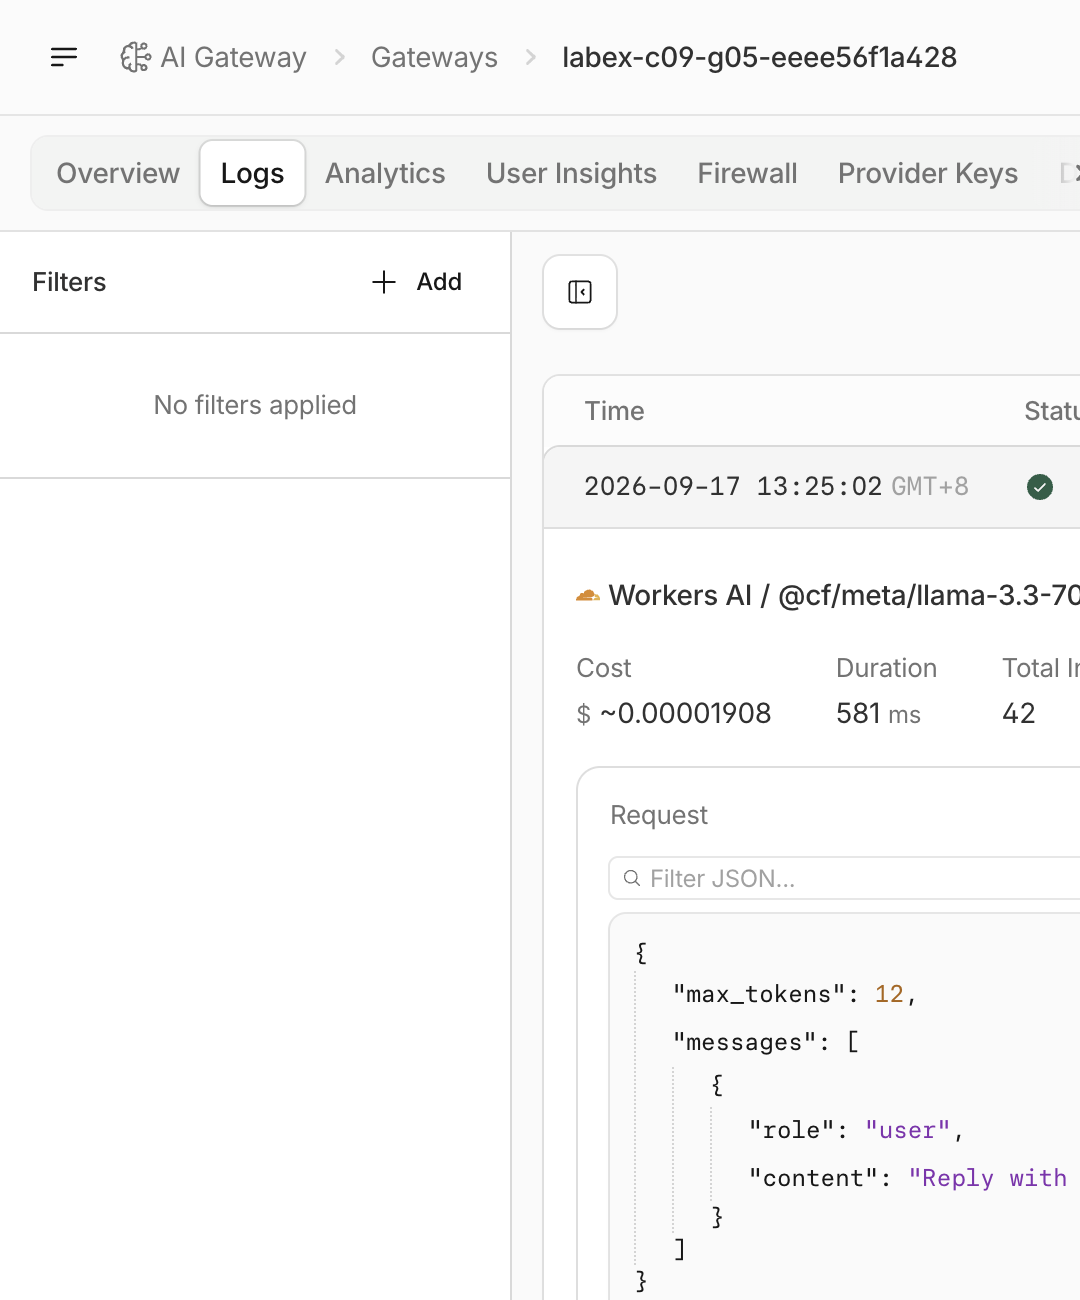
mode 元数据可以在不包含提示词或秘密信息的情况下关联这些记录。模型、成功状态和状态码可以说明路由过程;仅凭生成的文本无法说明这一点。
检查有界恢复契约
在本步骤中,你将比较两条路径,并确定模型尝试次数的最大值。
现在你已经获得了三种相互匹配的证据:
- 源代码包含两个明确的
env.AI.run()调用,没有重试循环; /fallback报告一次失败后接着一次成功;/healthy报告一次成功后停止。
根据已保存的响应显示简要对比:
node - <<'NODE'
for (const name of ['fallback','healthy']) {
  const body=require(`./.labex/${name}-response.json`);
  console.log(name, {
    usedFallback: body.usedFallback,
    selectedModel: body.selectedModel,
    attemptCount: body.attempts.length,
    statuses: body.attempts.map(item=>item.status)
  });
}
NODE
最大尝试次数为两次。如果回退模型也失败,Worker 会返回错误,而不是重新启动路由。在生产应用中,你可以添加超时、熔断器或面向用户的错误信息,但每个额外的恢复机制都应保持独立、有界并且可观测。
删除临时资源
在本步骤中,你将删除本实验创建的所有远程资源,并移除本地授权。
先删除 Worker,防止它继续产生新的网关流量。然后只删除 state.json 中记录的网关:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
WORKER_NAME=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).workerName')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
npx wrangler delete --name "$WORKER_NAME" --force
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  > .labex/delete-gateway.json
unset GATEWAY_TOKEN
node -p 'require("./.labex/delete-gateway.json").success'
预期会看到 true。由于虚拟机中仍保留着两种临时授权,请保存 Worker 和网关已不存在的独立证据:
set +e
npx wrangler deployments list --name "$WORKER_NAME" --json \
  > .labex/worker-after-delete.json 2> .labex/worker-absent.err
printf '%s\n' "$?" > .labex/worker-absent-status.txt
set -e
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
GATEWAY_ID="$GATEWAY_ID" node - <<'NODE'
const rows=require('./.labex/gateways-after-delete.json').result||[];
console.log('gateway absent:', !rows.some(row=>row.id===process.env.GATEWAY_ID));
NODE
grep -Ei '10090|10007|script_not_found|does not exist' .labex/worker-absent.err
预期会看到 gateway absent: true,以及类似 script_not_found、代码 10090、代码 10007 或 does not exist 的 Worker 不存在响应。对于同一个缺失脚本,Wrangler 可能返回不同的错误形式;网络错误和身份验证错误不能作为删除证据。
现在打开 My Profile → API Tokens,删除准确匹配已保存 tokenName 的令牌。最后删除该令牌在虚拟机中的副本并退出登录:
shred -u .labex/gateway-token
npx wrangler logout
npx wrangler whoami --json
预期会看到 loggedIn: false。之后删除虚拟机会移除本地文件,但只有上述命令才能删除远程资源并撤销授权。
总结
你使用两个 Cloudflare 托管模型构建了有界的恢复路径。受控的不兼容主模型请求失败后,一个回退模型恢复了请求;健康的主模型则只调用一次便停止。AI Gateway 日志将应用决策与提供商侧的模型和状态证据关联起来。你还了解了为什么明确的尝试次数限制、安全的元数据和经过验证的清理流程,都是可靠回退设计的一部分。