介绍
备份上传程序应完成成功的上传,并在中断后释放被遗弃的分段。你将拆分一个大小受限的测试文件,完成它的分段上传会话,然后检查并中止另一个未完成的会话,同时不影响已完成的对象。
请先完成之前的 R2 对象和受限凭据实验。本实验使用一台全新的虚拟机,其中已安装 Node.js 22.22.0、Wrangler 4.131.1 和 AWS SDK 3.888.0。你将创建一个新的私有 Standard 存储桶,并为其创建独立的短期凭据。R2 必须处于启用状态;请查看 分段上传限制 和 定价。未完成的分段也会计入存储量。本实验只传输一个很小的测试文件,不需要域名。不要重复使用之前的上传内容或存储桶。
创建私有文档存储桶
在本步骤中,为这台虚拟机授权并创建一个临时存储桶。设备授权用于确认你的学习账户。R2 存储桶管理使用一个仅限该账户的独立 API 令牌。
先启动 Bash,以便使用下面的命令语法,然后进入准备好的项目并检查工具版本。保持当前终端打开,这样资源名称变量才能继续有效:
bash
cd /home/labex/project/r2-lab
export PATH="$PWD/.tools/node-v22.22.0-linux-x64/bin:$PATH"
node --version
npx wrangler --version
在你自己的浏览器中授权显示的设备代码。授予同意前,确认学习账户以及请求的账户和用户读取权限:
npx wrangler login --device --browser=false --scopes account:read user:read
npx wrangler whoami --json
要求输出中包含 loggedIn: true。即使只列出一个账户,也要读取账户名称。将下面的 YOUR_ACCOUNT_ID 替换为该账户实际的 32 位 ID。openssl rand -hex 6 会生成 12 个随机十六进制字符,因此本实验不会与之前的运行冲突。下面的 here-document 会写入一个标准配置文件;Shell 会将变量替换到文件中。
ACCOUNT_ID=YOUR_ACCOUNT_ID
RUN_ID=$(openssl rand -hex 6)
NAME="labex-c05-r06-$RUN_ID"
BUCKET="$NAME-docs"
cat > wrangler.jsonc <<JSON
{"name":"$NAME","account_id":"$ACCOUNT_ID","compatibility_date":"2026-07-30","r2_buckets":[{"binding":"DOCUMENTS","bucket_name":"$BUCKET"}]}
JSON
要管理存储桶,请打开 Cloudflare 个人资料中的 API Tokens 页面,并创建一个以本实验命名的自定义令牌。授予 Account → Workers R2 Storage → Edit 权限,并将 Account Resources 限制为你保存的学习账户 ID。设置较短的过期时间。不要包含其他账户或无关权限。此管理令牌用于管理存储桶,包括创建和删除。本步骤稍后会创建单独的对象令牌,将其权限限定为此存储桶,供 S3 SDK 操作对象。
将令牌一次性复制到这台隐藏的虚拟机提示符中。umask 077 会将文件权限限制为当前用户;read -s 会隐藏输入内容。该文件使用 Wrangler 的标准令牌变量,并且不会被 Git 纳入跟踪。
umask 077
read -r -s -p 'R2 management API token: ' R2_MANAGEMENT_TOKEN; printf '\n'
printf 'CLOUDFLARE_API_TOKEN=%s\n' "$R2_MANAGEMENT_TOKEN" > .env.management
unset R2_MANAGEMENT_TOKEN
仅在 R2 管理命令中使用 --env-file=.env.management;普通的 whoami 仍会检查虚拟机的设备授权。
将 --env-file 放在每条 Wrangler 命令的末尾,避免它的文件参数列表把命令名称也当作参数。创建每个存储桶后,如果 Wrangler 询问是否向配置添加绑定,请输入 n 并按 Enter。配置中已经包含所需的绑定。
npx wrangler r2 bucket create "$BUCKET" --env-file=.env.management
列出你的存储桶并找到准确生成的名称。其他存储桶属于其他任务,请不要改动。
npx wrangler r2 bucket list --env-file=.env.management
在 Dashboard 中打开 Storage & databases → R2 → Overview,选择这个准确的存储桶,并检查其中为空的对象列表。在其设置中,保持公共开发 URL 和自定义域名处于禁用状态。Dashboard 中的存储桶名称可以确认资源身份;稍后的下载检查会验证存储的字节内容。
S3 兼容 API 使标准存储 SDK 能够访问 R2。它使用独立的访问密钥对,而不是 Wrangler 的设备令牌。在 R2 Overview 中,依次选择 Account Details → API Tokens → Manage,然后创建一个以本实验生成的资源名称命名的 User API token。选择 Object Read & Write,将其限制为这个准确的新存储桶;如果表单提供短期过期选项,请选择该选项。不要选择所有存储桶或 Admin 权限。在保存这个一次性密钥之前,请保持令牌页面打开。
在虚拟机中使用以下 Bash 提示符。read -s 会隐藏输入内容;umask 077 会使凭据文件仅对当前用户可读。这些名称是 AWS SDK 使用的标准环境变量。将 Access Key ID 和 Secret Access Key 分别粘贴到对应提示符中,然后按 Enter。不要粘贴通用 API token 的值。
umask 077
read -r -s -p 'Access Key ID: ' AWS_ACCESS_KEY_ID; printf '\n'
read -r -s -p 'Secret Access Key: ' AWS_SECRET_ACCESS_KEY; printf '\n'
printf 'AWS_ACCESS_KEY_ID=%s\nAWS_SECRET_ACCESS_KEY=%s\n' "$AWS_ACCESS_KEY_ID" "$AWS_SECRET_ACCESS_KEY" > .env.s3
unset AWS_ACCESS_KEY_ID AWS_SECRET_ACCESS_KEY
写入一个可重复使用的标准 SDK 客户端。SDK 要求提供区域字符串;R2 使用 auto。读取现有配置,可以确保 CLI 和 SDK 操作都指向同一个账户和存储桶。
cat > storage.mjs <<'JS'
import { S3Client } from "@aws-sdk/client-s3";
import { readFileSync } from "node:fs";
const config = JSON.parse(readFileSync("wrangler.jsonc", "utf8"));
export const Bucket = config.r2_buckets[0].bucket_name;
export const s3 = new S3Client({
  region: "auto",
  endpoint: `https://${config.account_id}.r2.cloudflarestorage.com`,
  credentials: {
    accessKeyId: process.env.AWS_ACCESS_KEY_ID,
    secretAccessKey: process.env.AWS_SECRET_ACCESS_KEY
  }
});
JS
使用 Wrangler 上传要保留的合成手册。完成和中止操作期间,该文件必须保持不变:
npx wrangler r2 object put "$BUCKET/retained/handbook.txt" --remote --file retained.txt --content-type text/plain --env-file=.env.management
开始受限的分段上传
在本步骤中,启动一个 multipart upload:这是一个服务器端上传会话,可以先接收带编号的分段,之后再组装成最终对象。已上传的分段还不是可以下载的对象。保存上传 ID 后,你可以恢复或中止这个准确的会话。
使用 Python 创建一个大小为 6 MiB 的合成二进制文件。第一个分段为 5 MiB,最后一个分段为 1 MiB。R2 要求分段大小符合规定;最后一个分段之外的分段至少必须为 5 MiB,并且使用相同大小。这个小型测试文件可以在不进行大规模传输的情况下演示该协议。
python3 - <<'DATA'
from pathlib import Path
Path("archive.bin").write_bytes(bytes(range(256)) * (6 * 1024 * 1024 // 256))
DATA
cat > start.mjs <<'JS'
import { CreateMultipartUploadCommand } from "@aws-sdk/client-s3";
import { writeFileSync } from "node:fs";
import { s3, Bucket } from "./storage.mjs";
const Key = "exports/archive.bin";
const result = await s3.send(new CreateMultipartUploadCommand({ Bucket, Key, ContentType: "application/octet-stream" }));
writeFileSync("upload.json", JSON.stringify({ Key, UploadId: result.UploadId }));
console.log("Started multipart upload for", Key);
JS
node --env-file=.env.s3 start.mjs
保留 upload.json:它用于标识这次操作,不表示操作已成功。不要无必要地重复运行启动命令;每次调用都会创建另一个未完成的上传,并且之后必须清理。
继续使用创建请求保存的上传 ID。在已测试的 R2 端点中,清单响应使用了不同的不透明 ID 字符串;请核对精确的对象键,并用保存的 ID 调用 ListParts 来确认活动会话。
上传有序分段并完成对象
在本步骤中,发送两个分段,并告诉 R2 哪些返回的分段标识符组成最终对象。分段编号从 1 开始。完成请求必须包含每个分段上传返回的完整 ETag;这与自行计算整个源文件的哈希值不同。
cat > complete.mjs <<'JS'
import { UploadPartCommand, CompleteMultipartUploadCommand, GetObjectCommand } from "@aws-sdk/client-s3";
import { readFileSync, writeFileSync } from "node:fs";
import { s3, Bucket } from "./storage.mjs";
const { Key, UploadId } = JSON.parse(readFileSync("upload.json", "utf8"));
const bytes = readFileSync("archive.bin");
const size = 5 * 1024 * 1024;
const Parts = [];
for (let offset = 0, PartNumber = 1; offset < bytes.length; offset += size, PartNumber++) {
  const result = await s3.send(new UploadPartCommand({ Bucket, Key, UploadId, PartNumber, Body: bytes.subarray(offset, offset + size) }));
  Parts.push({ PartNumber, ETag: result.ETag });
  console.log("Uploaded part", PartNumber);
}
await s3.send(new CompleteMultipartUploadCommand({ Bucket, Key, UploadId, MultipartUpload: { Parts } }));
const object = await s3.send(new GetObjectCommand({ Bucket, Key }));
writeFileSync("completed.bin", await object.Body.transformToByteArray());
console.log("Completed and downloaded", Key);
JS
node --env-file=.env.s3 complete.mjs
要求输出中先出现两行已上传分段的信息,然后出现完成信息。逐字节比较实际下载的文件:
cmp archive.bin completed.bin && printf "Multipart bytes match\n"
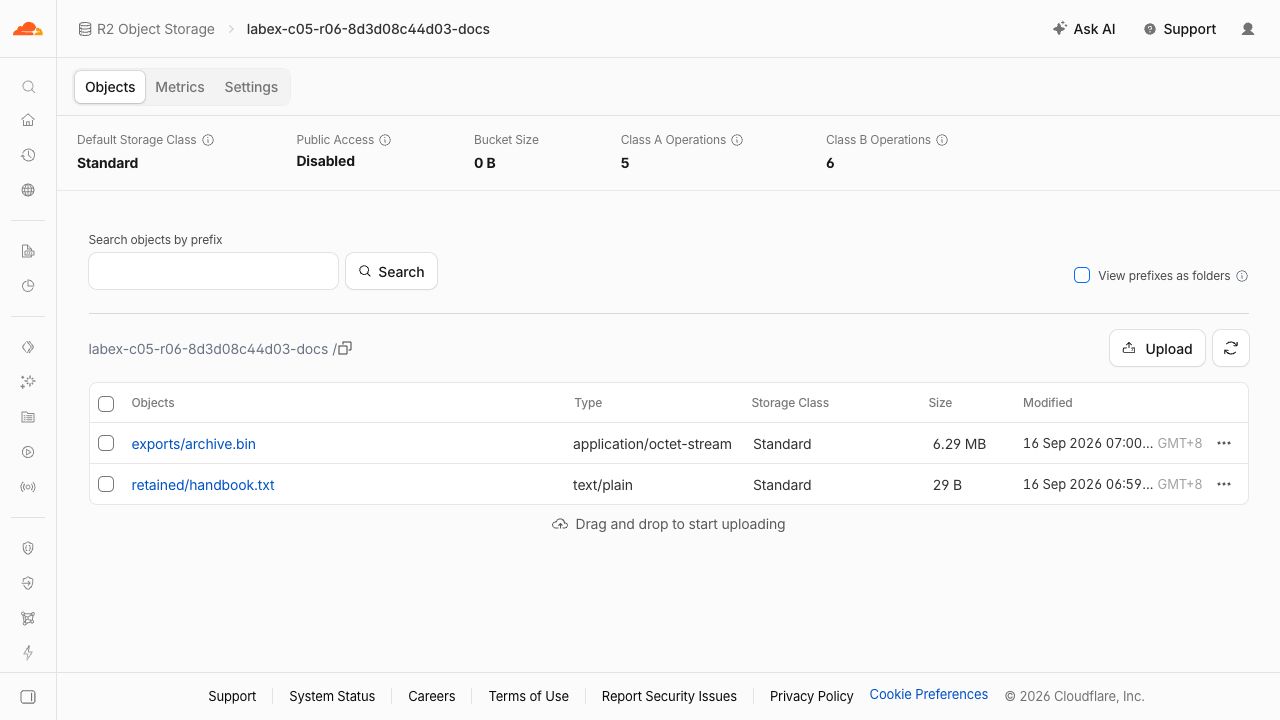
分段对象的 ETag 不一定是最终文件的 MD5 值。字节比较可以直接证明内容保持不变。在 Dashboard 中打开本实验的存储桶并检查 exports/archive.bin;之前保留的手册仍必须存在。
取消勾选 View prefixes as folders,即可像示例一样看到两个完整对象键。你生成的桶名称会不同。归档文件显示的 6.29 MB 是 6 MiB(6,291,456 字节) 的十进制表示。顶部 Bucket Size: 0 B 汇总可能延迟更新;应以对象列表和已验证的 API 字节数据确认存储内容。
检查未完成的上传
在本步骤中,故意创建一个新的未完成上传,然后列出该会话及其分段。即使普通对象列表中不显示已完成的文件,未完成的分段仍会占用存储空间。因此,清理时既需要上传会话清单,也需要对象清单。
cat > abandon.mjs <<'JS'
import { CreateMultipartUploadCommand, UploadPartCommand, ListMultipartUploadsCommand, ListPartsCommand } from "@aws-sdk/client-s3";
import { readFileSync, writeFileSync } from "node:fs";
import { s3, Bucket } from "./storage.mjs";
const Key = "temporary/unfinished.bin";
const result = await s3.send(new CreateMultipartUploadCommand({ Bucket, Key }));
const UploadId = result.UploadId;
writeFileSync("abandoned.json", JSON.stringify({ Key, UploadId }));
await s3.send(new UploadPartCommand({ Bucket, Key, UploadId, PartNumber: 1, Body: readFileSync("archive.bin").subarray(0, 5 * 1024 * 1024) }));
const uploads = await s3.send(new ListMultipartUploadsCommand({ Bucket }));
console.log(uploads.Uploads.map(upload => ({ key: upload.Key, uploadId: upload.UploadId })));
const parts = await s3.send(new ListPartsCommand({ Bucket, Key, UploadId }));
console.log(parts.Parts.map(part => ({ part: part.PartNumber, bytes: part.Size })));
JS
node --env-file=.env.s3 abandon.mjs
分段上传清单包含 temporary/unfinished.bin。ListParts 请求使用保存的上传 ID,必须返回第 1 段及其 5,242,880 字节大小。不要比较清单中的 ID 文本与保存的 ID,也不要为了重复读取而创建另一个会话。使用保存的 ID 和标准清单 API,并在此上传仍存在时运行平台检查。
仅中止被遗弃的会话
在本步骤中,通过中止准确的上传 ID 来释放未完成的分段。中止操作不同于删除已完成的对象,并且必须同时保留已完成的归档文件和手册。
cat > abort.mjs <<'JS'
import { AbortMultipartUploadCommand, ListMultipartUploadsCommand } from "@aws-sdk/client-s3";
import { readFileSync } from "node:fs";
import { s3, Bucket } from "./storage.mjs";
const { Key, UploadId } = JSON.parse(readFileSync("abandoned.json", "utf8"));
await s3.send(new AbortMultipartUploadCommand({ Bucket, Key, UploadId }));
const uploads = await s3.send(new ListMultipartUploadsCommand({ Bucket }));
console.log("Incomplete uploads:", uploads.Uploads || []);
JS
node --env-file=.env.s3 abort.mjs
此时,这个新建的存储桶应显示为空的分段上传列表。平台检查还会下载两个已完成的对象,以证明它们仍未改变。绝不要把列表请求失败解释为空列表。
清理已完成的文件和存储桶
在本步骤中,确认中止检查通过后,删除准确的两个已完成对象。显式清理不必等待默认的未完成上传生命周期规则。
npx wrangler r2 object delete "$BUCKET/exports/archive.bin" --remote --env-file=.env.management
npx wrangler r2 object delete "$BUCKET/retained/handbook.txt" --remote --env-file=.env.management
npx wrangler r2 bucket delete "$BUCKET" --env-file=.env.management
npx wrangler r2 bucket list --env-file=.env.management
确认列表中只有本次生成的存储桶名称。要求在成功的清单中确认该名称已经不存在,然后再运行平台清理检查并撤销凭据。
撤销实验凭据并退出登录
在本步骤中,关闭本实验留下的访问权限。在 R2 API Tokens 页面中,仅撤销以本实验命名的对象令牌。在个人资料的 API Tokens 页面中,撤销为本实验创建的独立 R2 管理令牌。删除存储桶不会撤销令牌,Wrangler logout 也不会撤销 S3 凭据。
撤销令牌后,删除本地凭据文件并退出这台虚拟机的登录状态:
rm .env.s3 .env.management
npx wrangler logout
检查结构化身份信息。退出登录后,命令返回非零状态是预期现象:
npx wrangler whoami --json || true
要求输出中包含 loggedIn: false;保留你在 Dashboard 中的普通登录状态。平台检查会验证本地凭据已删除且 Wrangler 已退出登录。在本实验中,两个令牌的撤销必须通过 Dashboard 手动完成;不能根据文件删除情况推断令牌已经撤销。
总结
使用准确字节完成分段对象,检查并中止未完成的分段,保留其他对象,并清理存储凭据。