Введение
Northline Library помогает читателям находить книги, проверять наличие и просматривать бронирование. Главная страница может выглядеть исправной, когда поиск уже не работает. Ваша задача — контролировать этот результат пользователя и уведомлять команду только при длительном отказе.
Достаточно базовых навыков терминала. Библиотека, Prometheus (сбор данных и правила), Blackbox Exporter (реальные HTTP-проверки), Alertmanager (доставка уведомлений) и локальный ящик готовы. Вы изменяете два коротких YAML-файла; разработка приложения, установка, почтовый аккаунт и внешние сообщения не нужны. Все службы работают на одной учебной машине, книги вымышлены, просмотр бронирования не изменяет данные.
Используйте Library для действий читателя, Workstation для команд, Monitoring для реальных наблюдений и полученных webhook. Сайт и названия элементов остаются английскими. Каждый модуль начинается независимо.
Контроль поиска читателя
На этом шаге вы выберете пользовательскую проверку. Начните в Library: сначала используйте нормальную функцию, затем выберите проверку фактического запроса читателя.
Пройдите путь читателя
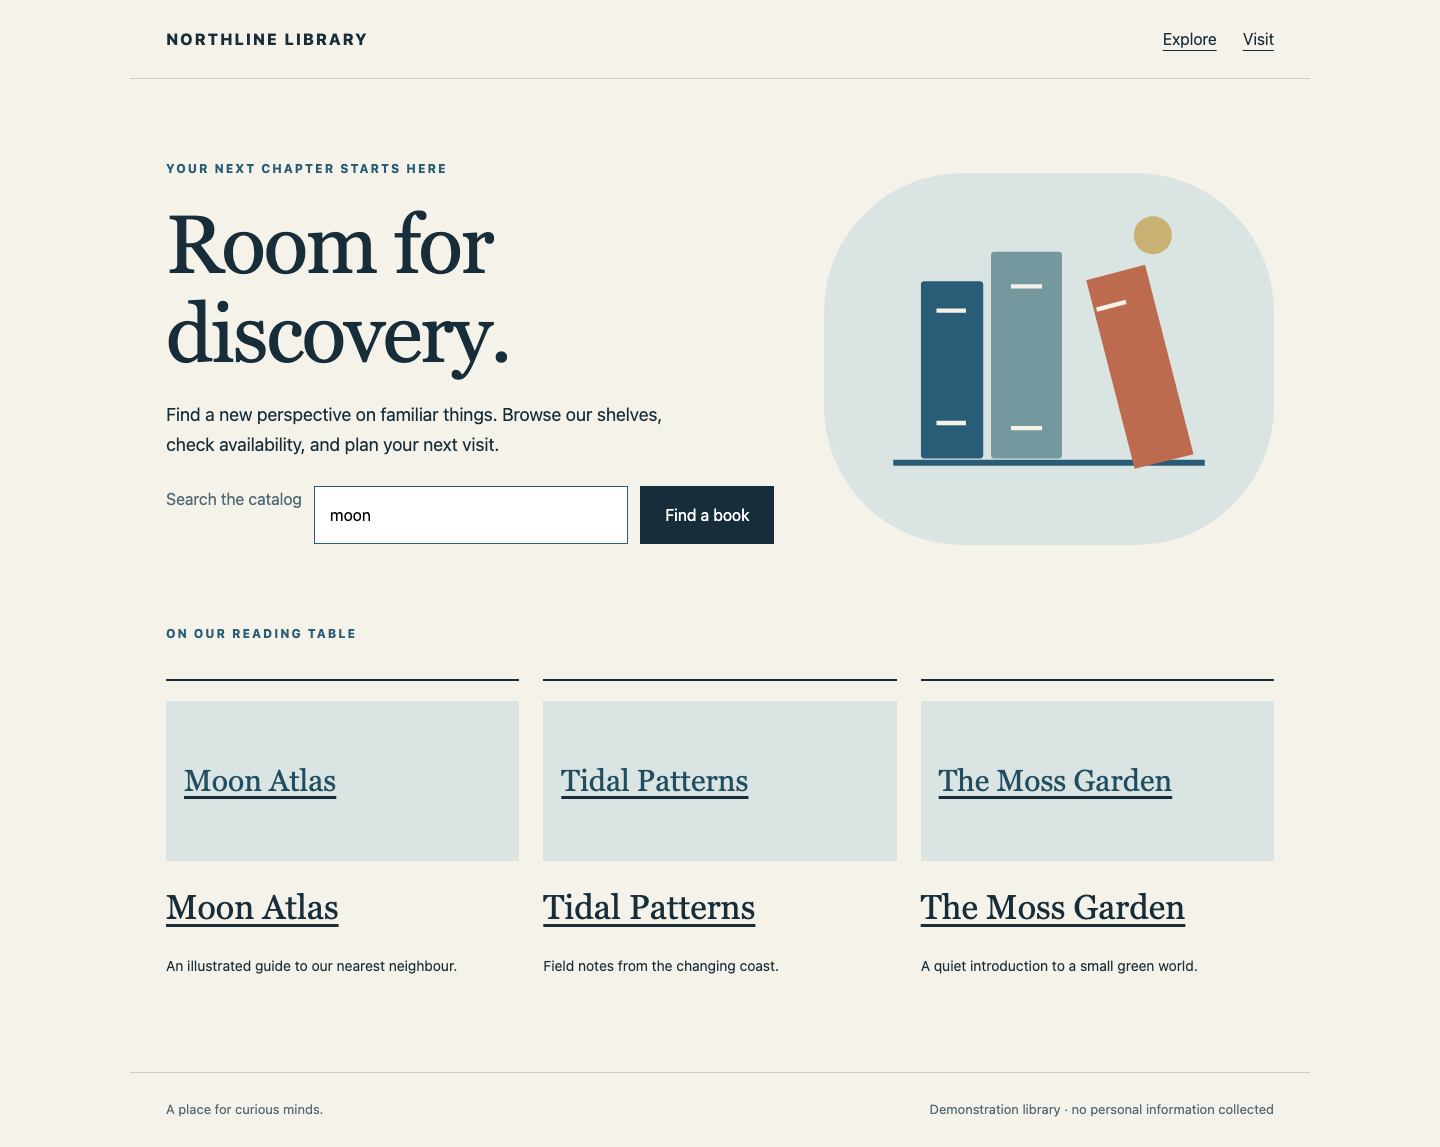
Оставьте moon в Search the catalog и нажмите Find a book. Результаты должны содержать Moon Atlas, Available и место на полке. Откройте Moon Atlas, затем Check reservation: предварительный просмотр показывает Ready to collect: Moon Atlas. Бронирование не создаётся. Выберите Back to book, затем NORTHLINE LIBRARY. Откройте Visit, прочитайте часы работы и вернитесь через ссылку бренда.
Разберитесь в проверке
Перейдите в Workstation, уже находящийся в /home/labex/project/library-watch. Путь указывает на файл или каталог; этот абсолютный путь начинается с корня системы. pwd показывает текущий каталог, ls перечисляет имена, cat выводит файл:
pwd
ls
cat prometheus.yml
Здесь есть prometheus.yml, alerts.yml и watch.sh. Конфигурация описывает поведение программы. YAML использует отступы пробелами, пары key: value и дефис для элемента списка. Сохраните показанные отступы. Редактор не требуется: небольшой файл будет заменён целым блоком текста.
HTTP — протокол запросов и ответов браузера. URL содержит адрес, порт службы и путь. В Workstation 127.0.0.1 означает эту учебную машину. Порт 8081 обслуживает библиотеку; /search?q=moon запрашивает поиск с параметром q, равным moon. Оставляйте URL в кавычках в терминале, чтобы оболочка считала его одним аргументом.
Подготовленное задание library пока проверяет только главную страницу. job — именованная группа целей сбора данных. Экспортер на порту 9115 выполняет реальный запрос и возвращает probe_success: 1 при успехе, 0 при отказе. Модуль search требует содержимое Moon Atlas и Available, а не только статус HTTP 200. Prometheus собирает результат каждые 2 секунды. Отдельная метрика up говорит лишь о возможности опросить экспортер, но не доказывает успех читателя.
Выберите пользовательский путь
cat > prometheus.yml заменяет файл. <<'YAML' начинает here-document с буквальным содержимым: вставьте блок целиком, включая заключительный YAML на отдельной строке. global задаёт интервалы, rule_files указывает правила, alerting подключает подготовленную службу доставки. Сохраните эти параметры и измените модуль и цель на поиск. Метка journey: search обозначает бизнес-область.
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload запускает подготовленную утилиту: она проверяет синтаксис, затем просит Prometheus перечитать конфигурацию. Она не изменяет библиотеку и не подделывает наблюдения.
bash watch.sh reload
Ожидайте Configuration accepted. Через примерно 4 секунды перейдите в Monitoring. В Business probes должно быть search: healthy. При ошибке YAML вернитесь в Workstation, замените файл полным блоком и повторите загрузку. Если данные unavailable, подождите и повторите: отсутствие данных никогда не означает healthy. Не направляйте проверку на сам Monitoring.
Сравните доступность и результат
Перейдите в Workstation. fault search seconds 6 отключает только поиск на 6 реальных секунд, затем автоматически восстанавливает его. Состояние оповещения эта команда не задаёт. curl отправляет HTTP-запросы; -sS скрывает прогресс, но показывает ошибки соединения. Выполните:
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
В ответе появится Search is taking a break. Сервер намеренно возвращает HTTP 200: проверка только статуса пропустила бы бизнес-отказ. Сразу перейдите в Monitoring: за один интервал поиск должен стать failed, затем вернуться в healthy после восстановления. Если пропустили короткий момент, повторите те же 6 секунд. Оповещение ещё не настроено. Дождитесь healthy перед проверкой шага.
Оповещать только о длительном отказе
На этом шаге вы настроите пользовательское оповещение с ожиданием, позволяющим игнорировать только что увиденный краткий сбой. Начните в Workstation.
Прочитайте условие
Prometheus вычисляет правила каждые 2 секунды. probe_success{job="library",journey="search"} == 0 выбирает неудачные проверки поиска из задания library. В фигурных скобках находятся фильтры меток; == 0 выбирает отказ, а не успех. Только up контролировало бы сбор, а не читателей. Без меток могут попасть посторонние сервисы.
for: 20s требует непрерывного выполнения условия 20 секунд. pending означает, что условие есть, но ожидание ещё продолжается; firing — что нужная длительность достигнута; inactive — что условия нет. 20 секунд выбраны для короткого упражнения, а не как универсальная рекомендация для эксплуатации. Отсутствующие данные показаны в Monitoring как unavailable: это не доказательство исправности и не измеренный отказ бизнеса.
alert задаёт имя правила. severity — метка маршрутизации, annotations.summary описывает последствия для клиента. Запишите полное правило:
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
Ожидайте Configuration accepted. Если проверка не прошла, исправьте пробелы или знаки и перезагрузите. Последняя корректная конфигурация действует, пока новая не принята.
Перейдите в Monitoring. При исправном поиске правило должно показывать CustomerJourneyFailed: inactive (20 seconds). Локальный ящик пока должен быть пуст.
Докажите, что краткий сбой не беспокоит
Перейдите в Workstation и повторите тот же краткий отказ:
bash watch.sh fault search seconds 6
Сразу перейдите в Monitoring. Поиск отказывает, правило может ненадолго стать pending. После автоматического восстановления проверка и правило возвращаются в healthy/inactive. Ящик остаётся пустым. Полный цикл занимает около 12 секунд. Если вы уже запускали длительный отказ, старые сообщения сохранятся: сравнивайте новые события, не удаляя доказательства.
Правило firing и доставленное сообщение — разные факты. Alertmanager получает firing-оповещения, группирует их, ждёт 1 секунду для новой группы и доставляет в локальный webhook-ящик. Сбор, вычисление и доставка добавляют небольшие задержки. Не убирайте for и не снижайте все пороги лишь потому, что сообщение не мгновенное.
Получите уведомления об отказе и восстановлении
На этом шаге вы создадите длительный отказ и увидите реальную доставку уведомлений. Начните в Workstation.
Наблюдайте длительный отказ
Следующий отказ длится 60 реальных секунд, оставляя время увидеть состояния. Не работает только поиск, главная страница остаётся доступной.
bash watch.sh fault search seconds 60
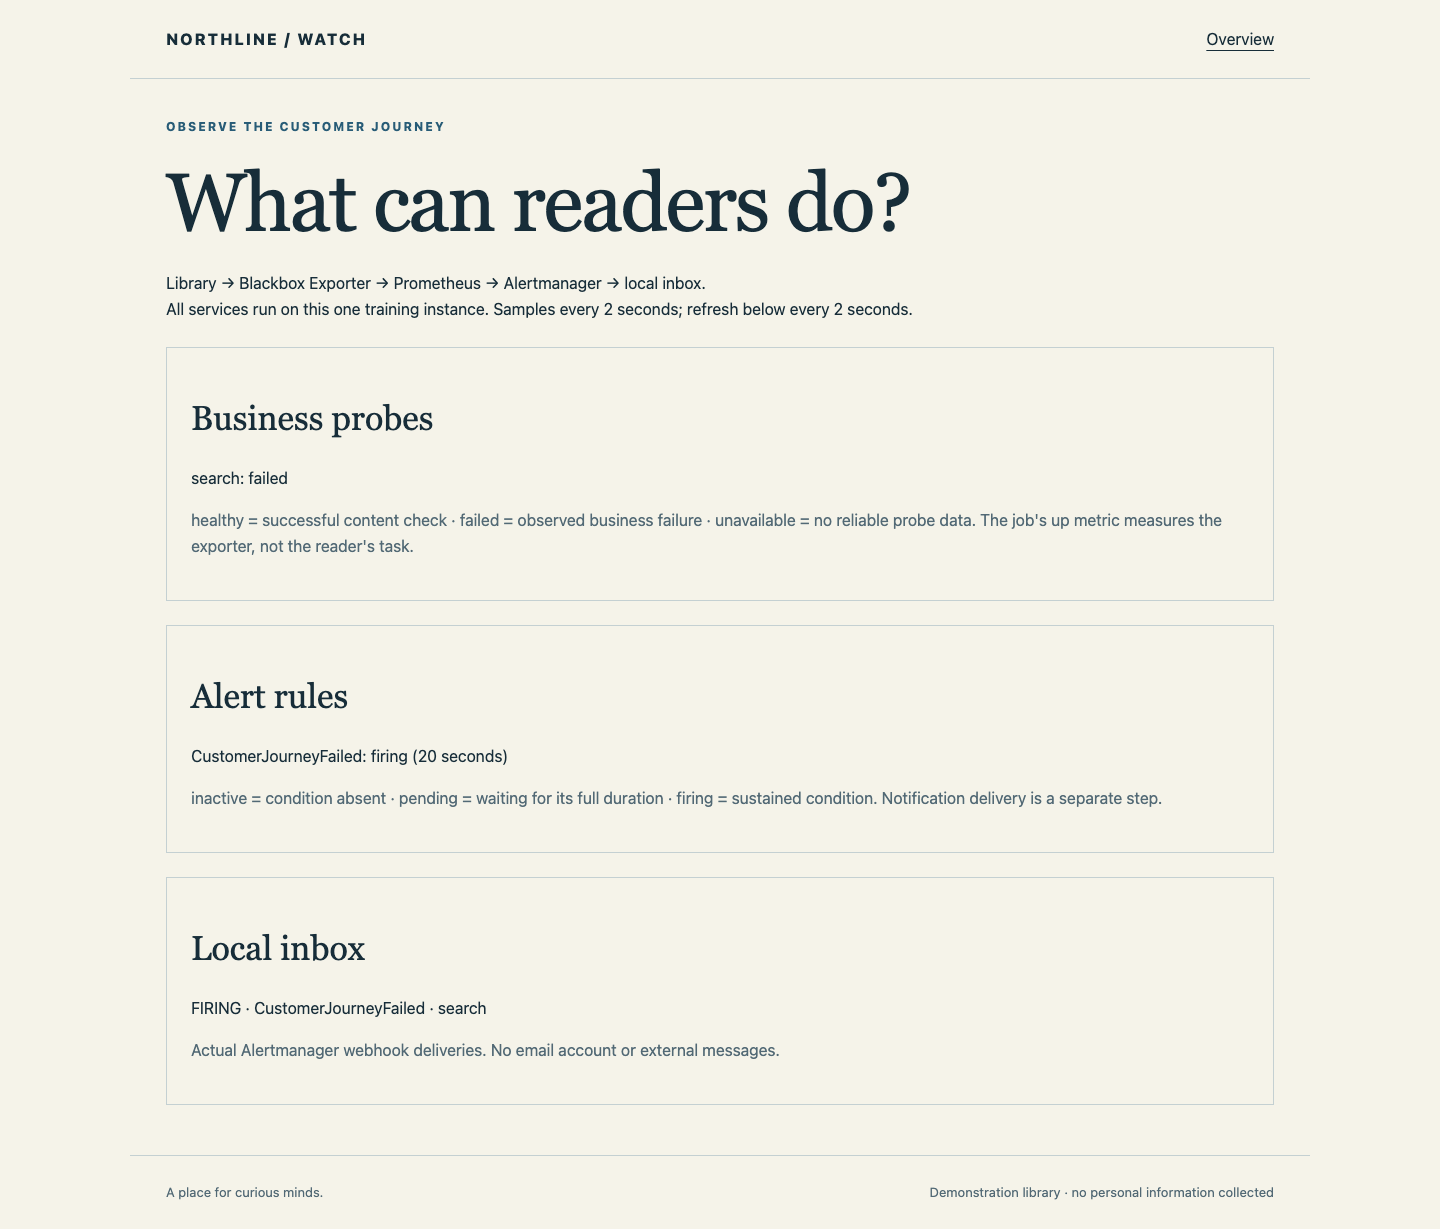
Перейдите в Library. Вернитесь на главную через бренд: всё выглядит нормально. Снова найдите moon. Ошибка показывает, что читатель не может пользоваться каталогом. Перейдите в Monitoring. Поиск показывает failed, правило сначала pending. Примерно через 20 секунд после первой неудачной проверки оно станет firing; затем в ящике должно появиться FIRING · CustomerJourneyFailed · search. От начала отказа отведите до 35 секунд на сбор, вычисление и доставку. Это реальные наблюдения, а не анимация прогресса.
Если через 35 секунд ящик пуст, перейдите в Workstation и используйте команду состояния, которая ничего не изменяет:
bash watch.sh status
Посмотрите checks и alerts: unavailable означает отсутствие сбора; pending — недостаточную длительность; firing без события в ящике указывает на доставку. Перечитайте конфигурацию и перезагрузите её после исправления. Завершившийся 60-секундный отказ можно повторить. Не создавайте поддельные сообщения и не отключайте мониторинг.
Восстановите и подтвердите разрешение
Перейдите в Workstation. Ноль секунд восстанавливает поиск сразу, даже до автоматического завершения:
bash watch.sh fault search seconds 0
Перейдите в Library и повторите поиск moon с главной. Moon Atlas и Available должны вернуться. Снова откройте книгу и просмотр бронирования; Visit также должен работать.
Перейдите в Monitoring. Примерно за 10 секунд поиск станет healthy, оповещение inactive, а в ящике появится RESOLVED · CustomerJourneyFailed · search. Исходное firing-сообщение останется. resolved означает устранение этого отказа, но не гарантирует отсутствие будущих.
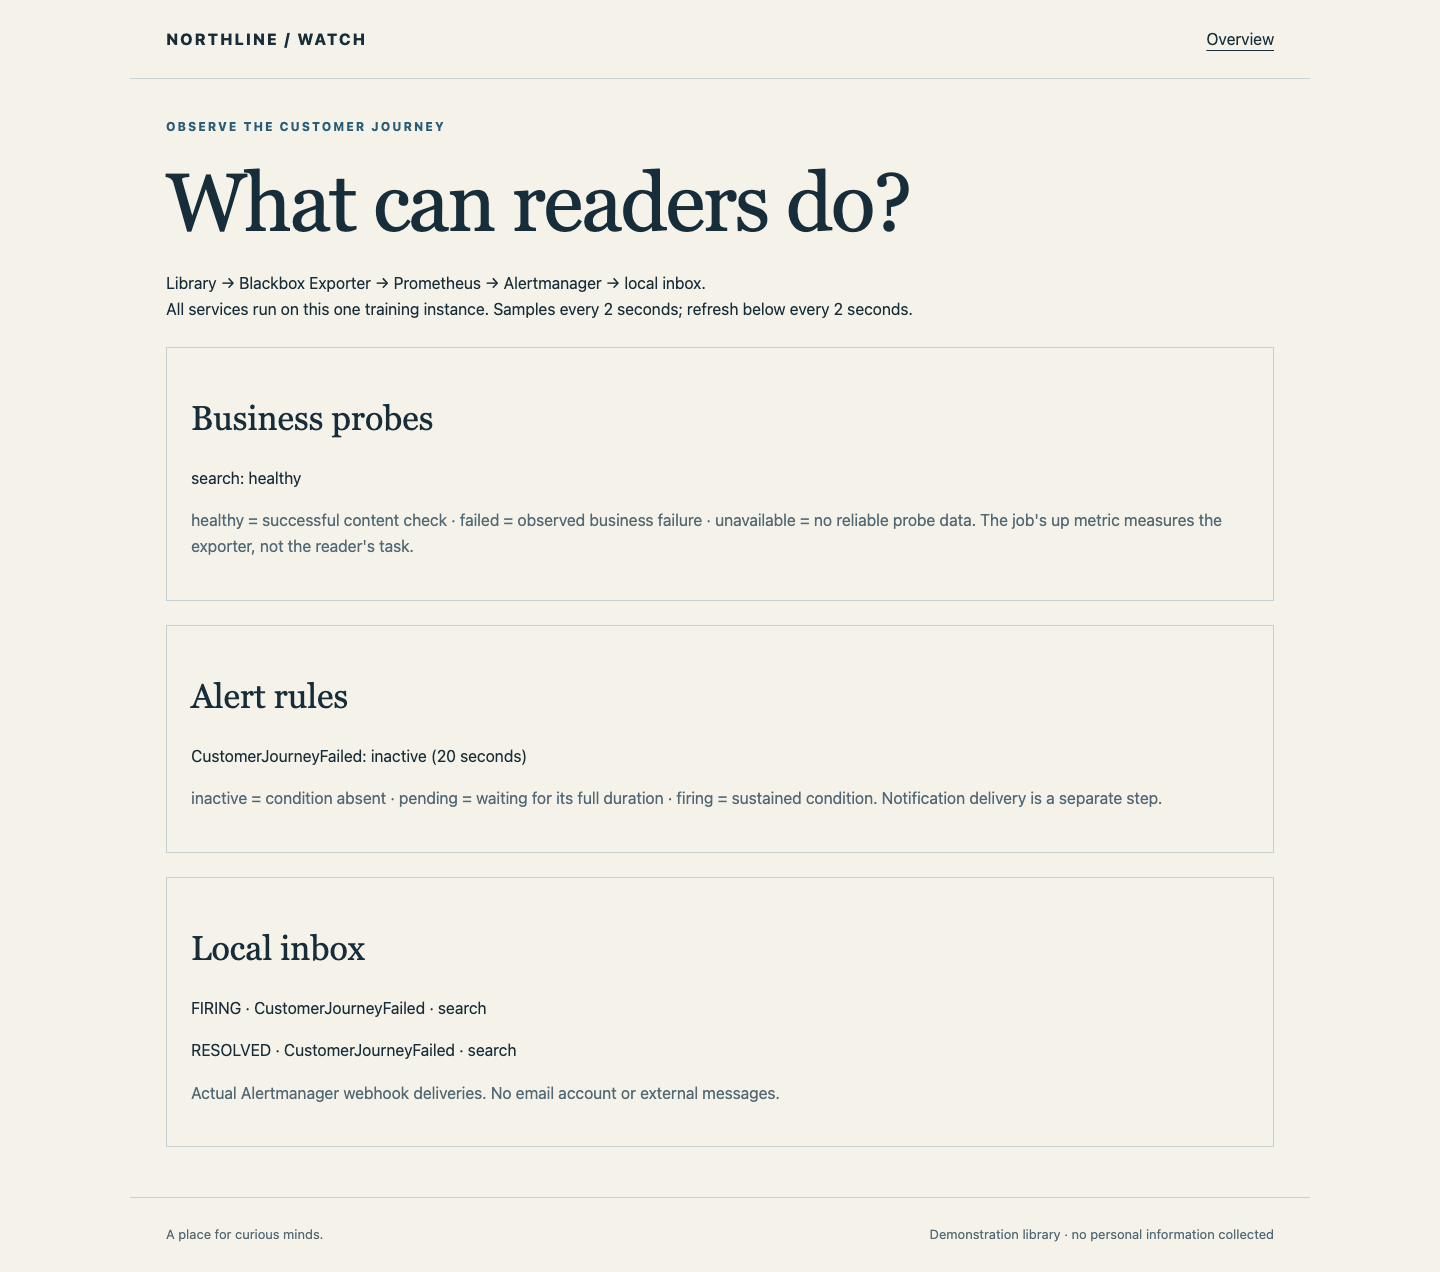
Шаг проверяет реально доставленную пару firing/resolved и текущую работоспособность библиотеки. Также он проверяет загруженное правило на изолированных данных: исправность, краткий и длительный отказ, восстановление, отсутствие данных и посторонний отказ. Оценивание не создаёт отказов, не восстанавливает сервис и не меняет конфигурацию. Оставьте библиотеку исправной, а правило готовым к будущим сбоям.
Резюме
Вы выбрали реальный поиск читателя и проверку содержимого, ограничили оповещение метками, проигнорировали краткий сбой и получили настоящие webhook об отказе и восстановлении. Вы различаете работающий экспортер и работающий бизнес, отсутствие данных и успех. Самостоятельная задача применяет методы к подтверждению бронирования, исключая посторонний неисправный сервис.