Введение
Сравнение назначенных людей мастерской даёт странице B более высокую долю регистраций. Может ли одно лишь случайное распределение создать группы, которые выглядят различными, даже если страница не меняет ничей исход? Небольшой ручной обмен делает вопрос наглядным перед созданием распределения действительно случайных разностей.
В этой независимой среде уже есть изученные ранее правильные функции построения исходов и сравнения долей, а также собственные исходные данные. Предполагается знание этих идей, функций Python, простых массивов NumPy и основ Matplotlib. Файлы предыдущей VM и знания статистического вывода не нужны. Вы сохраните 399 исследовательских перераспределений и их настоящий график; здесь не будет вычисления p-значения или выбора победителя. Все записи — оригинальные синтетические учебные примеры. 55 минут — оценка автора с учётом чтения и исправления обычных ошибок.
Обменяйте людей, сохранив размеры групп
На этом шаге вы рассчитаете разность для шести людей, обменяете две принадлежности к группам и увидите, почему сравнение может измениться.
В WebIDE откройте Terminal → New Terminal и перейдите в каталог этого модуля:
cd /home/labex/project/signup-experiment
cat читает файлы, не меняя их. Перечитайте тренировочные карточки и две подготовленные функции:
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
У шести карточек бинарные исходы [1, 0, 0] в A и [1, 1, 0] в B. Каждая 1 или 0 принадлежит назначенному человеку; повторные события не являются дополнительными наблюдениями. В A зарегистрировалась 1/3, в B — 2/3, и B−A составляет примерно +33.33 процентного пункта.
Представьте обмен принадлежностями второго человека A (исход 0) и первого человека B (исход 1). A становится [1, 1, 0], B — [0, 1, 0], а разность близка к −33.33 процентного пункта. В каждой группе по-прежнему три человека, и всего остаётся три положительных исхода. Изменилось распределение, а не индивидуальные исходы или размер выборки.
Напишите функцию разности. np.mean вычисляет среднее бинарных значений массива NumPy. Вычитание среднего A из среднего B и последующее умножение на 100 даёт процентные пункты. Заготовку sample_null вы завершите позже; определение функции не запускает её.
Символ оболочки > заменяет файл. Here-document с кавычками <<'PY' копирует полный блок до последнего PY без подстановок оболочки. Можно также сохранить то же содержимое через File → Save в WebIDE.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
Этап contrast программы запуска передаёт исходные карточки и в точности описанный обмен, дважды вызывает вашу функцию и сохраняет оба фактических результата:
python3 run.py contrast
Программа просмотра показывает сохранённый результат, не создавая его заново:
python3 show_results.py contrast
Ожидайте original_pp около +33.33 и swapped_pp около −33.33. Ни одно число не предсказывает, что случится с реальным человеком на другой странице. Они показывают, как состав групп меняет сравнение при неизменных шести исходах.
Можно редактировать resample.py, затем plot.py, или добавлять рядом обычные вспомогательные файлы Python. Сохраните исходные CSV, настройки, словарь, программу запуска и просмотра. Если каталог неверен, используйте pwd и ls, затем повторите приведённый выше cd. Ошибку редактирования исправьте повторным копированием полного блока; setup отказывается перезаписывать существующий рабочий каталог.
Создайте настоящие перераспределения
На этом шаге вы многократно перемешаете полные исходы посетителей в группы исходных размеров и сохраните каждую полученную разность.
Продолжайте в том же терминале WebIDE, в /home/labex/project/signup-experiment. В полной фиксированной выборке 12 назначенных людей, по шесть в группе. Подготовленная функция исходов использует полные семидневные окна. Прочитайте фактические полные входы, если хотите снова найти пограничные случаи и людей без событий:
cat assignments.csv
cat events.csv
При используемом здесь нулевом предположении об отсутствии эффекта назначенная страница не меняет бинарный исход ни одного человека. Поэтому перераспределение этих фиксированных индивидуальных исходов между двумя группами показывает вариацию, ожидаемую только от распределения. Это предположение опирается на план рандомизированного эксперимента, представленный синтетическими записями. Перемешивание произвольного наблюдательного журнала сайта не создаёт рандомизированный эксперимент.
np.concatenate([a, b]) объединяет два массива. np.random.default_rng(seed) создаёт генератор псевдослучайных чисел с воспроизводимым начальным состоянием. Его метод permutation возвращает перемешанную копию, не меняя объединённый оригинал. Срез shuffled[:len(a)] берёт первую часть размером с A, а shuffled[len(a):] — оставшуюся часть размером с B. В каждом розыгрыше каждый человек используется один раз, и оба размера групп сохраняются. Не перемешивайте повторяющиеся строки исходных событий.
Замените файл двумя полными функциями. Цикл for выполняет требуемое количество розыгрышей; append сохраняет каждую рассчитанную разность. Возврат массива сохраняет всю выборку, а не только среднее или удачный розыгрыш.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
Программа запуска вызывает эти функции на полной выборке людей и сохраняет реальные численности групп, наблюдаемую разность и 399 перемешанных разностей. --seed передаёт воспроизводимое начальное состояние; два дефиса обозначают именованную опцию команды.
python3 run.py sample --seed 17
python3 show_results.py sample
В полных данных всё ещё зарегистрировался 1 из 6 людей A и 5 из 6 в B; наблюдаемая разность около +66.67 процентного пункта. null_count должен быть 399. Чтобы вывод был компактным, программа просмотра показывает только первые восемь розыгрышей как null_preview; полный массив сохранён в output/sample.json.
Создайте вторую обычную выборку, чтобы понять, почему seed не является обязательным эталонным ответом:
python3 run.py sample --seed 42
python3 show_results.py sample
Это заменяет сохранённую выборку фактическим запуском с seed 42. Последовательность обычно меняется, а исходные индивидуальные исходы, размеры групп и наблюдаемое сравнение остаются прежними. Повтор того же seed должен воспроизвести ту же последовательность. Допустимы любой неотрицательный воспроизводимый seed и эквивалентная реализация независимых розыгрышей; последовательность автора не требуется. Не повторяйте запуск в поиске выборки, которая будто бы поддерживает страницу. Последующий точный анализ использует все распределения, а не самую красивую исследовательскую выборку.
Каждая перемешанная статистика лежит между −100 и +100 процентными пунктами, хотя не каждое число интервала достижимо. Для тренировки с шестью людьми все 20 различных распределений по три человека дают частоты 1, 9, 9, 1 при разностях −100, −100/3, +100/3, +100. У полной выборки из 12 людей 924 распределения: частоты 1, 36, 225, 400, 225, 36, 1 соответствуют −100, −200/3, −100/3, 0, +100/3, +200/3, +100. Следующая работа выполняет точное вычисление вместо требования запомнить числа.
Для этой исследовательской учебной задачи выборочная частота каждой достижимой разности может отличаться от точной эталонной частоты не более чем на 0.15 в абсолютной разности долей. Например, 0.40 и 0.46 различаются на 0.06. Это намеренно широкий учебный допуск приёмки, а не доверительный интервал, порог значимости, бизнес-гарантия или критерий выбора seed. Он допускает обычные выборки и независимые методы, не требуя одинаковых массивов. В корректном примере с одними нулями каждая разность перераспределения нулевая; ненулевой разброс не обязателен.
Контракт функции применяется к переданным бинарным массивам и таким же ограниченным вариантам курса: не менее двух людей в каждой группе и не более 14 всего. Проверки используют изолированные входы и seed, включая другие размеры групп, отрицательные и нулевые разности, вырожденные исходы. Они никогда не заменяют текущую выборку. Выборочное p-значение не требуется и не оценивается.
Постройте график сохранённых разностей
На этом шаге вы покажете фактическое выборочное количество для каждой разности и отметите положение неизменного наблюдаемого сравнения.
Продолжайте в том же терминале WebIDE, в /home/labex/project/signup-experiment. np.unique(..., return_counts=True) возвращает различные сохранённые разности и числа их появлений. Это график дискретных количеств: вертикальная ось говорит, сколько из 399 перераспределений дали каждую разность. Это не доверительный интервал эффекта.
Функция графика получает сохранённый результат и путь вывода. Для читаемости PNG должен иметь размер не менее 500 × 250 пикселей. figsize=(9, 4.5) задаёт размер рисунка в дюймах. DPI (dots per inch, точек на дюйм) задаёт сохраняемое растровое разрешение: 140 пикселей на дюйм даёт примерно 9 × 140 на 4.5 × 140, то есть 1260 × 630 пикселей. subplots в Matplotlib создаёт рисунок и оси. bar рисует количества, а axvline отмечает наблюдаемую разность, не выдавая её за ещё одно количество распределений. Подпись и видимая легенда определяют эту отметку. Постоянные горизонтальные границы от −110 до +110 оставляют место для любой возможной разности бинарных долей, даже если крайнее значение отсутствует в этой конечной выборке. Вертикальная ось начинается с нуля; tight_layout оставляет место подписям перед записью настоящего PNG через savefig.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Прочитайте существующую сохранённую выборку и нарисуйте её своей функцией:
python3 run.py plot-sample
В проводнике WebIDE раскройте signup-experiment/output и откройте sample.png. Прочитайте обе подписи осей. Большинство количеств должно сосредоточиться около нулевой разности; красная наблюдаемая отметка остаётся около +66.67 процентного пункта. Отсутствующее в выборке значение имеет количество ноль, а не означает пропущенного человека. Все 399 розыгрышей и все 12 исходных людей по-прежнему представлены в сохранённых данных.
Эталонное изображение ниже использует только что выполненный пример NumPy с seed 42. Другой разрешённый способ розыгрыша или seed может изменить высоты столбцов; ваш файл должен показывать собственные фактические розыгрыши.
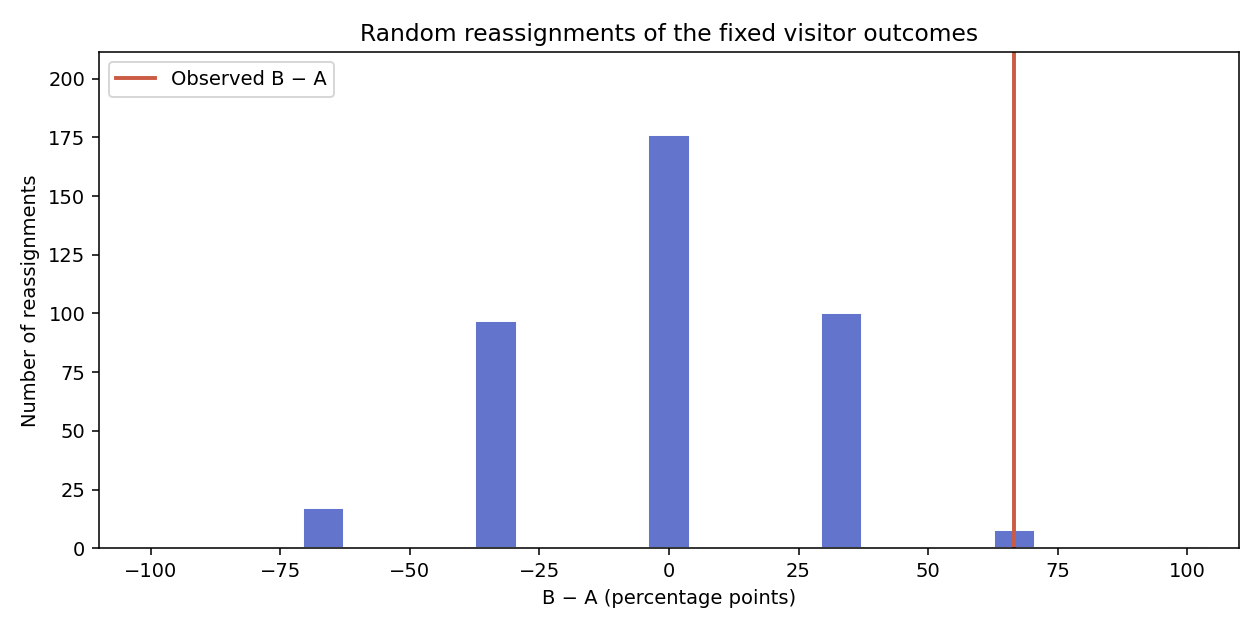
Сохранённый PNG должен воспроизводиться из текущей функции графика и сохранённой выборки. Допустимы читаемые столбцы, линия количеств или точки в фактических значениях разности, с видимой линией или точкой Observed на наблюдаемой разности. Все возможные разности и наблюдаемая отметка должны оставаться внутри показанных осей; сохраните нулевую базовую линию количеств и подпишите обе оси. Скрытие отметки, обрезка данных, копирование постороннего изображения или график плотности с подписью количества не выполняют задачу.
Если PNG отсутствует, сначала убедитесь, что python3 show_results.py sample читает сохранённую выборку, затем повторите команду графика. Программа просмотра сама не создаёт отсутствующие файлы. В следующей работе вы сравните точное распределение с наблюдаемым результатом и узнаете, что эти свидетельства говорят и чего не говорят.
Резюме
Вы вручную обменяли две принадлежности к группам, создали 399 настоящих перераспределений посетителей при постоянных размерах групп и построили график сохранённых разностей с наблюдаемым сравнением. Воспроизводимый seed позволяет повторить запуск; он не выбирает ответ или страницу-победителя. Теперь у вас есть интуиция для чтения точных свидетельств в следующей работе.