Введение
Исследовательский график перераспределений показывает, как фиксированные индивидуальные исходы дают разные сравнения групп. Эта работа продолжает анализ: подсчитывает каждое различное распределение маленькой фиксированной выборки, точно определяет двустороннее p-значение и записывает, что поддерживают данные.
В независимой среде уже подготовлены правильные функции исходов людей и сравнения. Предполагается знание индивидуальных окон, разностей в процентных пунктах и перераспределений с постоянными размерами групп из предыдущих работ, а также основ Python, NumPy и Matplotlib. Файлы прошлой VM и предварительные знания p-значений не нужны. Эти оригинальные синтетические учебные данные не являются реальным бизнес-экспериментом; ни большая наблюдаемая разность, ни маленькое p-значение не гарантируют результат в рабочей системе. 55 минут — оценка автора с учётом чтения и исправления обычных ошибок.
Подсчитайте каждое различное распределение
На этом шаге вы замените конечную случайную выборку полным распределением назначений и рассчитаете явно определённое двустороннее p-значение.
Начните в WebIDE, откройте Terminal → New Terminal и перейдите в рабочий каталог:
cd /home/labex/project/signup-experiment
Прочитайте исходные определения и настройки до просмотра результата теста:
cat data-dictionary.md
cat config.json
Анализ использует одну фиксированную выборку с полностью завершённым наблюдением и один бинарный исход регистрации на человека. Последующая интерпретация использует уже выбранное alpha = 0.05. Альфа — условный порог сравнения для упражнения, а не 95-процентная вероятность того, что страница работает. Он не выбран после поиска благоприятного результата. Не меняйте данные, момент анализа, порог или совокупность после просмотра сравнения.
При нулевом предположении об отсутствии эффекта страницы исход каждого человека не зависел бы от назначенной страницы. Представленный рандомизированный план позволяет перераспределять эти фиксированные исходы с сохранением размеров обеих групп. Такой вывод не применяется автоматически к произвольному неслучайному наблюдательному журналу.
Точное распределение назначений включает каждый различный способ разбить людей на две группы. Порядок внутри группы не создаёт дополнительного назначения для статистики на основе средних. math.comb(n, k) в Python считает способы выбрать k людей из n. Здесь выбор шести людей A из 12 также определяет шестерых B.
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
Для этого эксперимента количество равно 924, а для любого предоставленного примера курса — не более 3432. При намеренно малом размере полный перебор практичен; метод не обещает перебрать произвольные большие рабочие выборки.
Для статистики B−A в процентных пунктах курс следует точному соглашению SciPy two-sided:
Сначала найдите долю точных разностей распределений, меньших или равных наблюдаемой разности. Отдельно найдите долю больших или равных ей. Удвойте меньшую из двух долей и ограничьте результат единицей.
Равные значения входят в оба соответствующих хвоста. Это определённое двустороннее p-значение; определения не универсальны. Подсчёт abs(null) >= abs(observed) не всегда эквивалентен для асимметричного дискретного распределения. Например, группа A из двух людей без регистраций и группа B из пяти с двумя регистрациями дают наблюдаемые +40 пунктов. Их 21 распределение даёт −100 один раз, −30 десять раз и +40 десять раз. Определённое p-значение равно 2 * 10 / 21 = 20/21; доля абсолютного хвоста была бы 11/21. Нельзя молча менять группировку или определение ради меньшего числа.
Используйте подготовленный интерфейс SciPy permutation_test. permutation_type="independent" перераспределяет наблюдения между независимыми группами, сохраняя размеры; посетители не считаются парными измерениями. vectorized=False означает, что статистика получает обычные одномерные массивы. n_resamples=np.inf запрашивает всё конечное распределение вместо 399 случайных розыгрышей. alternative="two-sided" выбирает соглашение выше. Для такого точного перебора случайный seed не нужен.
Выбор DataFrame .loc[mask, "signed_up"] выбирает этот столбец для подходящих людей; .to_numpy() делает значения одномерным массивом NumPy. Внутренняя функция statistic использует формулу разности из предыдущей работы и полностью определена здесь, поэтому модуль не зависит от resample.py другой VM.
result.statistic, result.pvalue и result.null_distribution — фактически вычисленные величины. Сохраните неокруглённые числовые значения; .tolist() превращает массив в совместимый с JSON список, не удаляя повторные разности разных распределений.
Символ оболочки > заменяет файл; here-document с кавычками <<'PY' копирует весь блок до последнего PY без подстановок оболочки. Можно вместо этого редактировать файл в WebIDE и использовать File → Save.
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
Этап distribution программы запуска вызывает анализ и сохраняет его фактические результаты, пока ещё не требуя функцию интерпретации:
python3 run.py distribution
Программа просмотра показывает существующие данные, пропуская длинный массив только в выводе терминала:
python3 show_results.py exact
Ожидайте 12 людей: одну регистрацию среди шести людей A и пять среди шести B, наблюдаемую разность около +66.67 пункта, null_count 924 и p около 0.08009. Полное распределение остаётся в output/analysis.json. Поле интерпретации появится на следующем шаге.
Можно менять inference.py и plot.py или добавлять рядом обычные вспомогательные файлы Python. Сохраните исходные CSV, настройки, словарь, программу запуска и просмотра. Подготовленные outcomes.py и compare.py реализуют уже изученные функции; эквивалентные реализации допустимы при сохранении их открытых контрактов DataFrame/объектов и корректных исходов. Изолированные проверки охватывают другие ограниченные размеры групп, противоположные направления, нулевые разности и полностью нулевые исходы. Фиксированное p-значение или фиксированное распределение — не многократно используемый анализ.
При обычной ошибке пути или имени файла используйте pwd и ls, повторите начальный cd, затем скопируйте полный блок ещё раз. Setup не предназначен для восстановления редактирования: он намеренно отказывается перезаписывать существующий рабочий каталог.
Отделите свидетельства от уверенности
На этом шаге вы добавите прозрачное правило интерпретации, способное сообщать любое направление или недостаточность свидетельств.
Продолжайте в том же терминале WebIDE, в /home/labex/project/signup-experiment. P-значение описывает сравнение при выбранных нулевом предположении и плане распределения. Это не вероятность истинности нулевого предположения, не вероятность отсутствия эффекта страницы и не гарантия для следующей мастерской.
Наблюдаемые +66.67 пункта кажутся большими, однако точное p-значение около 0.08009. При этой фиксированной малой выборке и заранее выбранной альфе 0.05 упражнение сообщает неубедительность свидетельств. Это не доказывает идентичность страниц. Это означает, что конкретный тест и выборка не дают выбранного уровня свидетельств против нулевого предположения.
Используйте явные выходные метки:
evidence_for_b, когда p <= alpha и разность положительна;evidence_for_a, когда p <= alpha и разность отрицательна;inconclusiveиначе, включая нулевую разность.
Равенство порогу относится к ветви свидетельств: p == alpha удовлетворяет <=. Не округляйте p перед сравнением. Это метки ограниченного анализа, а не автоматическое бизнес-решение о внедрении. Другой допустимый эксперимент может поддержать A или ни одну страницу; никакая метка не обязана поддерживать B.
Символ оболочки >> добавляет в существующий файл вместо замены. Следующий полный блок добавляет conclude под analyze; вставьте его один раз. При редактировании в WebIDE добавьте функцию в конец и сохраните. Оператор Python and требует выполнения обоих условий перед возвратом метки из ветви.
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
Снова выполните точный анализ через этап интерпретации. Он намеренно заменяет файл результата полным текущим анализом, который также содержит метку:
python3 run.py exact
python3 show_results.py exact
Для полной выборки результат должен содержать inconclusive. Наблюдаемая разность, исходное p-значение и 924 разности распределений остаются прежними. Не удаляйте людей, не выбирайте отдельную дату, не меняйте реальные группы и не подставляйте исследовательскую случайную выборку ради желаемой метки. Всё необходимое семидневное наблюдение уже завершено; изменение правила остановки или добавление данных выходит за рамки упражнения.
Сохраните читаемый вид точных свидетельств
На этом шаге вы построите полное сохранённое распределение и обозначите наблюдаемое сравнение, не скрывая контекст.
Продолжайте в том же терминале WebIDE, в /home/labex/project/signup-experiment. Этот график использует точное распределение в result["analysis"], а не исследовательскую выборку другого модуля. np.unique(..., return_counts=True) считает, сколько различных распределений дают каждую разность; сумма высот для текущих данных должна быть 924. Повторные значения содержательны и не должны удаляться из исходного распределения.
Некоторые точные количества в хвостах равны всего одному распределению. Видимые точечные маркеры сохраняют читаемость этих редких количеств над нулевой базовой линией. Соединительная линия помогает следить за дискретными точками; она не означает достижимость каждой промежуточной разности.
Горизонтальная координата — разность B−A в процентных пунктах, вертикальная — число распределений. Видимая отметка Observed указывает фактическое сравнение. Округлённое p-значение в заголовке нужно только для отображения; сохранённое число и интерпретация используют неокруглённое значение. Полный возможный диапазон разностей и нулевая база количеств остаются видимыми, включая обоснованные нули и крайние значения.
Сохраните PNG не менее 500 × 250 пикселей. Как и раньше, рисунок 9 × 4.5 дюйма при DPI 140 имеет примерно 1260 × 630 пикселей; разрешение оставляет место читаемым осям и маркерам редких количеств.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Создайте PNG из действительно сохранённого анализа:
python3 run.py plot-exact
В проводнике WebIDE раскройте signup-experiment/output и откройте evidence.png. Найдите распределение вокруг нуля и наблюдаемую отметку около +66.67. Одновременно прочитайте output/analysis.json через программу просмотра: 12 людей, два знаменателя назначенных групп, исходная разность, точное p, альфа и метка inconclusive вместе составляют свидетельства. Один график не доказывает правильность анализа.
Эталон ниже — фактически сохранённый график этих учебных данных и предоставленного кода. Точки включают редкие количества на обоих хвостах; линия соединяет только достижимые разности. Читайте его рядом с сохранённым числовым результатом.
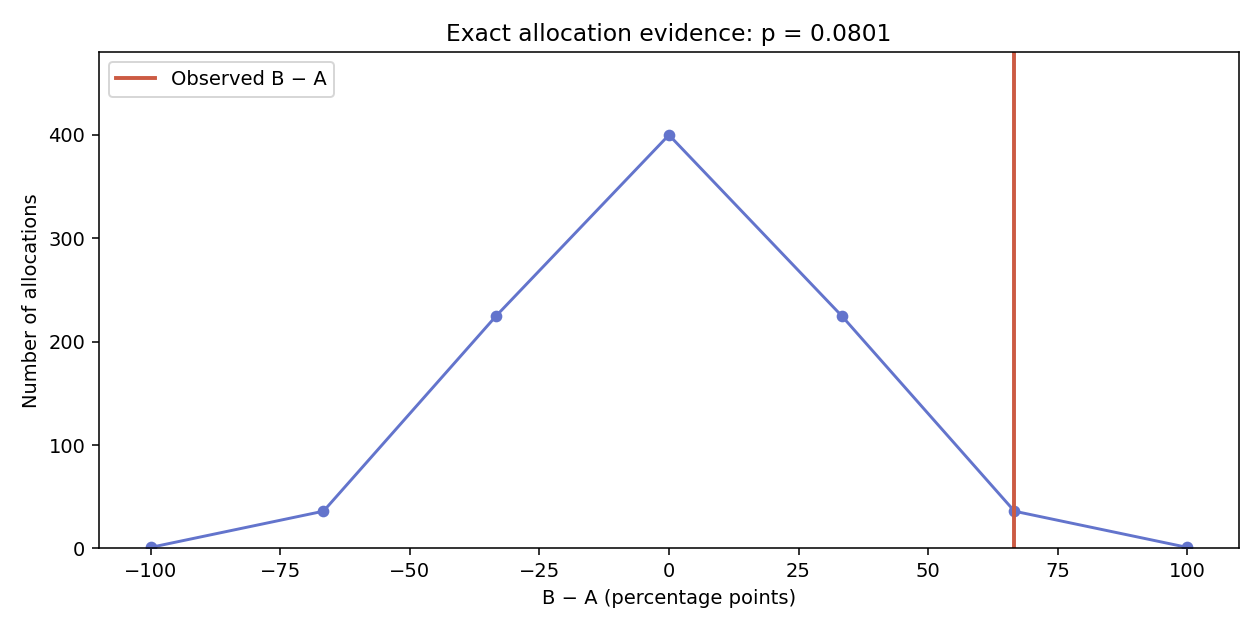
Допустимы читаемые столбцы, линия количеств или точки при фактических значениях разности. Наблюдаемому сравнению нужна видимая линия или точка с подписью Observed, обеим осям — содержательные подписи. Сохраните видимость всех возможных значений, наблюдаемой отметки и нулевой базы. PNG должен декодироваться и воспроизводиться из фактических сохранённых данных и текущей функции графика; невидимые штрихи, отметки вне осей, обрезанные графики и посторонние изображения не проходят. Если PNG отсутствует, сначала подтвердите сохранённый точный результат через python3 show_results.py exact, затем повторите команду графика; программа просмотра его не исправит.
Вы проанализировали одну синтетическую выборку рандомизированного эксперимента при одном заявленном предположении и соглашении. Вы не измерили реальный бизнес-результат, не доказали идентичность страниц и не установили сохранение наблюдаемого эффекта в рабочей системе.
Резюме
Вы перебрали ограниченное точное распределение, использовали двустороннее p-значение с включающими равенство хвостами, применили заранее выбранный порог без округления и сохранили настоящий график. Большая разность может остаться неубедительной при малой выборке; неубедительный результат не доказывает равенство страниц. Независимое задание теперь переносит тот же процесс на другое распределение и историю событий.