Введение
Редактору Commonlight нужен пригодный для работы фотокаталог, начиная с небольшого образца одной страницы. Вы отправите реальные HTTP-запросы, получите JSON, отберёте записи по полям и сохраните CSV. Commonlight — оригинальный локальный демонстрационный API: записи и имена авторов вымышлены, а примеры изображений являются синтетическими иллюстрациями, а не документальными фотографиями или содержимым внешнего фотосервиса.
Нужно знать функции Python, коллекции (например, списки и словари), циклы, исключения и основы вывода в файлы. HTTP, URL, JSON и CSV объясняются здесь. В WebIDE выберите Terminal → New Terminal (на узком экране меню Terminal может находиться внутри More). Все команды терминала выполняются там. Подготовленный сайт открывается через Web 8080. Меняйте только client.py и storage.py; используйте стандартную библиотеку и вспомогательные функции внутри этих файлов, без дополнительных модулей и ресурсов. CSV должен быть настоящим обычным файлом в рабочем каталоге, не символической ссылкой; оставьте catalog.py и /opt/commonlight без изменений. 40 минут на чтение и практику — оценка автора, а не время, измеренное на новичках.
Запрос и разбор одной страницы каталога
На этом шаге сопоставьте три записи API с тремя видимыми карточками, а затем реализуйте функцию запроса. Переключитесь на Web 8080. В предварительном просмотре Harbor walks есть Morning, market, Blue hour и Window light. Явно указано, что это одна страница, не вся коллекция. Иллюстрации дают контекст; курс посвящён экспорту метаданных, а не скачиванию изображений.
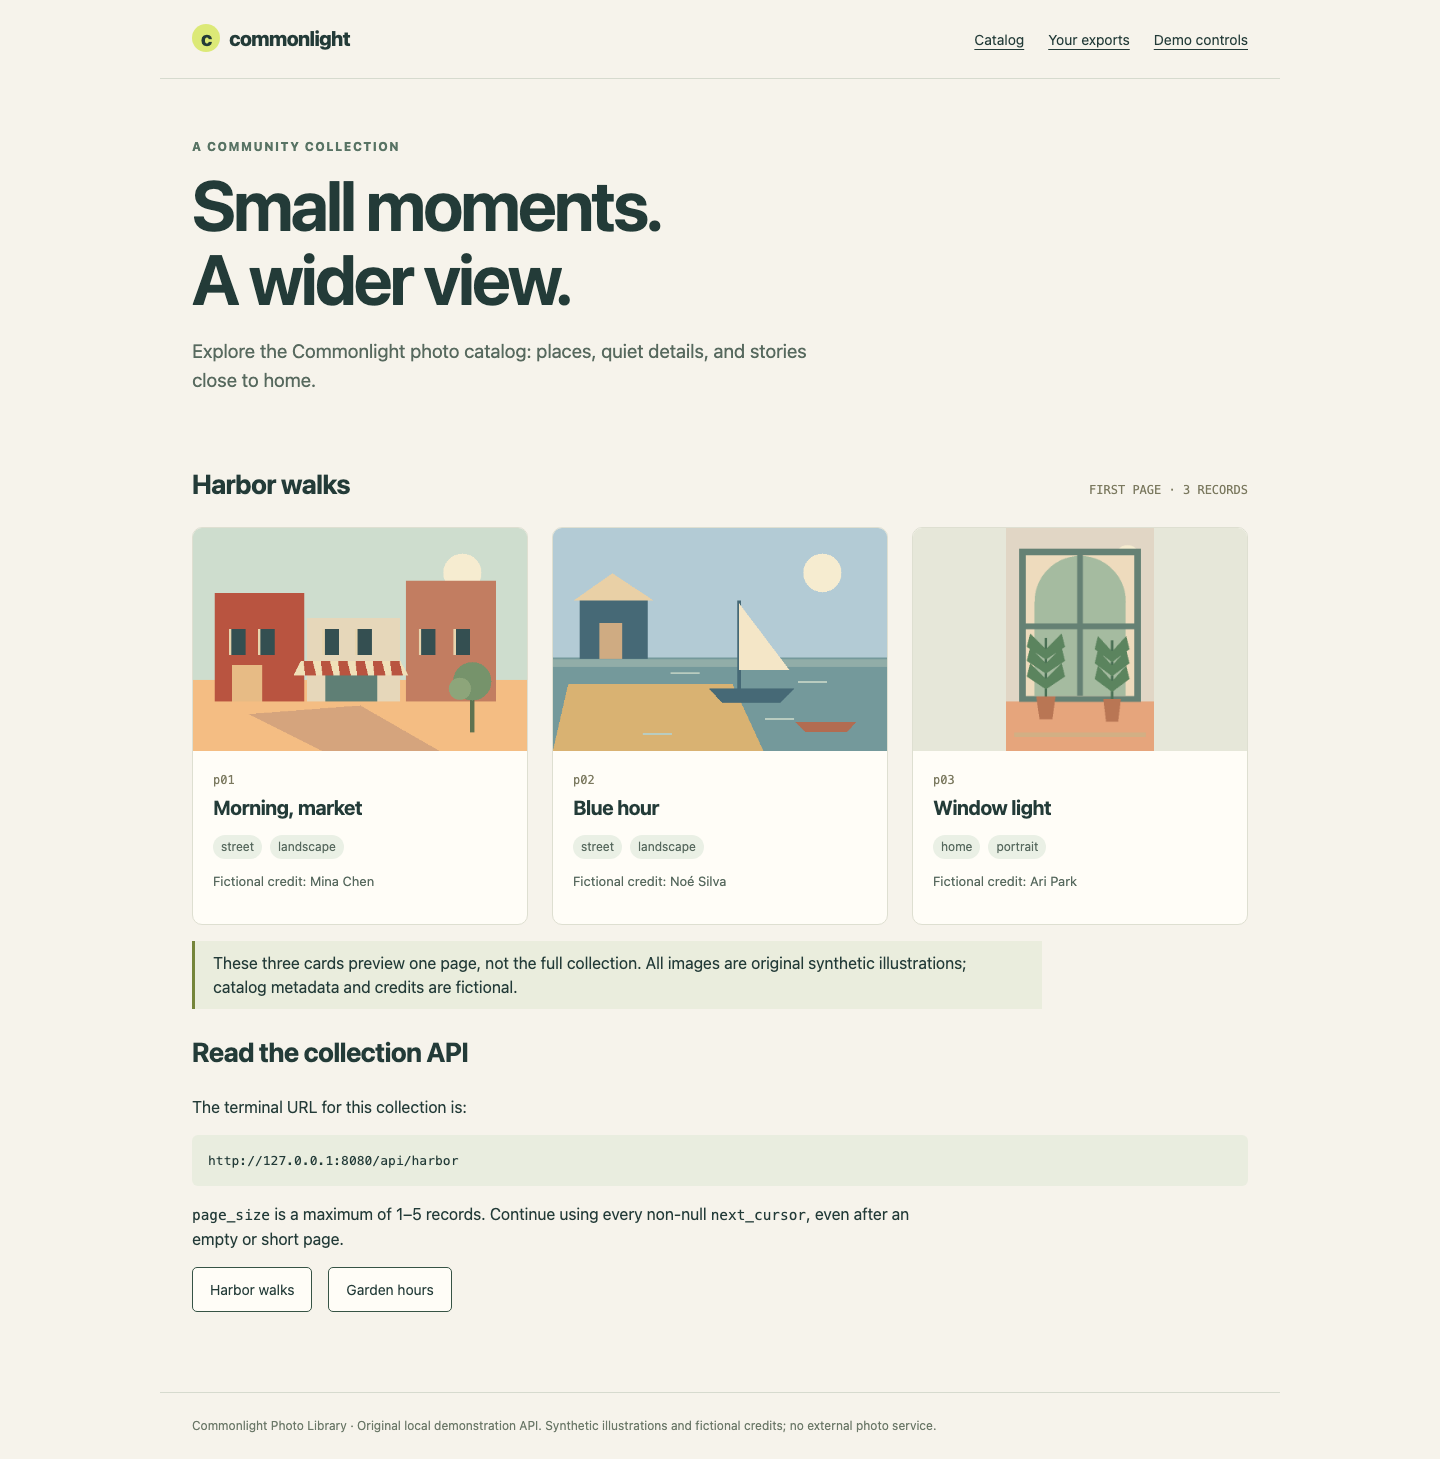
Сопоставьте ID под иллюстрациями с ответом, который сейчас запросите.
Вернитесь в WebIDE и его терминал. cd меняет рабочий каталог, а python3 запускает Python. Используйте именно этот путь:
cd /home/labex/project
HTTP — протокол запросов и ответов этого локального API. URL задаёт адрес: http — протокол, 127.0.0.1 — само текущее окружение, 8080 — порт сервиса, а /api/harbor выбирает коллекцию. После ? параметр page_size=3 запрашивает не более трёх записей. Этот адрес предназначен для терминала; Web 8080 открывает браузерный адрес того же сервиса, предоставленный платформой.
Следующий here-document запускает небольшую программу Python. <<'PY' передаёт буквальные строки до завершающего PY на стандартный ввод Python; копируйте обе строки-разделителя. urlopen отправляет настоящий HTTP-запрос. timeout=3 ограничивает блокирующие операции, например соединение или ожидание сокета, но не длительность любого задания целиком. with затем закрывает ответ. JSON — структурированный текст; json.load декодирует ответ в данные Python.
python3 - <<'PY'
import json
from urllib.request import urlopen
with urlopen('http://127.0.0.1:8080/api/harbor?page_size=3', timeout=3) as response:
    print('HTTP status:', response.status)
    page = json.load(response)
for photo in page['items']:
    print(photo['photo_id'], photo['title'])
print('More pages:', page['next_cursor'] is not None)
PY
HTTP status: 200
p01 Morning, market
p02 Blue hour
p03 Window light
More pages: True
Статус 200 означает успешный запрос. Внешний объект JSON превращается в словарь. Значение items — список словарей записей, а не весь ответ. JSON-значение null становится Python-значением None. Здесь next_cursor всё ещё строка, поэтому есть другие страницы. Этот модуль намеренно экспортирует одну страницу; следующий завершит полный обход.
У каждой записи есть photo_id, title, category, orientation и credit. Стабильный ID определяет запись; заголовок — лишь отображаемая подпись, которая может совпадать у разных фото. Подготовленный контракт доступен в /opt/commonlight/api-contract.md. cat показывает текстовый файл:
cat /opt/commonlight/api-contract.md
Добавьте повторно используемые функции запроса и отбора. urlencode кодирует словарь в строку запроса. Курсор — непрозрачный токен продолжения: копируйте его точно, не угадывая число и не интерпретируя символы. Необязательный аргумент cursor=None означает, что в первом запросе этот параметр отсутствует. На следующих страницах могут встречаться символы +, / и =, требующие кодирования. Во время одного обхода не меняйте URL и размер страницы.
Отбор точно сравнивает категорию и ориентацию с учётом регистра. Если совпадений нет, пустой список корректен. В списковом включении for photo in photos перебирает записи, if оставляет только подходящие, а and требует истинности обоих сравнений. Получается новый список без изменения принятых записей.
Следующий блок использует cat и >, чтобы заменить client.py буквальным текстом Python. Выполните весь блок, включая последний PY. Также можно открыть файл в WebIDE, заменить содержимое и сохранить через Ctrl+S (Cmd+S в macOS). Этот блок меняет только данный файл.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    return request_page(endpoint, page_size)['items']
PY
Подготовленный интерфейс команды вызывает эти функции. Пока collect явно остаётся начальной реализацией для одной страницы. Самопроверка обращается к другому настоящему локальному HTTP-источнику, поэтому функция должна использовать переданный URL, а не фиксированный ответ каталога. Проверка не создаёт ваш CSV за вас.
Если команда не может открыть файл Python, покажите текущий каталог через pwd, имена файлов через ls, вернитесь в /home/labex/project с помощью показанного cd, исправьте имя и повторите. Сбрасывать VM не нужно.
Отбор страницы и сохранение настоящего CSV
На этом шаге выберите горизонтальные уличные снимки первой страницы и откройте CSV с их настоящими значениями полей. CSV означает значения, разделённые запятыми, но запятая внутри названия принадлежит одному полю. Правильный CSV-писатель заключает его в кавычки; простая склейка строк или разбиение по каждой запятой нарушает эту связь. UTF-8 сохраняет имена вроде Noé и нелатинские символы. newline='' позволяет модулю csv управлять окончаниями строк CSV.
FIELDS задаёт пять имён столбцов. Каждое встречается один раз; эквивалентное решение может менять порядок записей и столбцов. DictWriter сопоставляет значение словаря с именованным столбцом. writeheader записывает заголовок, а writerows — выбранные записи; при пустом отборе получается файл только с заголовком. Режим открытия w заменяет содержимое файла. В этом модуле сохраняется образец страницы; безопасная публикация полного многостраничного экспорта рассматривается далее.
В терминале WebIDE замените только storage.py:
cat > storage.py <<'PY'
"""Single-page CSV writer; safe publication is taught in the second guided lab."""
import csv

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    with open(output, 'w', encoding='utf-8', newline='') as stream:
        writer = csv.DictWriter(stream, fieldnames=FIELDS)
        writer.writeheader()
        writer.writerows(photos)
PY
Подготовленный catalog.py принимает пять позиционных аргументов: URL коллекции, категорию, ориентацию, максимальный размер страницы и имя выходного файла. --first-page явно включает режим образца. street и landscape — два точных фильтра. Кавычки оболочки сохраняют URL или имя со специальными символами как единый аргумент.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Saved 2 photos to page.csv
Прочитайте результат с помощью DictReader, который восстанавливает поля в кавычках. Читается настоящий сохранённый файл, не API:
python3 - <<'PY'
import csv
with open('page.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'], '|', photo['credit'])
PY
p01 | Morning, market | Mina Chen
p02 | Blue hour | Noé Silva
p03 отсутствует, потому что это вертикальный снимок категории home. Запятая в первом названии и акцент в имени автора остаются связанными со своими записями.
Теперь наблюдайте намеренный HTTP-отказ. API допускает размеры страниц 1–5, поэтому 9 возвращает 400, а не успешно полученную пустую коллекцию. Выполните блок; первая команда должна завершиться ошибкой. $? содержит статус выхода непосредственно предшествующей команды, а printf показывает его до замены другим статусом.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 9 rejected.csv --first-page
printf 'Exit status: %s\n' "$?"
HTTP request refused: 400. No complete export published.
Exit status: 1
HTTPError обозначает этот HTTP-отказ; сбой соединения отдельно сообщается как Connection failed. Ни один из них не является допустимым результатом без совпадений. Подготовленная команда перехватывает исключение, объясняет его и завершается с ненулевым кодом. Для восстановления вернитесь к разрешённому размеру, не меняя сервис:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Переключитесь на Web 8080, выберите Your exports, затем page.csv. Таблица должна показать две настоящие записи выше. Выберите Download CSV и откройте скачанный файл как текст или в CSV-ридере. Скачиваются байты сохранённого файла; страница не получает недостающие записи из источника. Через навигацию страницы вернитесь к Catalog, затем в WebIDE для самопроверки. Вы сделали повторно используемый образец одной страницы, но токен продолжения, отличный от null, всё ещё показывает, что это не весь каталог.
Резюме
Вы отправили настоящие HTTP-запросы, отделили оболочку JSON-страницы от записей, отобрали точные значения полей и записали UTF-8 CSV с правильными кавычками. HTTP-отказ, сбой соединения и корректный пустой результат имеют разный смысл. Образец из двух записей уже полезен; следующий модуль пройдёт оставшиеся курсоры и завершит экспорт.