Введение
Просмотр трёх карточек удобен для знакомства, но редактору нужны все подходящие записи. Дополните клиент того же локального демонстрационного API: следуйте токенам продолжения, сохраняйте идентичность между страницами и публикуйте CSV только после успеха всего пакета. Даже после пустой или короткой страницы могут быть следующие.
Этот модуль инициализируется независимо с функциями запроса и отбора из первого пошагового лабораторного занятия. Оно или эквивалентные знания HTTP/JSON/CSV обязательны. В WebIDE используйте Terminal → New Terminal, а Web 8080 — для источника, сохранённых экспортов и общедоступных Demo controls. Меняйте только client.py и storage.py; используйте стандартную библиотеку и внутренние вспомогательные функции, не дополнительные модули или ресурсы. CSV должен быть настоящим обычным файлом рабочей области, не символической ссылкой. Сохраните catalog.py, /opt/commonlight, синтетические иллюстрации и вымышленные исходные записи. Автор оценивает чтение и практику в 55 минут; это не измеренная длительность для новичков.
Следование протоколу до завершения
На этом шаге соберите все страницы, включая пустую и короткую страницу данных, сохраняя каждый ID один раз. В терминале WebIDE перейдите в независимо подготовленную рабочую область:
cd /home/labex/project
Функция запроса уже обрабатывает JSON, кодированные курсоры и трёхсекундный тайм-аут блокирующих операций. Посмотрите подготовленные правила через cat:
cat client.py
Текущий collect возвращает лишь одну страницу. page_size, равный 3, означает не более трёх записей, а не обязательные три на каждой странице. Предскажите небольшую последовательность: три записи, затем ни одной, но с другим курсором, затем одна запись с ещё одним курсором. Пустая страница ничего не добавляет, но не доказывает завершение. Выполните последовательность только с возвращёнными курсорами:
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
Только next_cursor is None успешно завершает пакет. Не останавливайтесь из-за пустого items, короткой страницы или достижения предполагаемого количества страниц.
Один ID фото может повторяться на разных страницах с одинаковыми значениями. Словарь с ключом photo_id сохраняет связь идентичности со всеми полями. setdefault(key, value) вставляет значение только при отсутствии ключа. Так остаётся одна копия; повторённый заголовок не означает повторённый ID. Противоречащие версии не входят в контракт демонстрации. Оба разных ID с названием Blue hour должны сохраниться.
Множество хранит уникальные значения. set() создаёт пустое множество, cursor in seen_cursors проверяет наличие токена, а seen_cursors.add(cursor) запоминает новый. Это множество хранит встреченные токены продолжения. Сначала проверьте корректное завершение null, затем отклоните повтор токена, не зацикливаясь и не принимая цикл за конец. raise ValueError останавливает сбор до сохранения неполного результата. Нормальные подготовленные каталоги конечны; фиксированного лимита страниц, автоматических повторов и возобновления нет.
Замените client.py следующим полным модулем. Как и раньше, > заменяет файл, а here-document с кавычками сохраняет буквальное содержимое. Запрос и фильтр не изменились; новая часть — collect.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
Запустите полный сбор. Не указывайте --first-page: этот флаг намеренно создаёт только образец.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
Проверьте сохранённые идентификаторы, а не просто количество:
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
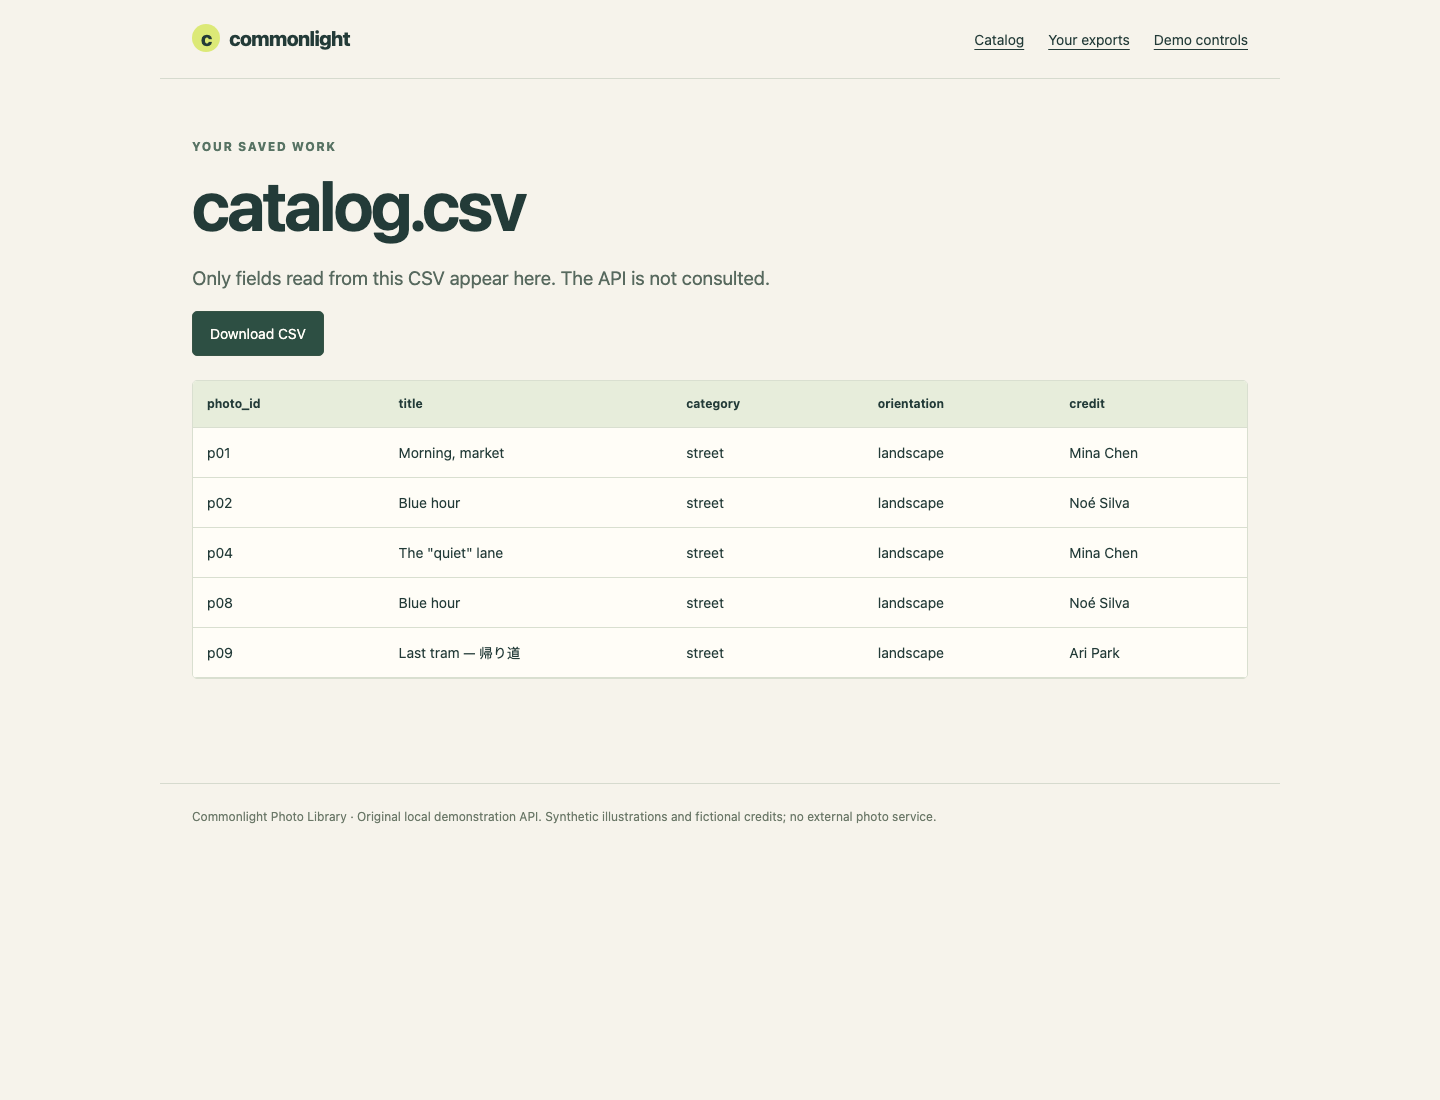
Запись последней страницы p09 присутствует, p02 встречается один раз, а p08 сохраняет тот же заголовок с другим ID. Проверьте те же значения в Web 8080 → Your exports → catalog.csv. Эта таблица читает только ваш CSV; неполный файл останется здесь неполным. Вернитесь в WebIDE для самопроверки. При неправильном имени или каталоге восстановитесь с помощью pwd, ls и показанного cd, затем повторите.
Публикация только полного экспорта
На этом шаге защитите последний успешный экспорт при сбое следующего запроса, цикле протокола или ошибке записи. Сбор уже заканчивается до сохранения. Записывающему коду тоже нужна граница полного успеха: открытие конечного пути с w может обрезать хороший файл раньше, чем завершится новая запись.
Path(output) превращает переданное имя в объект пути. .parent — содержащий его каталог, а .name — конечное имя файла. NamedTemporaryFile создаёт новое уникальное имя, не присваивая предсказуемый соседний файл вроде catalog.csv.tmp. dir=output.parent помещает его в целевой каталог, чтобы замена оставалась в одной файловой системе. delete=False сохраняет закрытый файл для замены; stream.name даёт выделенное имя, которое запоминается как Path. Блок finally выполняется и после успеха, и при исключении. exists() проверяет, остался ли временный путь, а unlink() удаляет только этот вновь созданный файл, если он ещё существует. После успешной замены временный путь исчезает, поэтому удалять нечего. Исключение продолжает передаваться интерфейсу команды и вызывает ненулевой выход. Path.replace публикует готовый файл после того, как блок with закроет его. Успешная замена POSIX атомарна, но это не обещание сохранности при отключении питания, транзакции нескольких файлов или согласования параллельных писателей. Существующий посторонний .tmp никогда нельзя перезаписывать или удалять.
В терминале WebIDE замените storage.py. Каждое из пяти полей CSV должно присутствовать в заголовке ровно один раз; эквивалентные реализации могут использовать другой допустимый способ кавычек и иной порядок строк или столбцов.
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
Перед имитацией проблем выполните один нормальный пакет. sha256sum выводит отпечаток содержимого и имя файла. Запомните отпечаток или оставьте вывод видимым: следующий неуспешный пакет должен сохранить его. Ошибка записи тоже должна оставить последний полный файл целым; проверка испытывает это изолированно, не меняя рабочую область.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
Переключитесь на Web 8080. Выберите Demo controls, затем Enable middle-page failure. Убедитесь, что показано Middle-page failure ON.
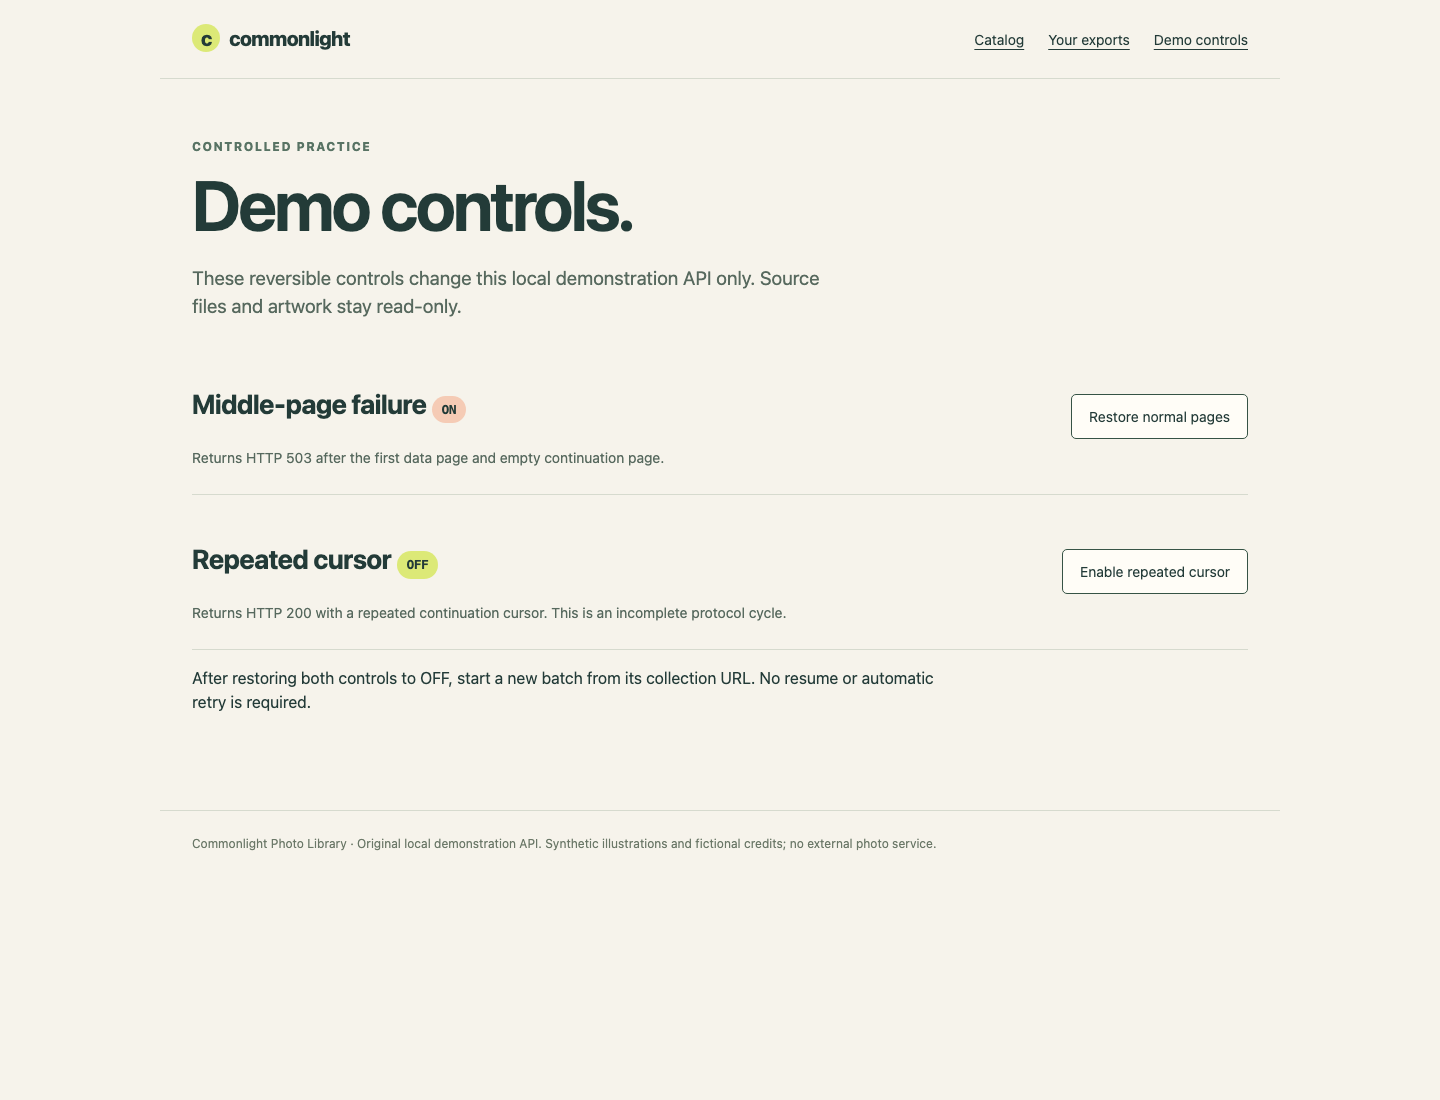
Используйте карточку именно того сбоя, который включили. Это явно разрешённое обратимое изменение только памяти демонстрационного API; исходные файлы остаются доступными только для чтения. Вернитесь в WebIDE и запустите намеренный отказ. printf немедленно фиксирует $?:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
HTTP 503 здесь означает отказ демонстрационного API на запрос промежуточной страницы. Это не сбой соединения и не успешно полученный пустой результат. Отпечаток должен совпасть с предыдущим, а старый экспорт из пяти строк — оставаться доступным. Одного ненулевого кода недостаточно, если программа уже испортила файл.
В Web 8080 → Demo controls выберите Restore normal pages для сбоя промежуточной страницы и подтвердите OFF. Вернитесь в WebIDE и начните новый конечный пакет с URL коллекции; старый курсор не используйте:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Далее откройте Web 8080 → Demo controls и выберите Enable repeated cursor. Убедитесь, что показано Repeated cursor ON, а контроль сбоя имеет состояние OFF. Вернитесь в WebIDE:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
У этих ответов HTTP 200, но повторный курсор — ошибка протокола, а не завершение. Защита множеством предотвращает бесконечный цикл и публикацию. В Web 8080 → Demo controls выберите Restore normal pages внутри карточки Repeated cursor и подтвердите OFF; оба переключателя теперь должны быть OFF. Вернитесь в WebIDE, повторите успешную команду, а затем проверьте допустимый фильтр без совпадений с новым именем выхода:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
Второй результат успешен и содержит лишь заголовок; это не то же самое, что две предыдущие ошибки. В Web 8080 → Your exports откройте empty.csv с пятью заголовками без строк данных, затем catalog.csv и выберите Download CSV. Настоящий сохранённый файл из пяти записей — ваш результат. Вернитесь в WebIDE для самопроверки. Сохраните программу и подготовленные источники: проверка читает настоящий результат и запускает неизменённые копии в изолированных реальных HTTP-тестах с другими URL, фильтрами, размерами и ошибками записи.
Резюме
Вы прошли непрозрачные токены продолжения до явного окончания null, сохранили разные ID при одинаковых заголовках и отклонили цикл протокола. Полный UTF-8 CSV опубликован через уникальный временный файл, а предыдущий хороший результат защищён от ошибок. Та же программа принимает другую переданную коллекцию и выборку.